SEO técnico
INP: qué mide realmente y cómo bajarlo sin trucos
Publicado el
En esta página
- Respuesta breve
- Puntos clave
- Qué mide INP exactamente
- Las tres fases de una interacción
- Por qué el laboratorio no ve INP
- De dónde salen los milisegundos
- Romper las tareas largas
- Terceros y etiquetas
- El coste del render posterior
- Medir el cambio sin engañarse
- En cuatro láminas
- Errores frecuentes
- Preguntas habituales
- Próximo paso
- Fuentes
Respuesta breve
INP mide cuánto tarda una página en responder visiblemente a las interacciones del usuario durante toda su vida, no solo la primera. Toma clics, toques y pulsaciones de teclado, mide el tiempo desde la acción hasta que el navegador pinta la respuesta y reporta la peor interacción representativa. El umbral de Core Web Vitals es 200 ms en el percentil 75 del campo. Bajarlo consiste en reducir el trabajo del hilo principal durante la interacción, no en adelantar la carga.
Puntos clave
- INP sustituyó a FID como métrica de Core Web Vitals en marzo de 2024, según la documentación de web.dev.
- Cuenta clic, toque y teclado; el desplazamiento y el hover quedan fuera.
- Se descompone en retardo de entrada, tiempo de procesamiento y retardo de presentación.
- Es una métrica de campo: una prueba de laboratorio sin interacción no puede darte un INP real.
- El enemigo habitual son las tareas largas del hilo principal, no el peso total de la página.
- Un cambio que mejora LCP puede no mover INP en absoluto: son cuellos distintos.
Las tres fases de una interacción
- Retardo de entradaDesde la pulsación hasta que el manejador puede ejecutarse: otro script ocupa el hilo.
- Tiempo de procesamientoLo que tarda el manejador propio: las tareas largas.
- Retardo de presentaciónHasta que el navegador pinta el siguiente fotograma: el coste del render posterior.
Índice
- Qué mide INP exactamente
- Las tres fases de una interacción
- Por qué el laboratorio no ve INP
- De dónde salen los milisegundos
- Romper las tareas largas
- Terceros y etiquetas
- El coste del render posterior
- Medir el cambio sin engañarse
- Errores frecuentes
- Próximo paso
Qué mide INP exactamente
INP —Interaction to Next Paint— observa todas las interacciones cualificadas que ocurren en una página y reporta una que representa el peor comportamiento. En páginas con muchas interacciones se descartan los valores atípicos, de modo que un único clic desafortunado no define la métrica.
Tres precisiones que cambian el diagnóstico:
- No es la primera interacción. FID medía solo el retardo de entrada del primer contacto. INP cubre toda la sesión en esa página, incluido lo que ocurre cinco minutos después de cargar.
- No mide el resultado, mide la respuesta. El reloj se detiene en la siguiente pintura del navegador, no cuando termina la operación completa. Un formulario que muestra un indicador de carga inmediato y resuelve en dos segundos puede tener buen INP.
- El desplazamiento no cuenta. Tampoco pasar el ratón por encima. Si tu problema percibido es un scroll a tirones, INP no lo va a reflejar; ese es otro trabajo.
Los umbrales vigentes de Core Web Vitals son LCP 2,5 s, INP 200 ms y CLS 0,1, todos evaluados en el percentil 75 de las visitas. El percentil 75 importa: no basta con que la mediana esté bien, porque una cuarta parte de tus usuarios está peor que ese valor.
El percentil 75 importa: no basta con que la mediana esté bien, porque una cuarta parte de tus usuarios está peor que ese valor.
Las tres fases de una interacción
Cualquier interacción se descompone en tres tramos, y cada uno se corrige de forma distinta. Saber cuál domina evita optimizar el tramo equivocado.
| Fase | Qué ocurre | Causa habitual |
|---|---|---|
| Retardo de entrada | El navegador no puede atender el evento todavía | Una tarea larga ya en curso bloquea el hilo principal |
| Procesamiento | Se ejecutan los manejadores de evento | Lógica pesada, listeners acumulados, trabajo síncrono |
| Retardo de presentación | Se calcula estilo, maquetación y pintura | Cambios de DOM amplios, CSS costoso, recálculo forzado |
Un caso frecuente en instalaciones cargadas de scripts: el retardo de entrada se lleva la mayor parte porque el usuario hace clic mientras se está ejecutando el arranque de un gestor de etiquetas. El manejador propio es trivial, pero llega tarde. Optimizar ese manejador no cambia nada; hay que quitar de en medio la tarea que bloquea.
Por qué el laboratorio no ve INP
Una auditoría sintética carga la página y no toca nada. Sin interacción no hay INP. Por eso las herramientas de laboratorio ofrecen métricas aproximadas —tiempo total de bloqueo, tareas largas— que correlacionan con el problema pero no son la métrica.
Las fuentes utilizables, por orden de fiabilidad para tomar decisiones:
- Datos de campo de tus propios usuarios, recogidos con la librería
web-vitalsy enviados a tu analítica. Son los únicos que atribuyen el problema a una interacción y un elemento concretos. - Informe de experiencia de usuario de Chrome, agregado y con retardo de semanas. Sirve para saber si tienes un problema y para confirmar tendencia; no para depurar.
- Perfilado manual en el navegador reproduciendo la interacción sospechosa con limitación de CPU. Es el laboratorio útil: no da INP, da la causa.
El orden de trabajo se deduce solo: el campo dice qué páginas e interacciones duelen, el perfilado dice por qué, y el campo vuelve a decir si el cambio funcionó. Saltarse el primer paso lleva a optimizar la página que más te preocupa a ti en lugar de la que más usan.
De dónde salen los milisegundos
Una tarea del hilo principal que supera los 50 ms se considera tarea larga. Mientras se ejecuta, el navegador no puede atender nada más: ni el clic, ni el repintado. Los orígenes habituales en una web real:
- Arranque e inicialización de scripts de terceros justo después de la carga.
- Manejadores de evento que hacen consultas al DOM en bucle o recalculan geometría.
- Hidratación o inicialización de componentes que no son visibles todavía.
- Listeners duplicados por plugins que registran lo mismo varias veces.
- Trabajo síncrono en
inputokeyup: validaciones, filtros, búsqueda en vivo sin control de frecuencia. - Animaciones implementadas con propiedades que fuerzan maquetación en cada fotograma.
El peso de la página influye poco aquí. Un sitio de 300 KB con un manejador mal escrito puede tener peor INP que otro de 2 MB de imágenes bien servidas. Es una diferencia importante respecto al trabajo clásico de rendimiento, donde reducir bytes suele ayudar. El método general de medición y priorización de Core Web Vitals en WordPress sigue aplicando, pero el diagnóstico de INP se hace en el perfilador, no en la cascada de red.
Romper las tareas largas
La estrategia base es ceder el control al navegador con frecuencia para que pueda atender interacciones entre fragmentos de trabajo. En la práctica:
- Divide el trabajo largo en fragmentos y cede el hilo entre ellos, con
scheduler.yield()donde esté disponible y una alternativa basada en temporizador donde no lo esté. - Actualiza primero lo que el usuario debe ver y aplaza el resto: registrar la analítica del clic puede esperar a después de la pintura.
- Retrasa la inicialización de componentes hasta que sean necesarios o entren en el viewport.
- Aplica control de frecuencia a los eventos continuos de entrada en lugar de ejecutar en cada pulsación.
- Mueve el cálculo puro y pesado a un worker cuando no necesita el DOM.
Una advertencia sobre las soluciones de un clic: aplazar todo el JavaScript hasta la primera interacción del usuario mejora el arranque, pero concentra el trabajo justo en el momento que INP mide. En instalaciones donde ese ajuste está activo conviene comprobar el efecto real; el enfoque de mejorar INP sin llenar la web de plugins parte precisamente de esa comprobación.
Terceros y etiquetas
Los scripts de terceros son la fuente más común de tareas largas que no controlas y la más difícil de negociar, porque cada uno responde a un departamento distinto. El inventario es el primer entregable útil: qué carga, quién lo pidió, qué decisión sostiene y qué pasa si se retira.
Medidas por orden de coste creciente:
- Retirar lo que ya no responde a ninguna decisión activa. Es gratis y suele haber más de lo esperado.
- Cargar bajo consentimiento real en lugar de al inicio, cuando el marco legal lo exige de todos modos.
- Diferir hasta que el elemento asociado sea visible: mapas, vídeos incrustados, chats.
- Sustituir una incrustación pesada por una imagen que carga el widget al hacer clic.
- Consolidar herramientas que miden lo mismo.
Un contenedor de etiquetas concentra este problema y lo oculta: el HTML solo muestra una línea, y detrás hay veinte scripts. Auditar su contenido periódicamente es parte del mantenimiento, no un proyecto puntual.
El coste del render posterior
El retardo de presentación se olvida porque no aparece en el JavaScript. Ocurre cuando el manejador termina rápido pero el cambio que provoca obliga al navegador a recalcular media página.
Señales de que este tramo domina: abrir un menú desplegable con muchos elementos, expandir un acordeón que reordena el contenido, aplicar un filtro que redibuja una cuadrícula completa. Medidas útiles: limitar el alcance del cambio de DOM a lo estrictamente necesario, evitar leer geometría inmediatamente después de escribir en el DOM, usar content-visibility para que el navegador omita el trabajo de secciones fuera de pantalla, y animar con propiedades que no fuercen maquetación.
Cuidado con content-visibility en contenido que debe ser accesible o encontrable con la búsqueda del navegador: la ganancia de render no compensa romper la navegación por teclado o el lector de pantalla.
Medir el cambio sin engañarse
INP de campo se mueve despacio y depende de la mezcla de dispositivos y de la estacionalidad del tráfico. Eso genera dos errores simétricos: dar por buena una mejora que era ruido, y descartar un cambio correcto porque el dato agregado tardó semanas en reflejarlo.
- Registra la fecha exacta del despliegue y no agrupes varios cambios de rendimiento en uno solo.
- Segmenta por plantilla y por tipo de dispositivo antes de comparar; el móvil de gama media es donde vive el problema.
- Guarda, junto al valor, el selector del elemento responsable: sin él no sabrás si el cuello se ha movido o ha desaparecido.
- Verifica en el perfilador que la tarea larga concreta ya no aparece; esa confirmación es inmediata y no depende del agregado.
- Compara siempre en condiciones equivalentes: mezclar mediciones con caché fría y caliente invalida la comparación, como detalla el benchmark de caché fría y caliente.
En cuatro láminas
200 ms en el percentil 75. No basta con que la mediana esté bien: una cuarta parte de tus usuarios está peor que ese valor.
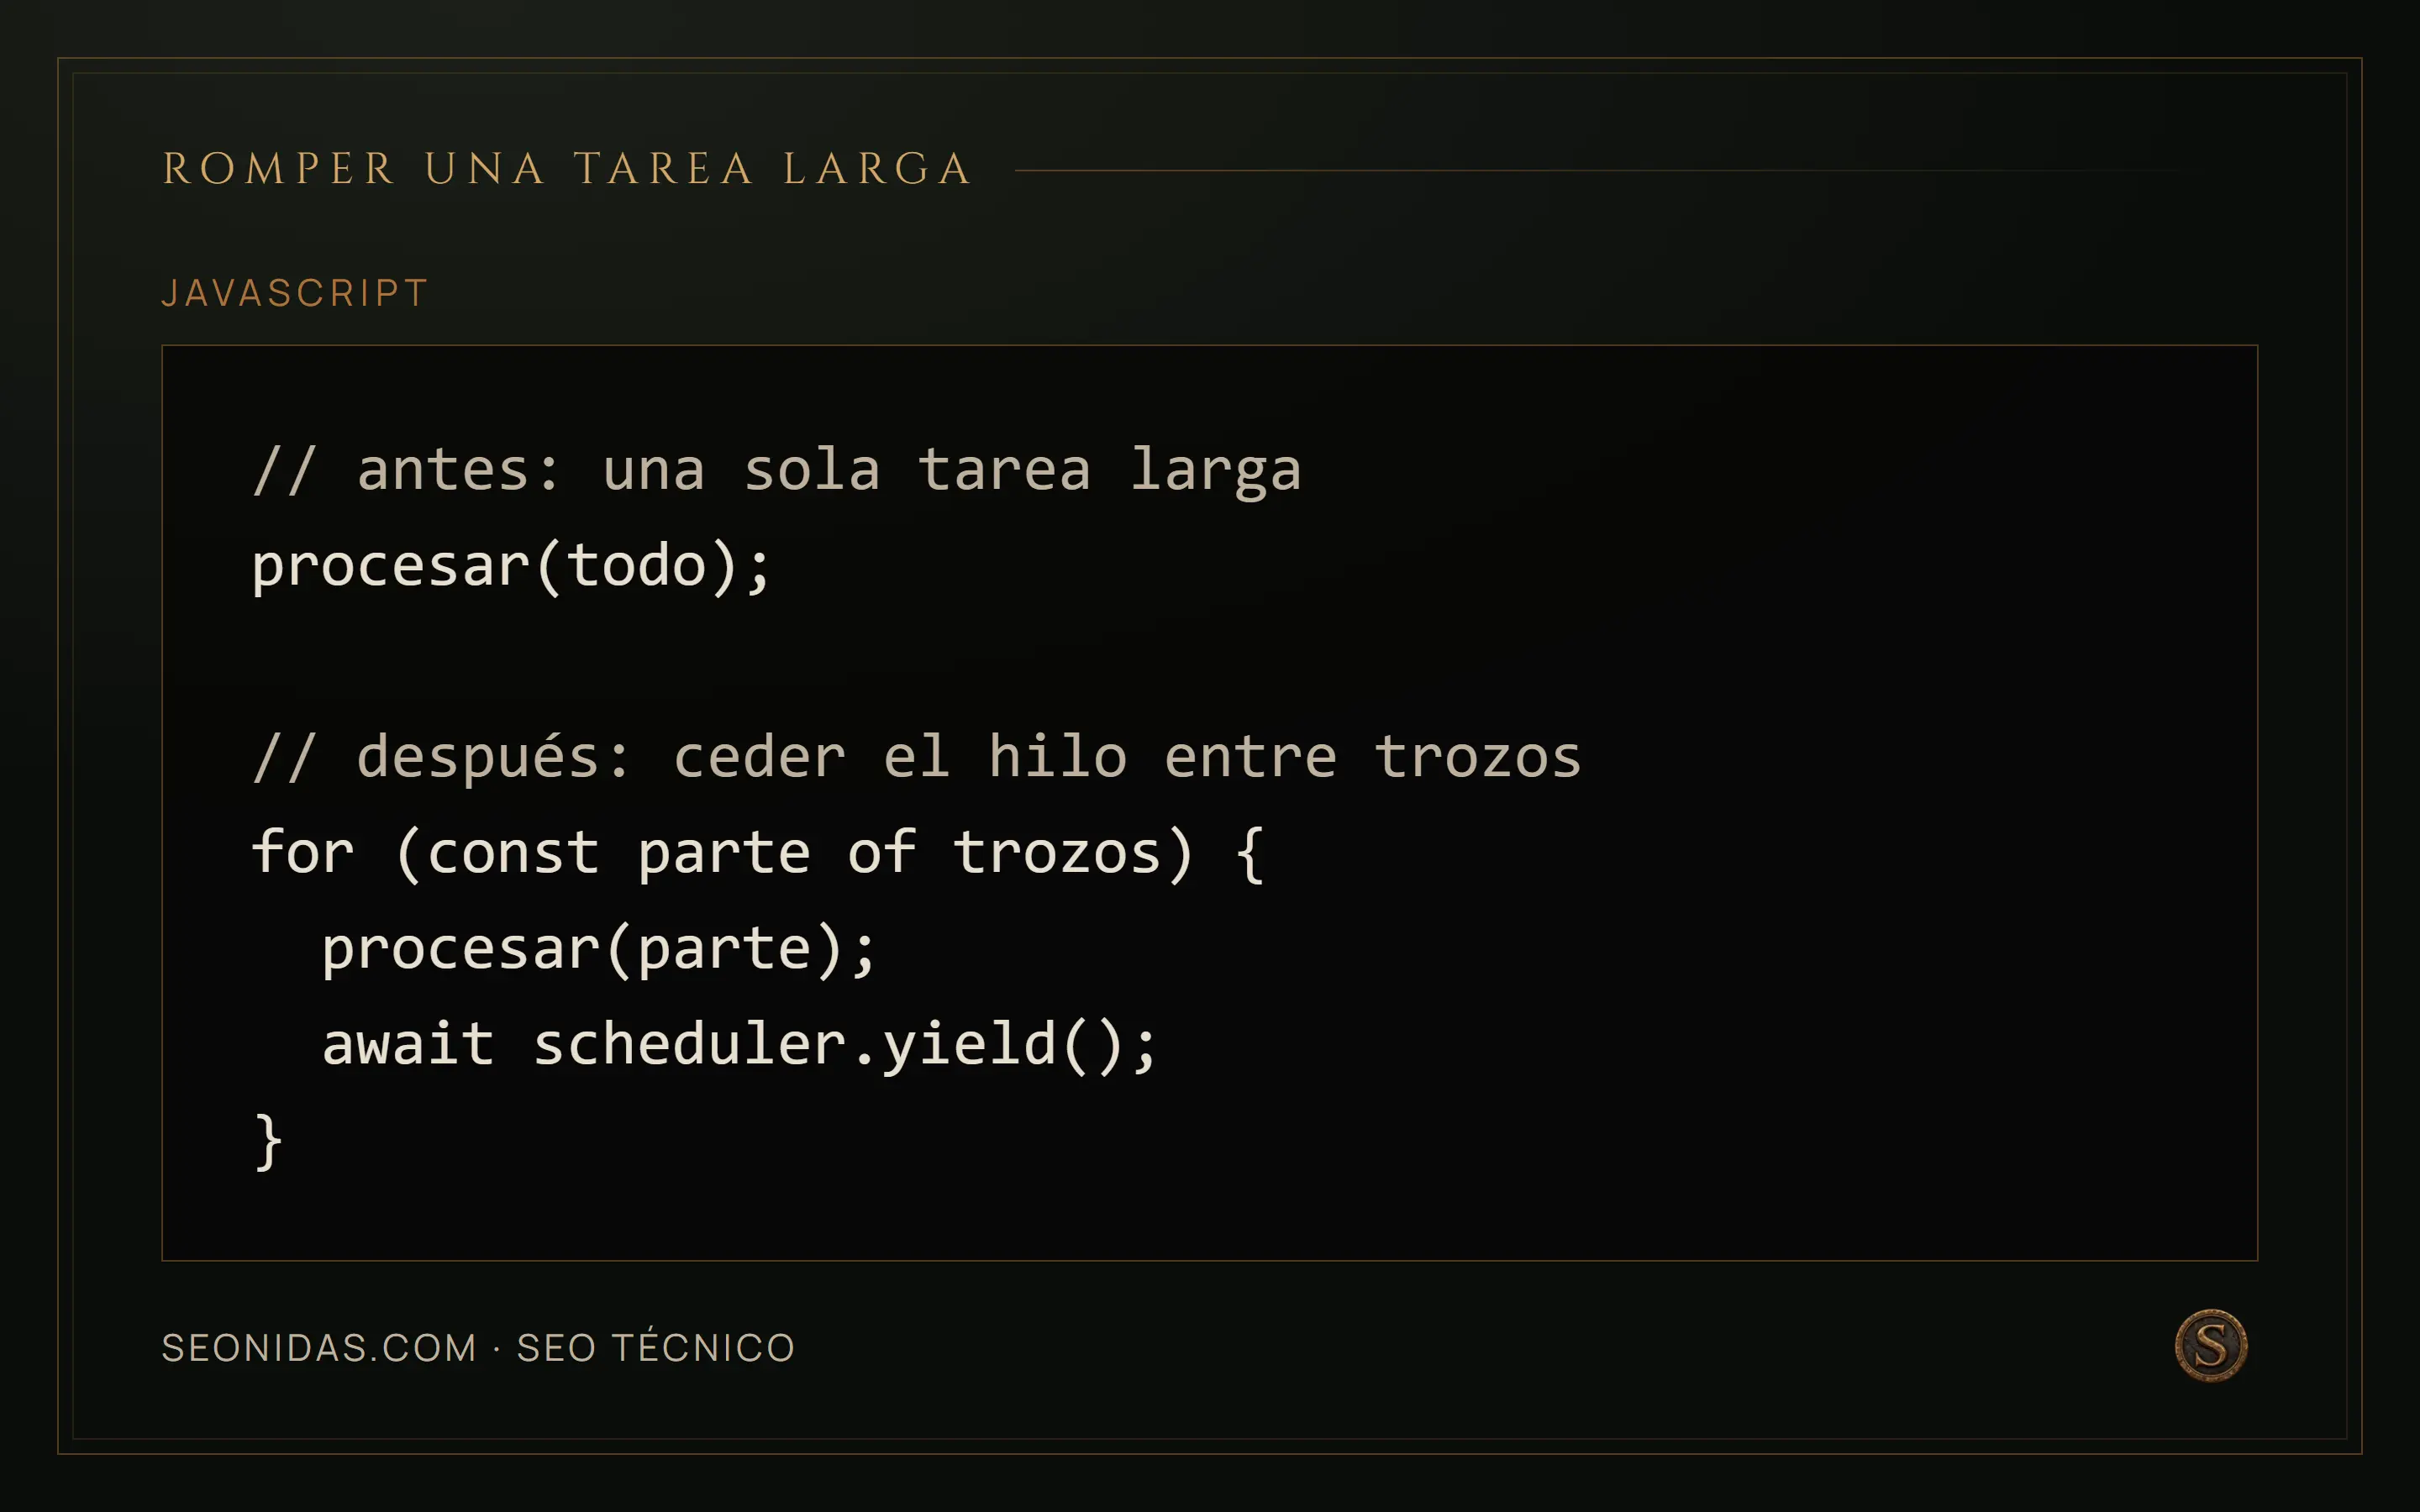
JavaScript: // antes: una sola tarea larga / procesar(todo); / / // después: ceder el hilo entre trozos / for (const parte of trozos) { / procesar(parte); / await scheduler.yield(); / }
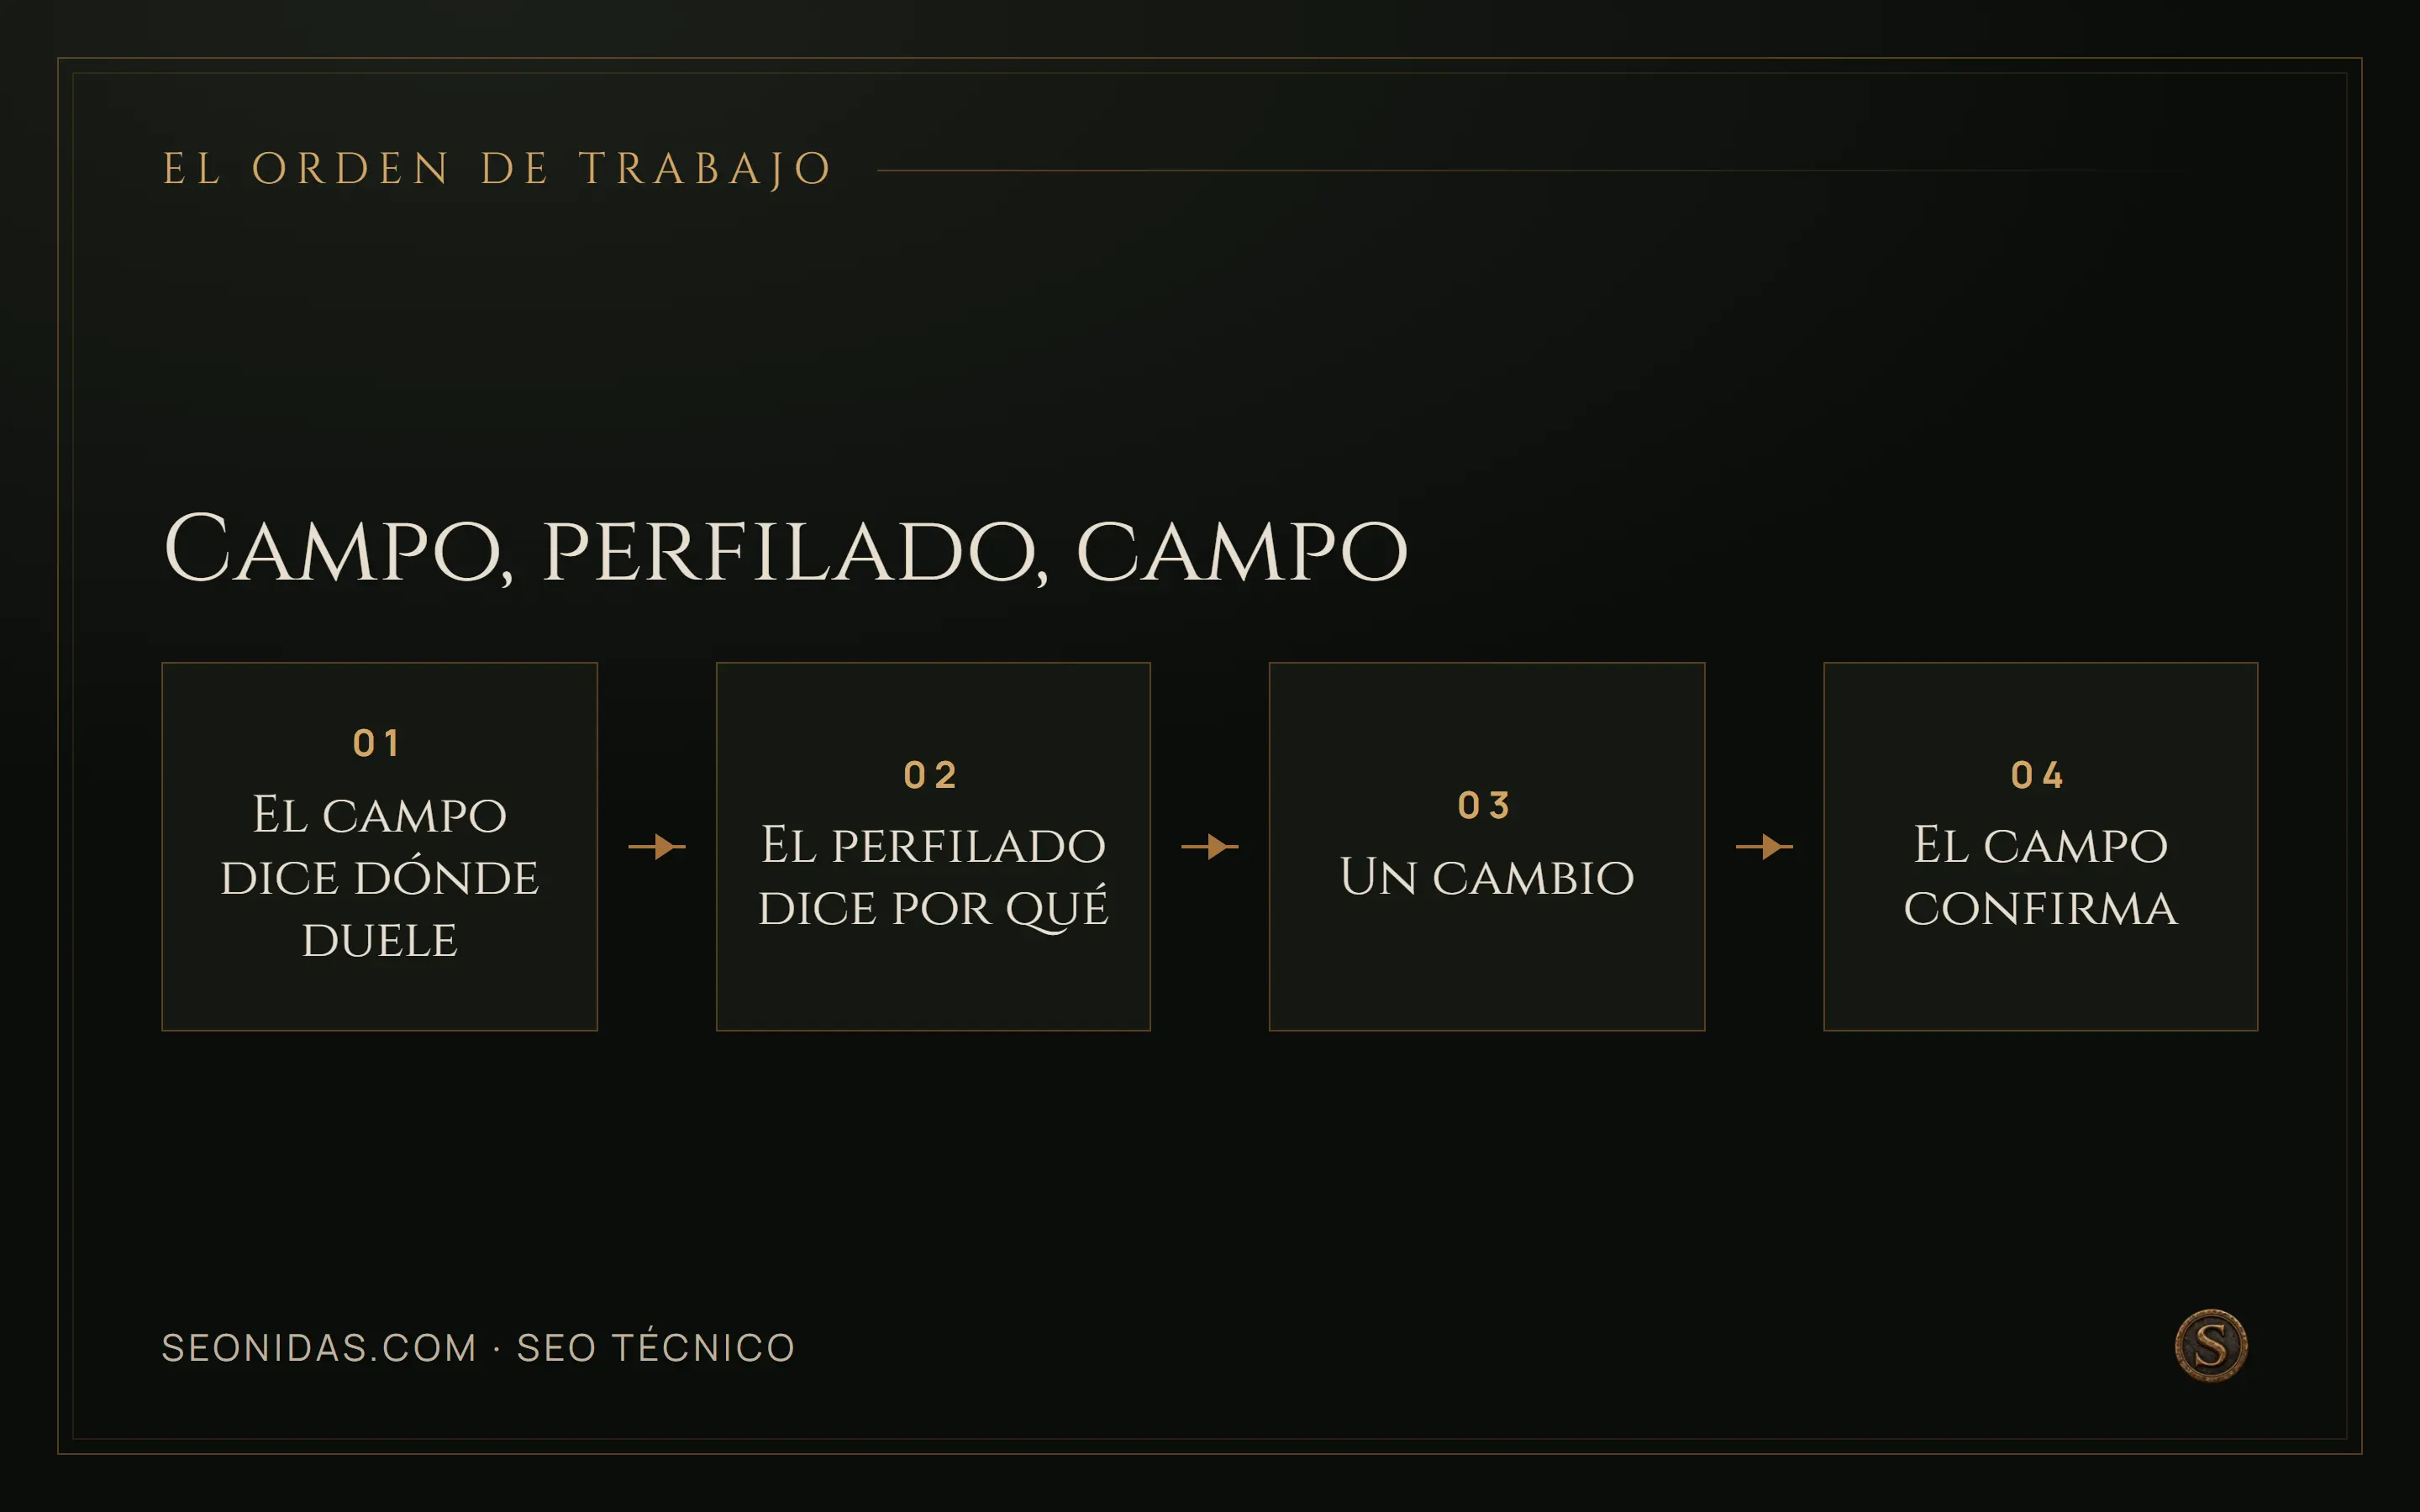
Campo, perfilado, campo: 1. El campo dice dónde duele → 2. El perfilado dice por qué → 3. Un cambio → 4. El campo confirma
Errores frecuentes
- Usar la puntuación de una auditoría sintética como si fuera el INP del sitio.
- Optimizar el manejador propio cuando el problema es el retardo de entrada causado por otro script.
- Aplazar todo el JavaScript hasta la primera interacción y trasladar el coste al momento medido.
- Instalar un plugin de rendimiento adicional antes de identificar la tarea larga.
- Medir solo en escritorio y con conexión rápida.
- Confundir un desplazamiento poco fluido con un problema de INP.
- Desplegar cinco cambios a la vez y no poder atribuir la mejora ni revertir con precisión.
- Eliminar indicadores de foco o mensajes de estado para acelerar la respuesta visual.
- Dar por resuelto el problema con la mediana cuando el umbral se evalúa en el percentil 75.
Preguntas habituales
¿Por qué mi herramienta de laboratorio no me da un INP?
Porque INP mide interacciones reales y una prueba sintética no interactúa: carga la página y la puntúa. Es una métrica de campo, tomada de usuarios durante toda la vida de la página. El laboratorio sirve para encontrar las tareas largas que la empeoran, no para conocer su valor.
¿Qué interacciones cuentan?
Clic, toque y pulsación de teclado. El desplazamiento y el paso del ratón por encima quedan fuera, así que un scroll poco fluido es un problema real pero no es INP. Confundirlos lleva a optimizar animaciones cuando lo que hay que romper es una tarea larga del hilo principal.
Mejoré el LCP y el INP no se movió. ¿Es normal?
Sí: son cuellos distintos. El LCP depende sobre todo de cuánto tarda en llegar y pintarse el contenido principal; el INP, de cuánto ocupa el hilo principal cuando alguien interactúa. Reducir el peso de una imagen puede mejorar uno y no tocar el otro en absoluto.
¿Sirve aplazar todo el JavaScript hasta la primera interacción?
Suele empeorarlo. Ese aplazamiento no elimina el trabajo: lo traslada justo al momento que INP mide, así que la primera interacción paga de golpe todo lo que se había ahorrado antes. Lo que baja INP es partir las tareas largas, no moverlas de sitio.
Próximo paso
Instrumenta la recogida de INP de campo con el elemento responsable y deja pasar una o dos semanas de tráfico normal. Ordena por plantilla y quédate con las dos interacciones peores. Reprodúcelas en el perfilador con limitación de CPU, identifica la tarea larga que domina y corrige solo esa. Vuelve al dato de campo antes de tocar la siguiente.
Fuentes
- web.dev, Interaction to Next Paint: qué mide y cómo se calcula — documentación oficial.
- web.dev, cómo optimizar INP — documentación oficial.
- web.dev, Core Web Vitals — documentación oficial.
Servicio relacionado
Si esto es lo que te está pasando, seo para wordpress es el trabajo que lo resuelve. Diagnóstico primero, prioridades después.
Escrito por
Jesús Iturbide
Consultor SEO técnico · SEONIDAS
Diagnóstico, priorización e implementación SEO en WordPress y PrestaShop. Servicio prestado íntegramente en línea desde Villava, Navarra.
jesusiturbide.comHablemos
¿Tu web tiene un problema de rastreo, indexación o rendimiento que nadie te explica? Cuéntamelo: te respondo en 24 horas laborables con una primera lectura del caso.
Abrir consulta