SEO técnico
Etiqueta canonical: errores y casos que exigen contexto
Publicado el
En esta página
Respuesta breve
La etiqueta canonical declara cuál es la versión preferida de un contenido cuando existen varias URLs equivalentes. Es una señal, no una orden ni una limpieza: no borra las variantes, no impide que se soliciten y no corrige los enlaces que las generan. Los errores que más cuestan no son de sintaxis sino de contexto —aplicar una regla global sin haber clasificado los tipos de URL, canonicalizar páginas que no son equivalentes, o declarar un destino que el resto de las señales contradice—. El trabajo útil consiste en clasificar antes de declarar: parámetros de medición, facetas, paginación y migración son cuatro problemas distintos y ninguno se resuelve con la misma regla.
Puntos clave
- Canonical se usa cuando el contenido es equivalente; si dos páginas responden a intenciones distintas, el problema es de contenido, no de etiqueta.
- La etiqueta no controla el rastreo: la URL se sigue solicitando y procesando.
- Un canonical que contradice enlaces internos, sitemap o redirecciones envía señales incompatibles y puede ignorarse.
- Canonicalizar todas las páginas de una paginación hacia la primera declara preferencia por una página que no contiene el resto de los elementos.
- Dos etiquetas canonical en el mismo documento —tema y plugin— es un fallo frecuente y silencioso.
- En recursos no HTML la señal viaja en la cabecera HTTP, no en el marcado.
- La revisión empieza en el origen que genera cada variante y termina con un rastreo que comprueba el grafo resultante.
Cuatro casos, cuatro declaraciones distintas
Parámetros de seguimiento
Canonical a la URL limpia. Nunca una redirección: rompe la medición.
Facetas y filtros
Solo entre equivalentes. Una faceta con intención propia es otra página.
Paginación
Cada página a sí misma. Canonicalizar a la primera esconde el resto.
Migración
Canonical, enlaces, sitemap y redirecciones tienen que decir lo mismo.
Qué declara el canonical y qué no
La declaración correcta es una sola etiqueta en el <head>, con URL absoluta, apuntando a un destino que responde 200 y muestra el mismo contenido. Todo lo demás son variantes de lo mismo: una URL relativa que se resuelve mal, un destino que redirige, un destino con noindex, o una etiqueta inyectada en el cuerpo del documento donde no se lee.
Lo que la etiqueta no hace conviene enumerarlo, porque casi todos los errores prácticos nacen de esperar de ella algo que no ofrece. No impide el rastreo de la variante. No consolida automáticamente páginas con contenido distinto. No sustituye a una redirección cuando el objetivo es que nadie llegue a la versión antigua. Y no gana frente al conjunto de las demás señales: si la navegación, el sitemap y las redirecciones apuntan a otra URL, el sistema puede elegir esa otra. La distinción entre lo que se rastrea y lo que se selecciona está desarrollada en rastreo e indexación.
Caso 1: parámetros de tracking
Una URL con UTM puede mostrar el mismo contenido que la versión limpia. El canonical suele apuntar a la URL sin tracking, mientras enlaces internos y sitemap usan la limpia. La redirección no siempre conviene porque los parámetros participan en medición; la decisión debe conservarlos donde corresponda sin indexar variantes. No todos los parámetros de URL piden el mismo tratamiento: los de seguimiento, los de ordenación y los que cambian el contenido se resuelven de forma distinta.
Este es el caso con la respuesta más clara, y aun así se rompe por dos vías. La primera es la plantilla que construye el canonical concatenando la URL solicitada en lugar de la URL registrada de la entrada: entonces la variante con parámetros se declara canónica de sí misma y la señal desaparece. La comprobación: pide una URL con un parámetro inventado y lee la etiqueta en el HTML de origen.
La segunda vía es redirigir los parámetros por comodidad. Una 301 que elimina la cadena de consulta rompe la medición de campaña —el parámetro nunca llega a la analítica— y además puede afectar a enlaces externos que llegan con identificadores necesarios. La regla es conservar el parámetro en la respuesta y resolver la duplicidad con el canonical, no con una redirección.
Caso 2: facetas y filtros
Algunas combinaciones son duplicadas; otras responden a una intención propia. Aplicar el canonical de la categoría a todas oculta esa diferencia y no controla el rastreo. Primero clasifica tipos de URL, enlaces, inventario y mantenimiento.
El daño de la regla global es doble. Por un lado, las combinaciones con demanda propia —las que la gente busca con nombre— quedan declaradas como versiones de otra página y pierden la posibilidad de responder por sí mismas. Por otro, el espacio de rastreo no se reduce ni un poco, porque la etiqueta se lee después de servir la página. Se paga el coste de generar y servir todas las variantes sin obtener a cambio la contención que se buscaba.
La clasificación previa distingue tres situaciones: combinaciones que merecen ser páginas propias con contenido y enlaces, combinaciones útiles dentro de la sesión que no se enlazan de forma permanente, y el producto cartesiano de filtros que directamente no debería generarse. Solo la segunda familia es candidata natural al canonical hacia la categoría; para la tercera, la palanca está en el generador de enlaces y, cuando corresponde, en robots.txt.
Caso 3: paginación
Canonicalizar todas las páginas a la primera puede indicar que se prefiere contenido que no contiene los productos o artículos de las siguientes páginas. Cada URL paginada necesita una decisión coherente y navegación HTML, como desarrolla la guía sobre paginación y scroll infinito sin perder páginas por el camino.
La opción sostenible es que cada página de la serie sea canónica de sí misma, con un title que la distinga y enlaces HTML reales a la anterior y la siguiente. Así los elementos de las páginas profundas son alcanzables y la señal no contradice lo que la página muestra. Añadir la página a la que se canonicaliza al sitemap y dejar fuera las demás es un patrón coherente con esa decisión.
Existe una alternativa legítima: una página «ver todo» que muestre la serie completa y hacia la que apunten los canonical de las paginadas. Solo es defendible si esa página existe de verdad, carga en un tiempo razonable y está enlazada. Cuando la serie es larga, el remedio suele ser peor que el problema. Y en cualquiera de las dos opciones, si el listado se carga por desplazamiento infinito, tiene que existir la ruta paginada equivalente y enlazada.
Caso 4: migración
Durante una migración, canonical nuevo, redirección, sitemap y enlaces deben coincidir. Un canonical actualizado sin 301 deja dos superficies accesibles. Una 301 hacia una página no equivalente tampoco conserva la tarea.
El orden de las operaciones evita la mayor parte de los incidentes. Primero se publica el mapa de redirecciones origen–destino y se comprueba que cada destino responde 200 y resuelve la misma necesidad. Después se actualizan los enlaces internos para que apunten directamente al destino final, sin pasar por la redirección. Solo entonces se regenera el sitemap con las URLs nuevas. Dejar los enlaces internos apuntando a las URLs antiguas funciona, pero mantiene indefinidamente una capa de saltos que nadie vuelve a limpiar.
Las cadenas son el residuo típico de varias migraciones acumuladas: A redirige a B, B a C y C a D. Cada salto añade latencia y diluye la señal. La comprobación se hace con un rastreo que siga las redirecciones y devuelva el número de saltos por URL; cualquier valor mayor que uno se corrige apuntando el origen directamente al destino final. El contexto completo está en migraciones SEO.
Matriz de verificación
- una sola etiqueta en HTML;
- URL absoluta y canónica;
- destino accesible y compatible;
- sin
noindexcontradictorio; - sitemap contiene la versión preferida;
- enlaces internos apuntan a la preferida;
- redirecciones no crean cadena;
- caché sirve la versión actual.
Cada punto se comprueba sobre el HTML de origen, no sobre el inspector del navegador, y sobre una URL real de cada plantilla. La comprobación de «una sola etiqueta» es la que más sorpresas da en WordPress: el tema puede inyectar la suya y el plugin de SEO otra, y el resultado son dos declaraciones que pueden coincidir hoy y divergir tras una actualización. Contar las apariciones de rel="canonical" en la respuesta cruda es una comprobación de un segundo que conviene repetir después de cada despliegue.
Falta un punto que la matriz no recoge y que aparece en catálogos y bibliotecas de descargas: los recursos que no son HTML. Un PDF o una imagen no tienen <head>, así que la señal viaja en la cabecera Link de la respuesta HTTP. Si el mismo documento se sirve desde dos rutas, esa es la vía. La guía de sitemap añade comprobaciones XML complementarias.
| Comprobación | Dónde se mira | Lo que suele fallar |
|---|---|---|
| Una sola etiqueta en el HTML | La respuesta cruda de una URL real de cada plantilla | El tema inyecta la suya y el plugin de SEO otra |
| URL absoluta y canónica | La propia etiqueta | Relativa, o con host o protocolo distintos |
| Destino accesible y compatible | Una petición al destino | Responde con redirección o no muestra el contenido |
| Sin noindex contradictorio | Meta robots y cabecera | Se declara preferida una URL que se pide no indexar |
| El sitemap contiene la versión preferida | sitemap.xml | Lista la variante en lugar de la preferida |
| Los enlaces internos apuntan a la preferida | Un rastreo del sitio | La navegación sigue enlazando la variante |
| Las redirecciones no crean cadena | La secuencia completa de cabeceras | Un salto intermedio que el navegador no enseña |
| La caché sirve la versión actual | La superficie pública, tras purgar | Una copia antigua con la etiqueta anterior |
| Recursos que no son HTML | La cabecera Link de la respuesta | Un PDF o una imagen servidos desde dos rutas sin señal |
Canonical es una señal, no una limpieza
Declarar un destino preferido no elimina automáticamente las variantes ni corrige los enlaces que las generan. Si navegación, sitemap y redirecciones apuntan a URLs distintas, el sistema sigue enviando señales contradictorias. Por eso la revisión empieza en el origen de cada variante y termina con un rastreo que comprueba el grafo resultante.
También hay que distinguir duplicidad de intención compartida. Dos páginas parecidas pueden necesitar contenido y propósito más claros en lugar de una canonical cruzada. La decisión se documenta por tipo de plantilla; aplicar una regla global sin muestra previa puede ocultar páginas válidas.
El síntoma de haber usado la etiqueta como sustituto de una decisión editorial es reconocible: una de las dos páginas deja de recibir visibilidad y la otra no gana lo que la primera perdió, porque el sistema nunca las consideró equivalentes. Cuando ocurre, la corrección no es cambiar la dirección del canonical sino diferenciar las páginas o fusionarlas de verdad, con redirección y contenido unificado.
La corrección no es cambiar la dirección del canonical sino diferenciar las páginas o fusionarlas de verdad, con redirección y contenido unificado.
En cuatro láminas
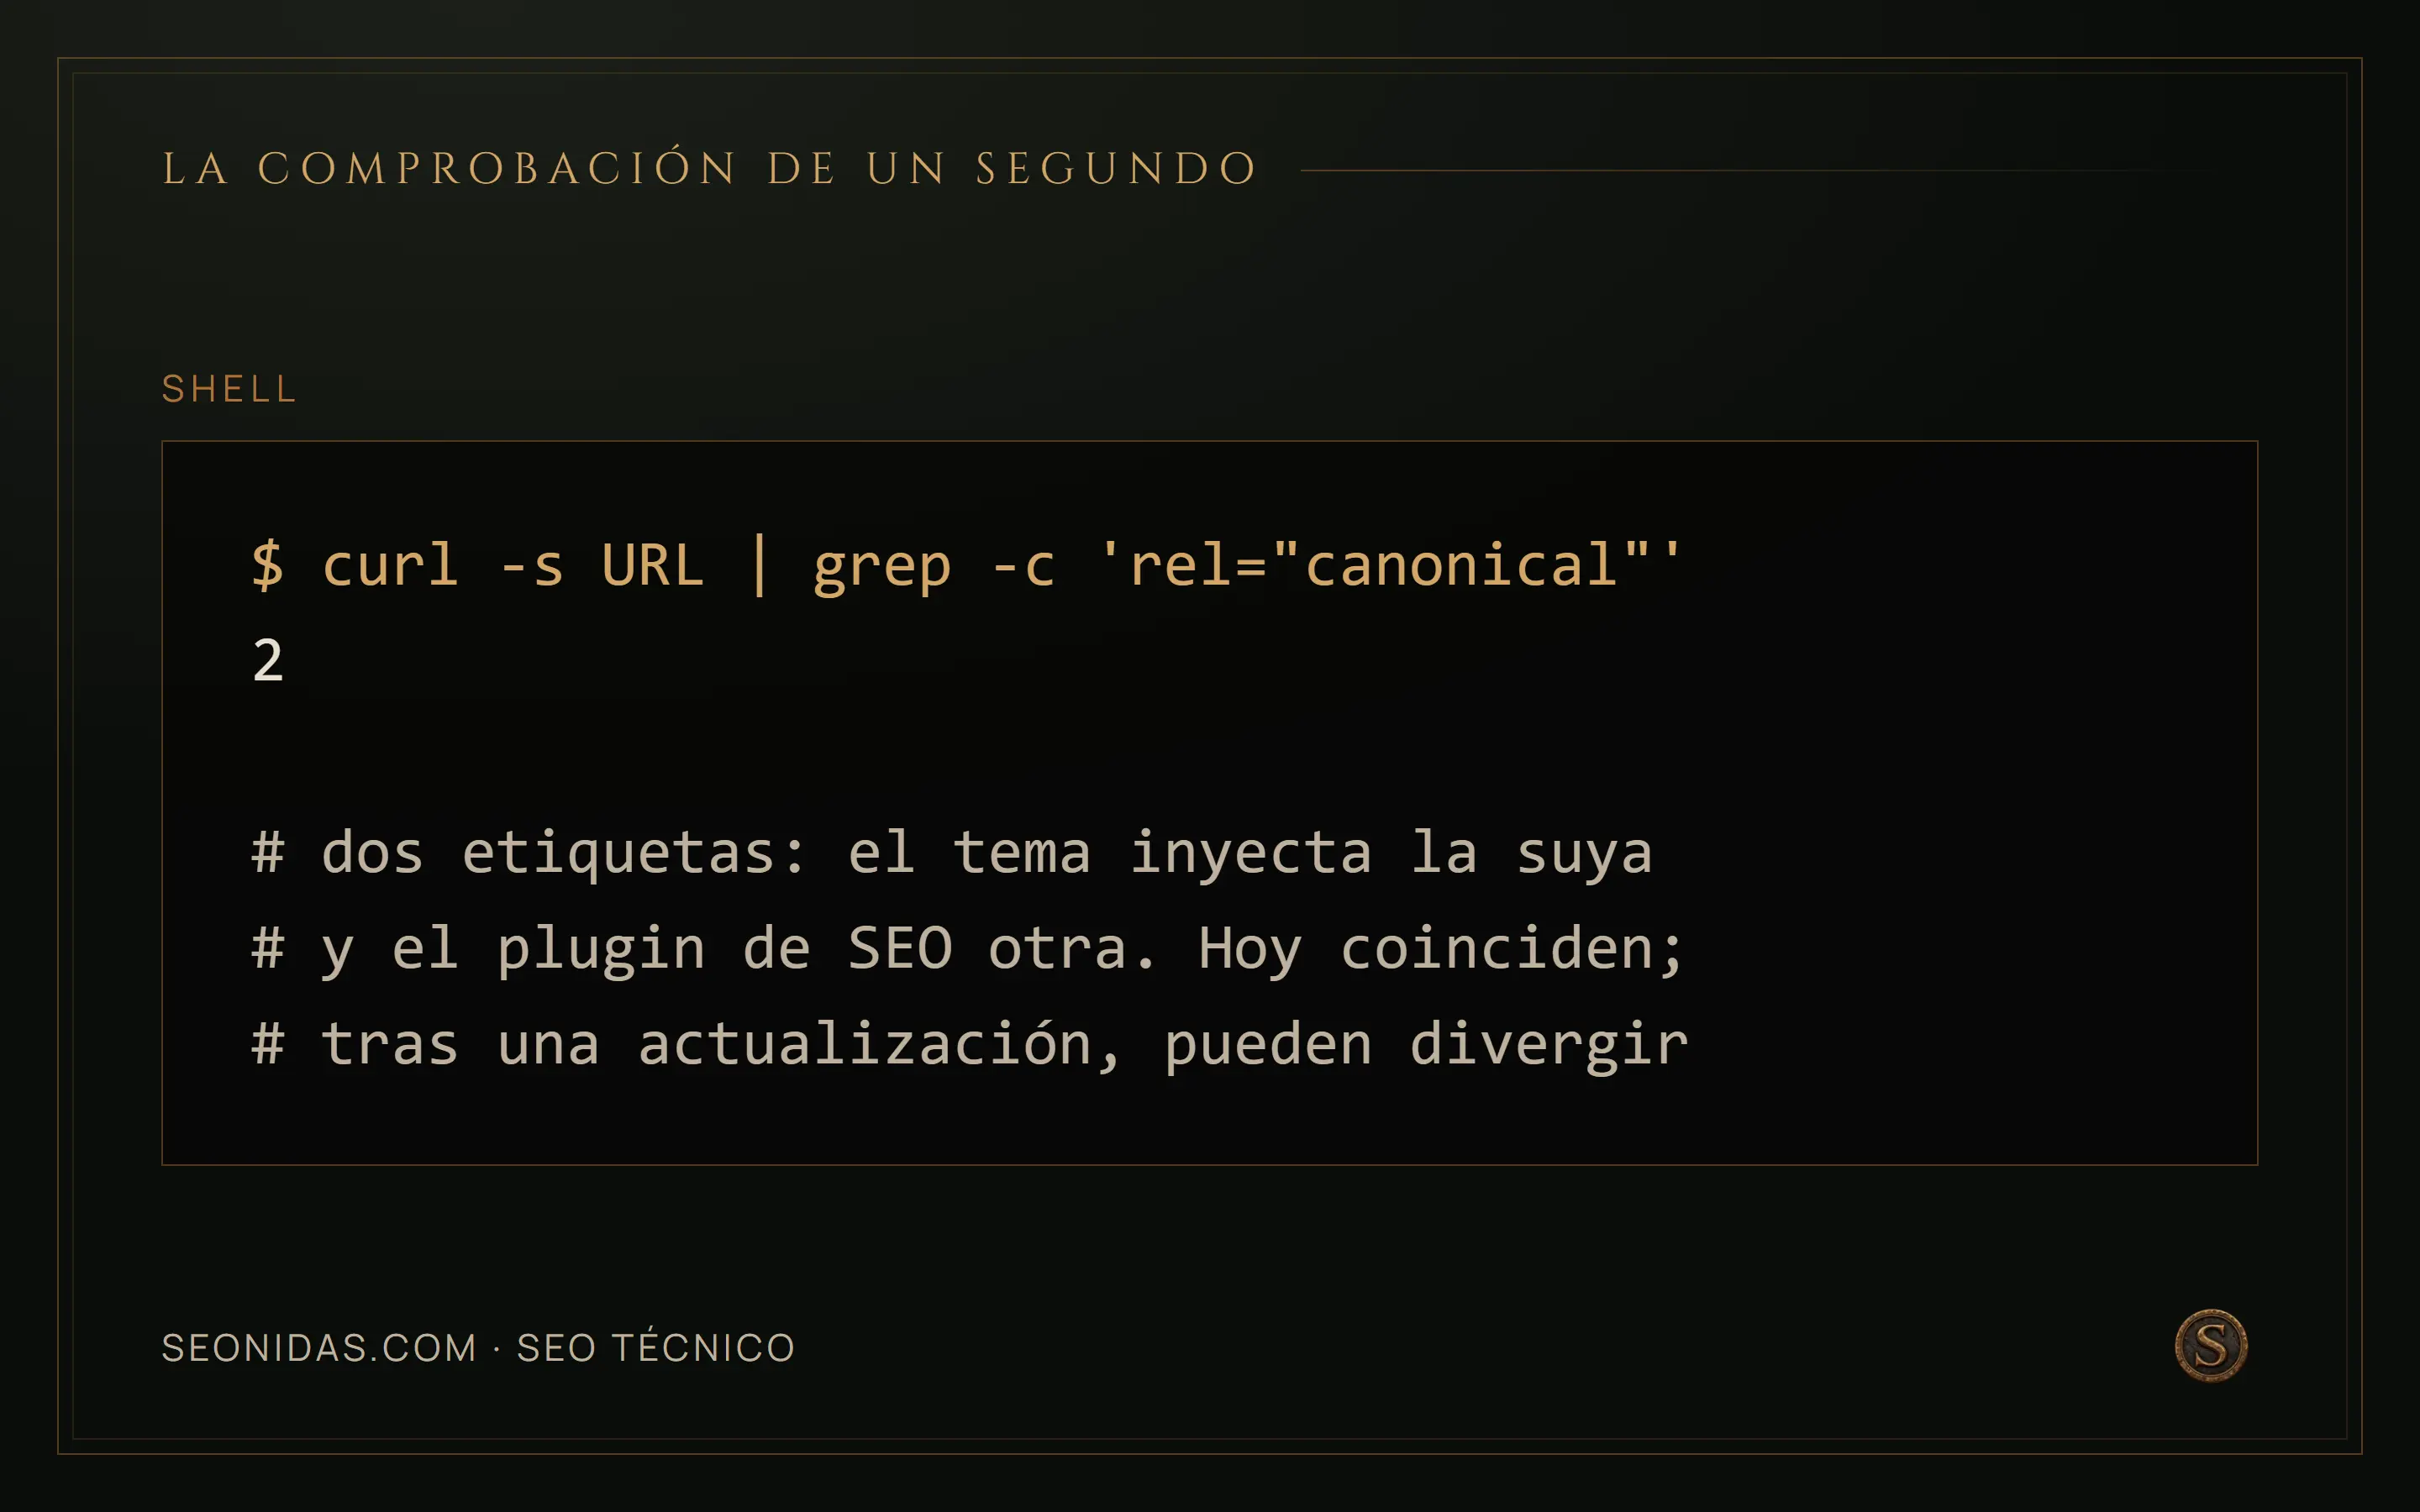
shell: $ curl -s URL | grep -c 'rel="canonical"' / 2 / / # dos etiquetas: el tema inyecta la suya / # y el plugin de SEO otra. Hoy coinciden; / # tras una actualización, pueden divergir
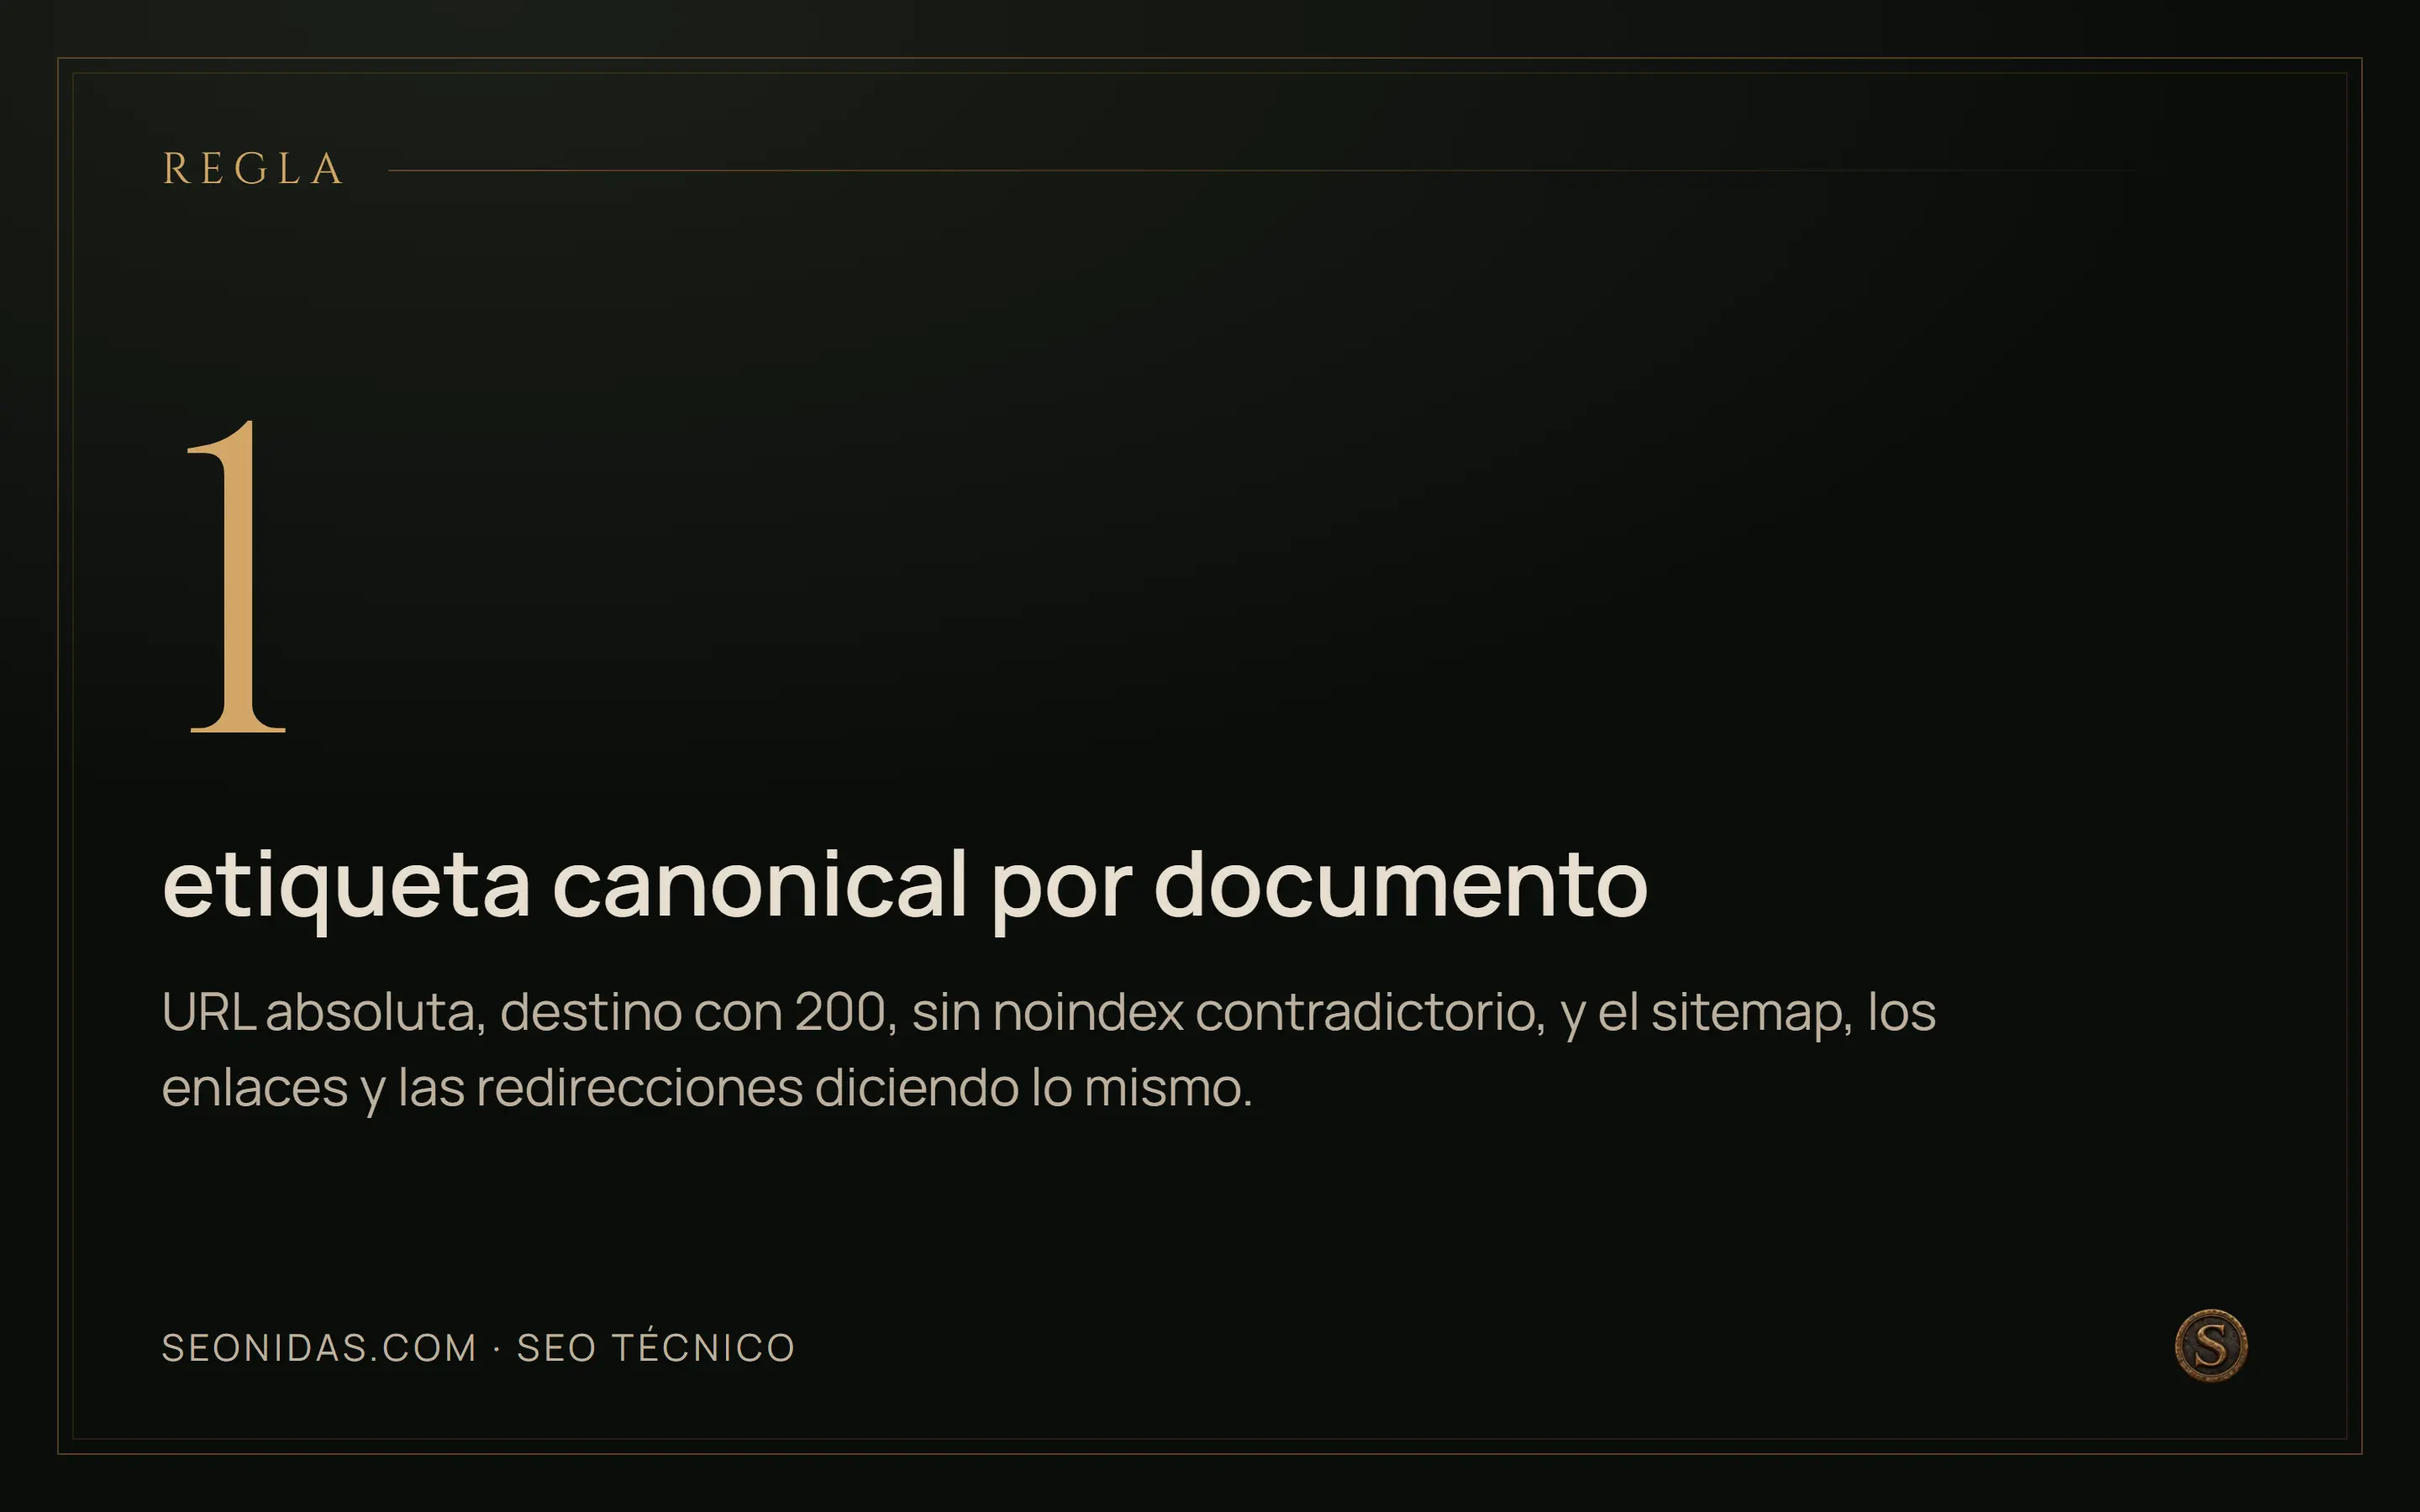
1 etiqueta canonical por documento. URL absoluta, destino con 200, sin noindex contradictorio, y el sitemap, los enlaces y las redirecciones diciendo lo mismo.
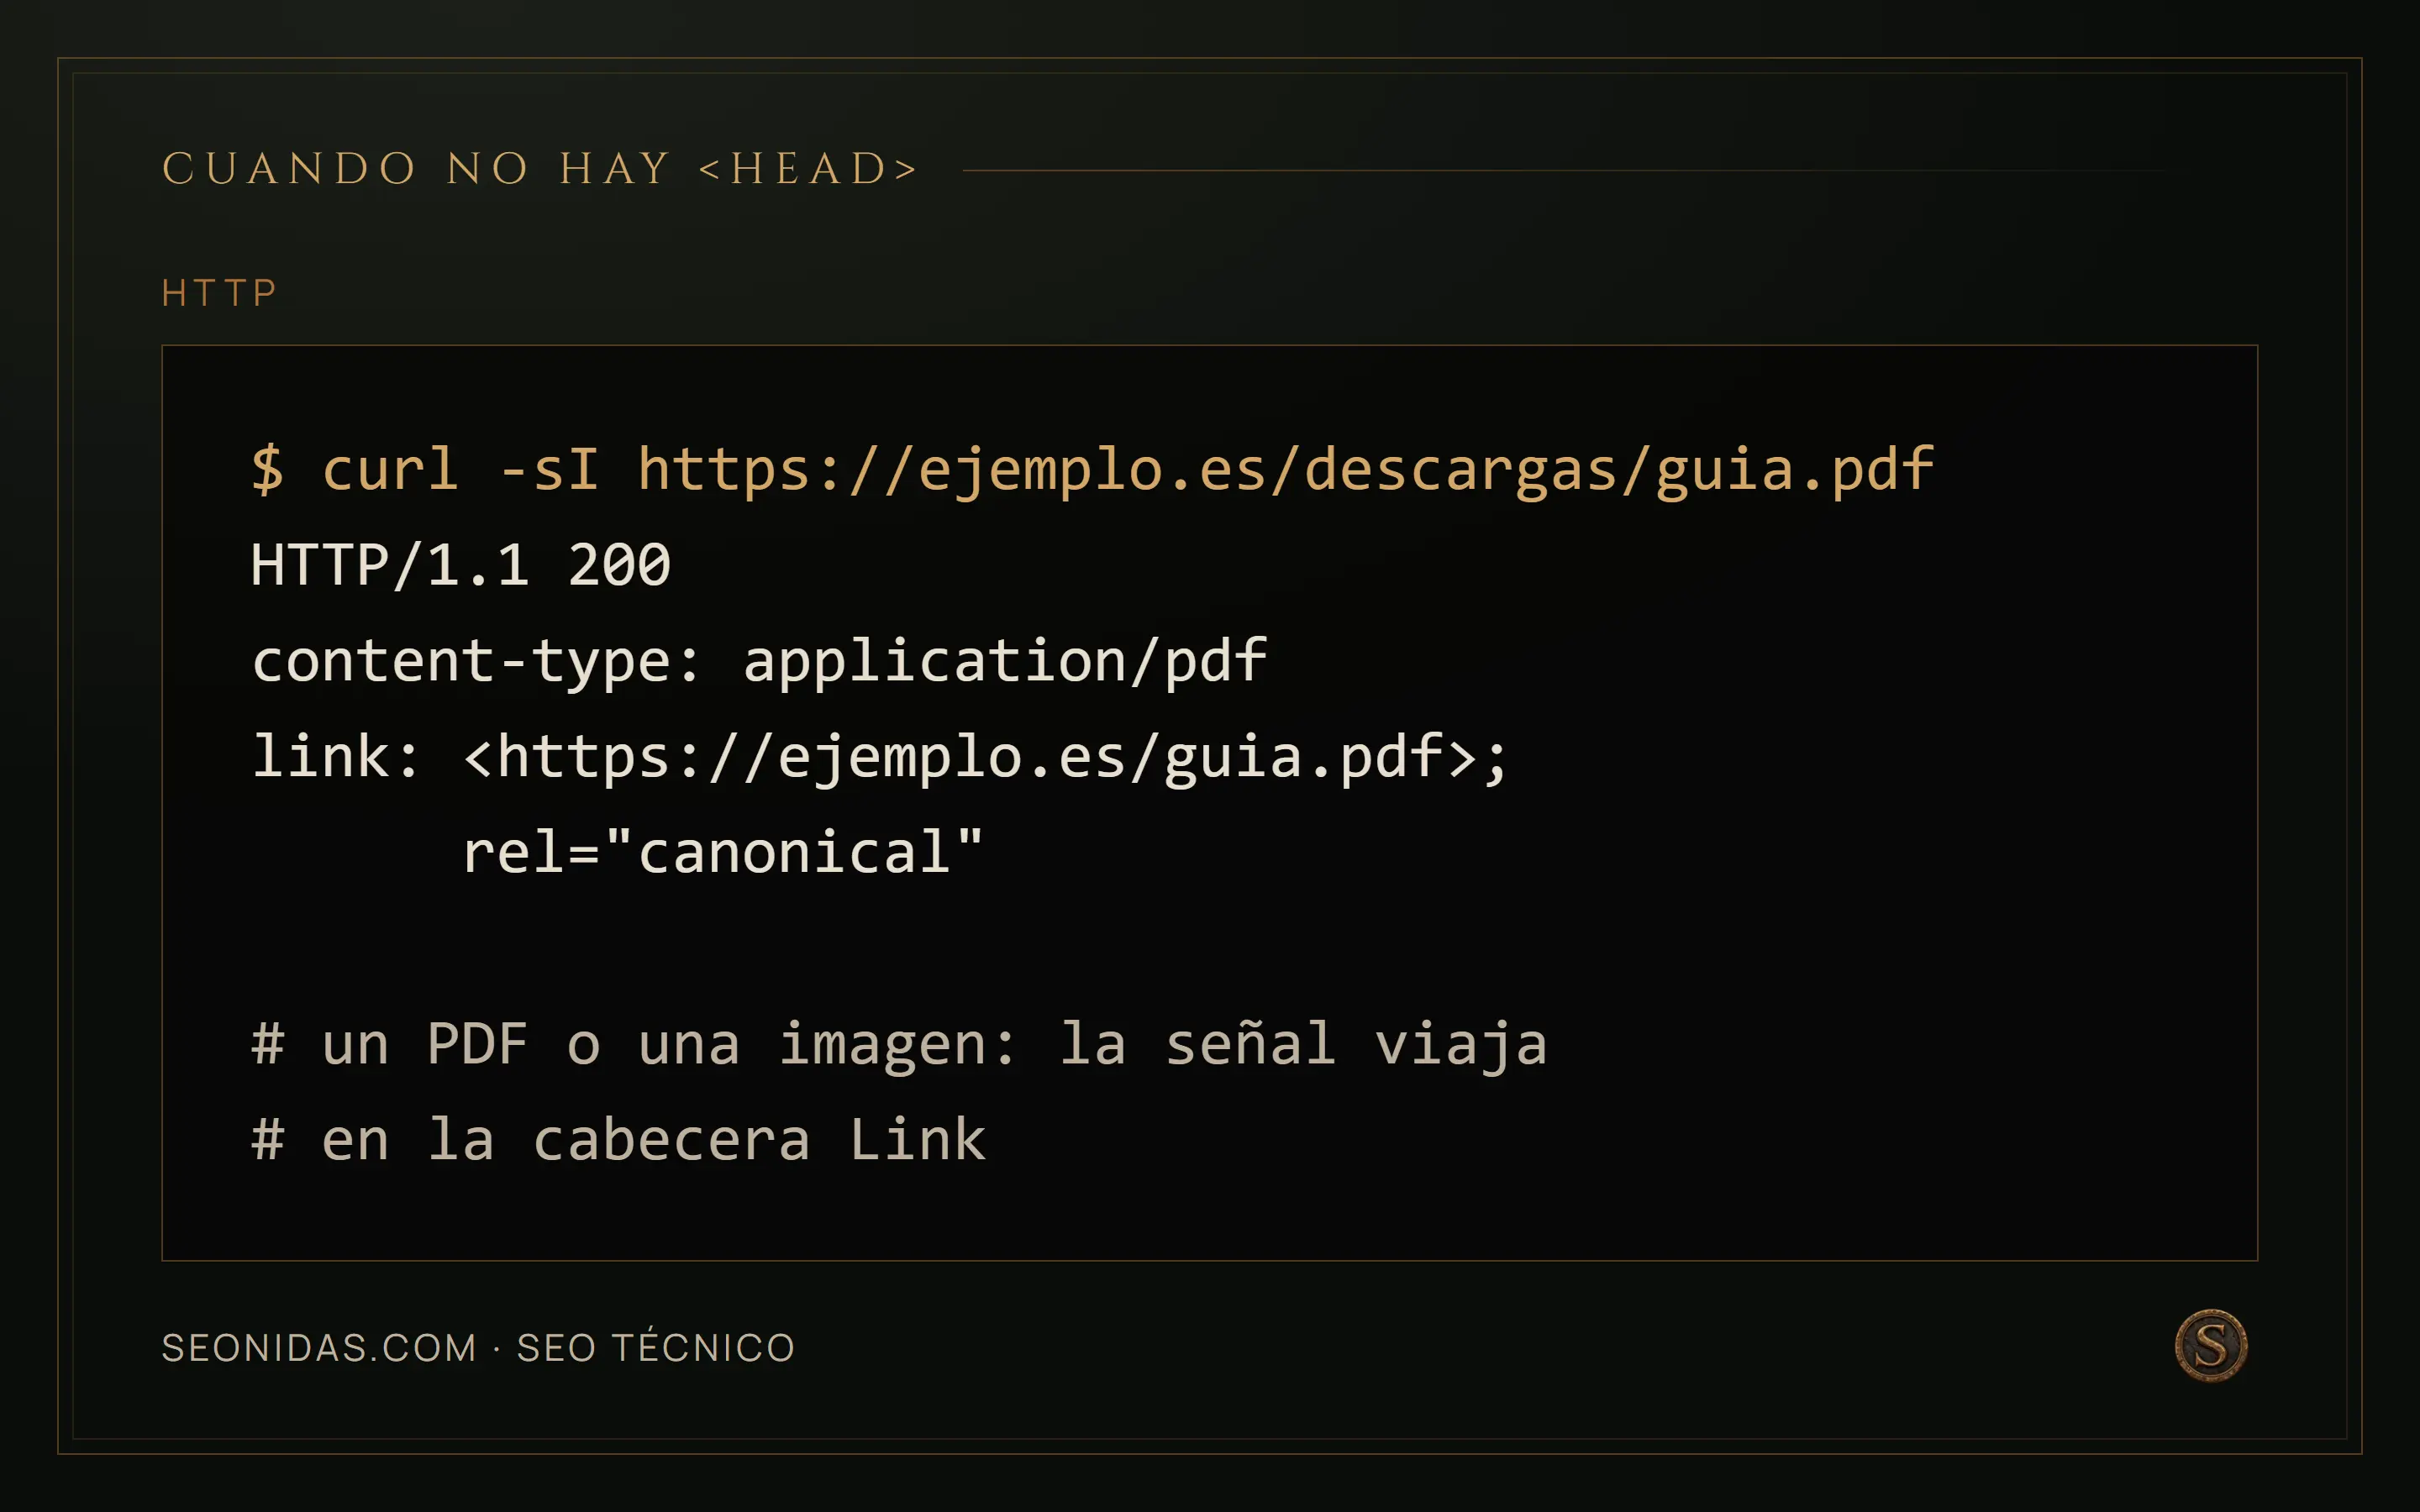
HTTP: $ curl -sI https://ejemplo.es/descargas/guia.pdf / HTTP/1.1 200 / content-type: application/pdf / link: <https://ejemplo.es/guia.pdf>; / rel="canonical" / / # un PDF o una imagen: la señal viaja / # en la cabecera Link
Errores frecuentes
- Canonicalizar páginas que no son equivalentes. Si responden a intenciones distintas, el problema es de contenido y la etiqueta lo esconde.
- Dos etiquetas en el mismo documento. Tema y plugin declarando a la vez; se detecta contando apariciones en el HTML de origen.
- Canonical hacia una URL que redirige. El destino tiene que responder 200 y mostrar el contenido.
- Canonical hacia una URL con
noindex. Se declara como preferida una página que se ha pedido no indexar. - Esperar que la etiqueta reduzca el rastreo. Se lee después de servir la página; la contención se decide en el enlazado.
- Canonicalizar toda la paginación a la primera página. Se declara preferencia por contenido que no incluye el resto de los elementos.
- Redirigir los parámetros de campaña. Rompe la medición para resolver un problema que corresponde al canonical.
- Aplicar una regla global sin muestra previa. Una plantilla mal clasificada arrastra cientos de URLs.
Preguntas habituales
¿La etiqueta canonical elimina las variantes?
No: es una señal, no una limpieza. No borra las URLs, no impide que se soliciten y no corrige los enlaces que las generan. Si la navegación sigue enlazando la variante, seguirá existiendo y compitiendo, con canonical o sin él.
¿Puedo canonicalizar dos páginas parecidas?
Solo si el contenido es equivalente. Si responden a intenciones distintas, canonicalizar esconde el síntoma y desactiva una respuesta válida: la consulta que atendía la página descartada se queda sin destino. El problema entonces era de arquitectura, no de duplicación.
¿Puede haber dos etiquetas canonical en una página?
Puede haberlas —tema y plugin declarando cada uno la suya— y es un fallo silencioso: no da error y las señales se contradicen. Se detecta contando cuántas veces aparece la etiqueta en el HTML servido, que es una comprobación de un minuto y casi nadie hace.
¿Canonical reduce el rastreo?
No: se lee después de servir la página, así que la petición ya se ha hecho. La contención del rastreo se resuelve en otro sitio —dejando de generar los enlaces que crean las variantes—, no con una etiqueta que solo se puede leer descargando la URL.
Próximo paso
Toma una URL representativa de cada plantilla del sitio —portada, categoría, ficha, artículo, archivo paginado, página con parámetros— y lee su HTML de origen buscando rel="canonical". Anota cuántas apariciones hay, si la URL es absoluta y qué responde el destino. Ese barrido de diez minutos suele revelar la mayoría de los problemas reales antes de abrir ninguna herramienta. Con la lista de defectos en la mano, corrige primero el origen que genera cada variante —el enlace, el filtro, la plantilla— y deja la etiqueta para el final, que es el papel que le corresponde. El encaje con el resto de la capa técnica está en SEO técnico.
Fuentes
- Google Search Central, canonicalización en la Búsqueda — documentación oficial.
- Google Search Central, consolidar URLs duplicadas — documentación oficial.
Servicio relacionado
Si esto es lo que te está pasando, seo técnico es el trabajo que lo resuelve. Diagnóstico primero, prioridades después.
Escrito por
Jesús Iturbide
Consultor SEO técnico · SEONIDAS
Diagnóstico, priorización e implementación SEO en WordPress y PrestaShop. Servicio prestado íntegramente en línea desde Villava, Navarra.
jesusiturbide.comHablemos
¿Tu web tiene un problema de rastreo, indexación o rendimiento que nadie te explica? Cuéntamelo: te respondo en 24 horas laborables con una primera lectura del caso.
Abrir consulta