SEO técnico
Rastreo e indexación: diferencias y un diagnóstico que no las confunde
Respuesta breve
Rastrear es que un sistema solicite una URL y reciba una respuesta; indexar es que, tras procesarla, decida conservarla como candidata a aparecer en resultados. Son fases distintas de una misma cadena —descubrimiento, acceso, procesamiento y selección— y cada una falla por motivos diferentes: una URL puede descubrirse y no rastrearse, rastrearse y no indexarse, o estar indexada y no recibir impresiones. Confundirlas lleva a corregir la capa equivocada: se retoca el contenido cuando el problema era un 403 del WAF, o se revisa el servidor cuando la página declara noindex.
Puntos clave
- Cuatro fases —descubrimiento, acceso, procesamiento y selección— y cada una necesita su propia evidencia.
- Aparecer en el sitemap es una señal de descubrimiento, no una garantía de rastreo ni una recomendación de arquitectura.
- «Indexable» describe una condición técnica, no una obligación del buscador.
- Un agente puede recibir una respuesta distinta a la del navegador por caché, WAF, geolocalización o reglas por user-agent.
- La cadena de user-agent se falsifica con trivialidad: se verifica por DNS inverso o rangos de IP publicados.
- Los estados de Search Console son puntos de investigación, no causas cerradas.
Las cuatro fases de la cadena
- DescubrimientoEl sitemap es una señal, no una garantía de rastreo.
- AccesoLa respuesta real al agente, que puede diferir de la del navegador.
- ProcesamientoLo que se lee del HTML servido, no del DOM ejecutado.
- SelecciónConservarla como candidata: los estados de Search Console son pistas.
Descubrimiento antes del rastreo
El sistema necesita encontrar una URL mediante enlaces, sitemaps u otras señales. Estar en /wp-sitemap.xml no implica que la arquitectura la recomiende ni que tenga valor. Los enlaces internos aportan contexto y una ruta para personas.
Las vías de descubrimiento no equivalen entre sí. Los enlaces internos son la más informativa: indican jerarquía, contexto y anclaje. El sitemap XML es una lista declarativa: dice «existe», no «importa». Y el histórico del sistema mantiene URLs de rastreos anteriores, incluidas las que ya no enlaza nadie.
De ahí sale la comprobación más rentable: cruzar el sitemap con un rastreo propio partiendo de la portada. Las URLs que están en el sitemap y no en el rastreo son huérfanas —declaradas pero no enlazadas—; las que están en el rastreo y no en el sitemap indican que la generación excluye plantillas que sí navegas. Ninguna asimetría es un fallo automático, pero ambas exigen una decisión consciente: enlazar, retirar del sitemap o documentar por qué conviven.
Conviene separar además descubrimiento de preferencia: filtros combinados u ordenaciones son descubribles por definición y rara vez aportan una respuesta propia. La guía de enlazado interno ordena esas prioridades antes de tocar plantillas.
Acceso y respuesta
El rastreo depende de DNS, servidor, WAF, robots, status y recursos. Un agente puede recibir una respuesta distinta por caché o protección. Por eso se guardan cabeceras, HTML y fecha, y se distingue una prueba local de una lectura pública.
La petición atraviesa más capas de las que suele revisarse: DNS, TLS, CDN o proxy, firewall de aplicación, servidor web, caché de página y PHP. Cualquiera de ellas puede devolver algo distinto a lo que ves desde tu navegador y tu IP habitual. El caso más frecuente con protección anti-bot es un 403 o un desafío JavaScript servido solo a agentes automatizados: el contenido existe, el navegador lo ve y el rastreador recibe una página sin cuerpo útil.
Los códigos de estado también se leen mal. Un 200 que sirve una plantilla de error es un soft 404 que consume rastreo sin aportar nada. Un 301 hacia una página no equivalente conserva la redirección pero pierde la tarea. Y una cadena de tres o cuatro saltos funciona para una persona, pero degrada el rastreo y diluye señales, como desarrolla la guía sobre cadenas, bucles y cuándo no redirigir.
Robots.txt merece lectura aparte porque su efecto se malinterpreta: bloquear una URL impide el rastreo, no la indexación. Una URL bloqueada que reciba enlaces puede aparecer en resultados sin descripción, precisamente porque el sistema nunca pudo leer el noindex que había dentro. Para sacar una página del índice hay que permitir el rastreo, no impedirlo. Esa confusión está detrás de casi todos los errores de robots.txt que bloquean justo lo que importa.
Verificar el agente
Antes de sacar conclusiones de un log hace falta saber qué peticiones proceden realmente del buscador. La cadena de user-agent es texto libre: contar «visitas de Googlebot» por coincidencia mezcla el rastreador auténtico con escáneres, herramientas de terceros y tráfico que se disfraza para saltarse filtros.
La verificación correcta es doble: DNS inverso sobre la IP y, después, DNS directo sobre el nombre obtenido para confirmar que devuelve la misma IP; o contrastar la IP contra los rangos publicados. Google documenta el procedimiento en su guía de verificación de rastreadores. La misma disciplina se aplica a los agentes de IA, que no comparten política de identificación ni de obediencia a robots.txt: inventariarlos antes de escribir reglas evita bloqueos accidentales, como desarrolla la matriz de crawlers de IA.
Procesamiento y selección
Después del acceso, el sistema interpreta contenido, canonical, robots, duplicados y otras señales. «Indexable» describe una condición técnica, no la obligación de indexar. Una URL completa puede competir con otra versión o no aportar una respuesta propia.
El procesamiento incluye una fase de render que suele ignorarse. Si el contenido principal se inyecta con JavaScript, hay diferencia entre el HTML de origen y el resultante. Compararlos resuelve una familia de diagnósticos: enlaces que solo existen tras un evento, texto que depende de una API, plantillas que devuelven un contenedor vacío si un recurso falla.
Las directivas conviven y pueden contradecirse. meta robots en el HTML, X-Robots-Tag en la respuesta y rel="canonical" son tres señales independientes; si una plantilla las emite en desacuerdo, el resultado no es la suma sino la interpretación del sistema, casi siempre la más restrictiva. Un plugin de SEO y un tema que inyectan canonical a la vez producen dos etiquetas en el mismo documento, un caso que la revisión de canonical trata en detalle.
La selección es la fase menos controlable. El sistema agrupa versiones equivalentes, elige una representante y descarta el resto; puede elegir una distinta de la declarada si las demás señales —enlaces internos, sitemap, redirecciones, contenido— apuntan a otra parte. Una URL impecable que repite la respuesta de otra no gana nada por estar limpia. La pregunta que cierra esta fase no es «¿puede indexarse?», sino «¿qué respuesta propia aporta que no aporte ninguna otra URL del sitio?».
La pregunta que cierra esta fase no es «¿puede indexarse?», sino «¿qué respuesta propia aporta que no aporte ninguna otra URL del sitio?».
Tabla de diagnóstico
| Pregunta | Evidencia | Error de interpretación |
|---|---|---|
| ¿se descubre? | enlaces y sitemap | asumir que XML basta |
| ¿se rastrea? | logs y respuesta | confundir user-agent con bot auténtico |
| ¿se renderiza? | origen y render | mirar solo la pantalla |
| ¿es candidata? | robots y canonical | llamar indexable a noindex |
| ¿se selecciona? | Search Console y búsqueda contextual | convertir una muestra en certeza |
| ¿aporta respuesta propia? | comparación editorial con URLs hermanas | confundir corrección técnica con utilidad |
| ¿recibe impresiones? | informe de rendimiento segmentado | leer cero clics como cero indexación |
Cada fila se responde con un artefacto distinto: si una fila no tiene evidencia asociada, el diagnóstico está incompleto.
Secuencia de comprobación
- Fija el alcance: una URL, una plantilla o un patrón. Diagnosticar «el sitio» de golpe mezcla causas.
- Solicita la URL sin cookies ni sesión y guarda estado, cabeceras y cuerpo con fecha; repite con el user-agent del rastreador y compara. Si la respuesta cambia, el problema está en una regla de acceso.
- Comprueba robots.txt sobre esa ruta exacta, parámetros incluidos, y verifica qué regla aplica de verdad.
- Lee
meta robots,X-Robots-Tagyrel="canonical"en el HTML de origen, y compáralo con el renderizado si el contenido depende de JavaScript. - Busca en los logs peticiones a esa URL, verifica el agente y anota fechas; el análisis de logs de Googlebot describe qué se puede leer ahí y qué no.
- Contrasta con Search Console: estado, última lectura, canónica declarada frente a seleccionada. Solo entonces formula la hipótesis y aplica un cambio reversible cada vez.
Cómo usar los informes
Segmenta por tipo de página y patrón. Un problema en productos no se extrapola a artículos. Compara fechas con releases y cambios de contenido. Cuando Search Console etiqueta un estado, utilízalo como punto de investigación, no como causa cerrada.
Los estados agrupan situaciones que no comparten causa. «Descubierta: actualmente sin indexar» puede significar cola de rastreo, señales internas débiles o una plantilla que genera más URLs de las que el sitio sostiene. «Rastreada: actualmente sin indexar» apunta más a una decisión de selección: se leyó y no se consideró suficiente. «Página alternativa con etiqueta canónica adecuada» suele ser correcto. «URL enviada marcada como noindex» es una contradicción explícita entre sitemap y plantilla, y siempre merece corrección.
El eje temporal importa tanto como el estado: cruza el informe con el calendario de despliegues y migraciones. La coincidencia de fechas no demuestra causalidad, pero su ausencia sí descarta hipótesis.
La guía de por qué una web no se indexa desarrolla las capas. SEO técnico conecta el diagnóstico con implementación.
En cuatro láminas
4 fases con su evidencia. Descubrimiento, acceso, procesamiento y selección: cada una falla por motivos distintos.
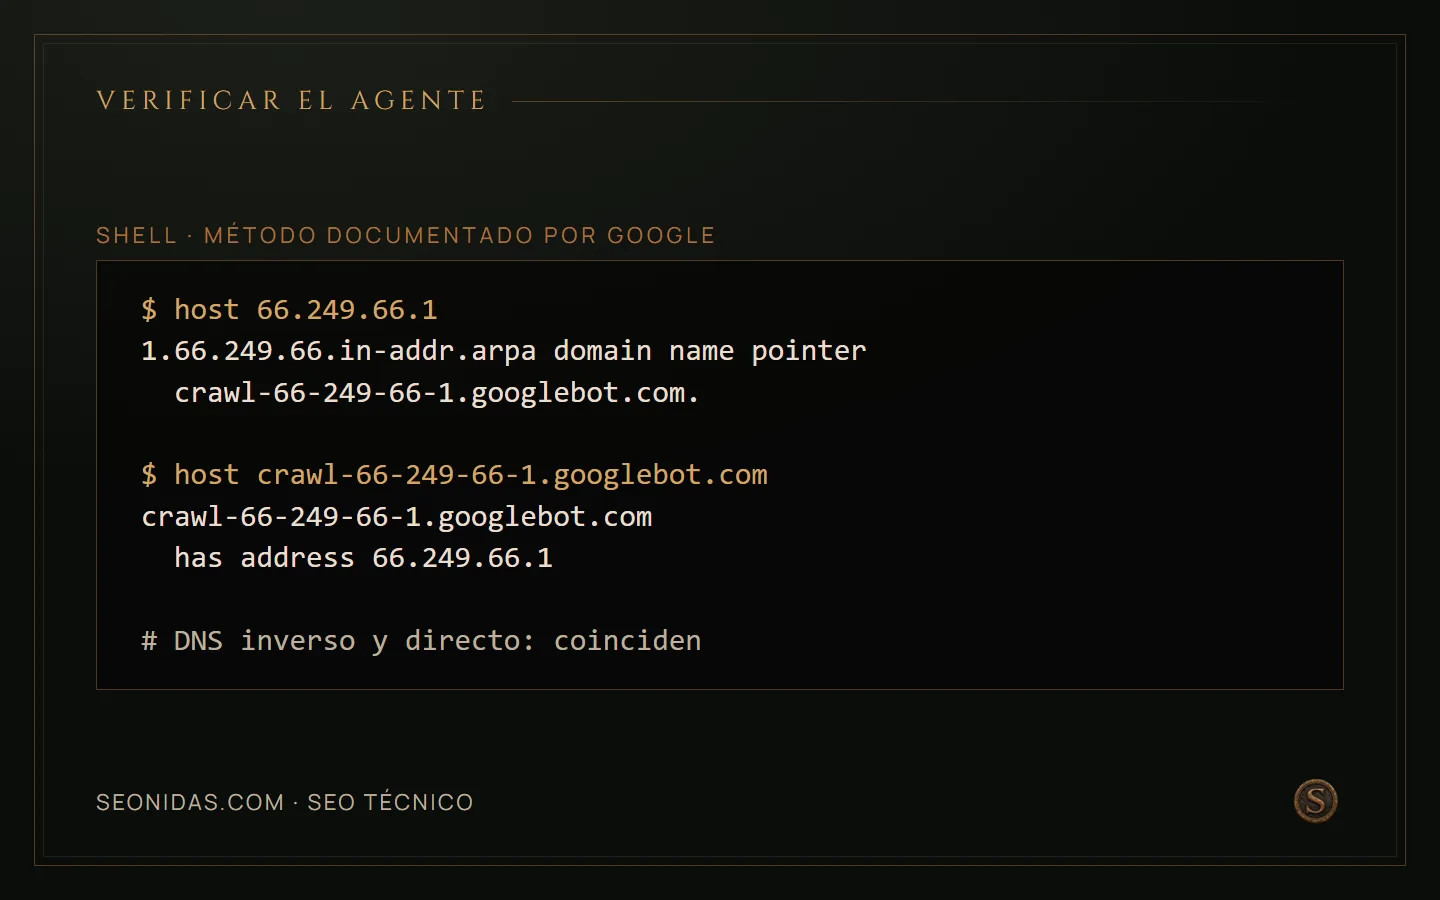
shell · método documentado por Google: $ host 66.249.66.1 / 1.66.249.66.in-addr.arpa domain name pointer / crawl-66-249-66-1.googlebot.com. / / $ host crawl-66-249-66-1.googlebot.com / crawl-66-249-66-1.googlebot.com / has address 66.249.66.1 / / # DNS inverso y directo: coinciden
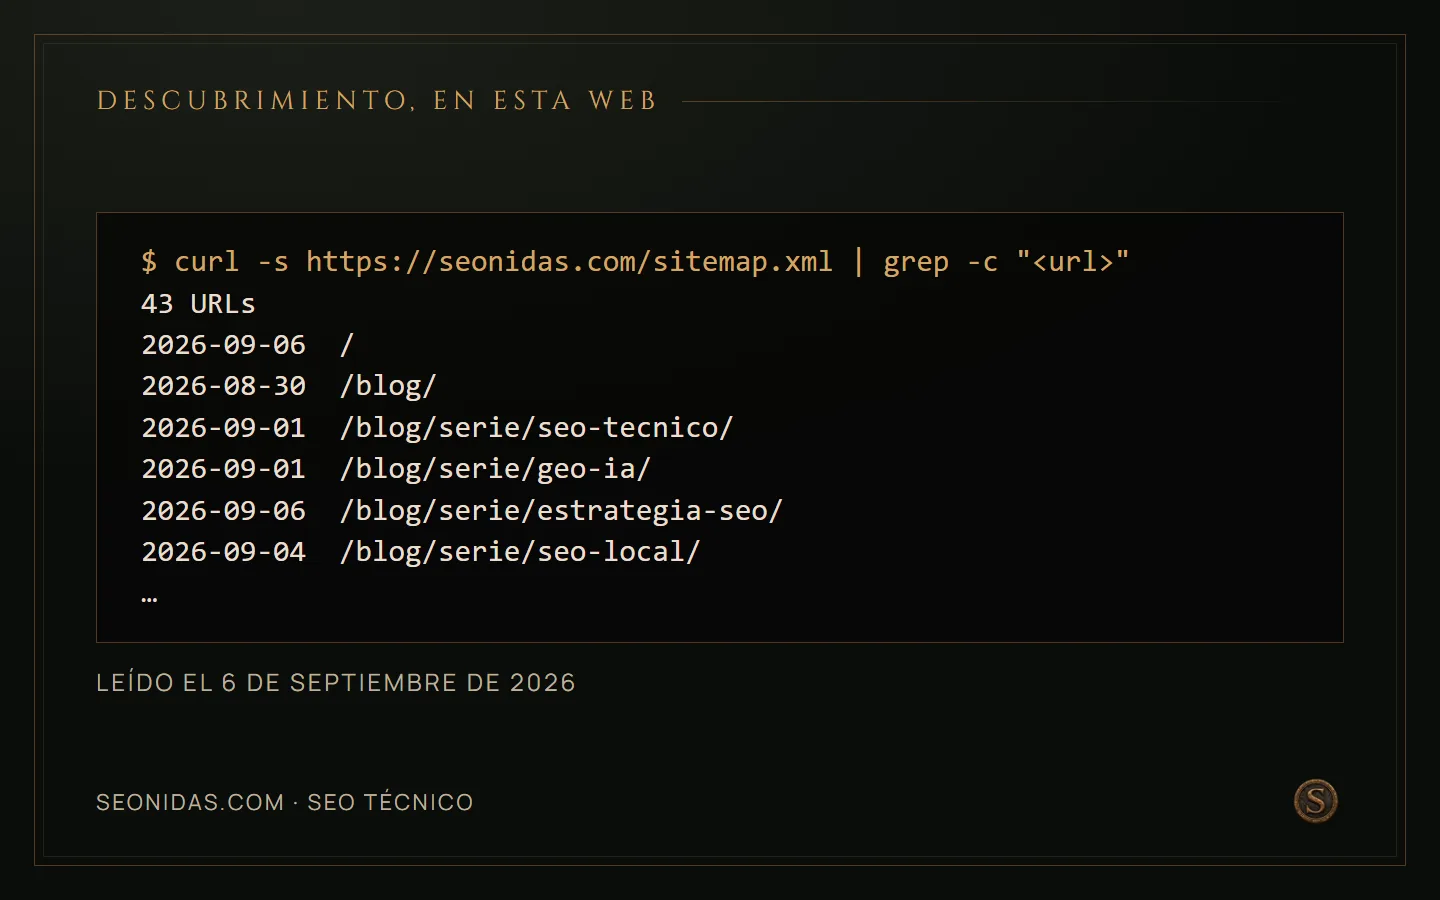
curl -s https://seonidas.com/sitemap.xml | grep -c "<url>". 43 URLs / 2026-09-06 / / 2026-08-30 /blog/ / 2026-09-01 /blog/serie/seo-tecnico/ / 2026-09-01 /blog/serie/geo-ia/ / 2026-09-06 /blog/serie/estrategia-seo/ / 2026-09-04 /blog/serie/seo-local/ / …. Leído el 10 de septiembre de 2026.
Errores frecuentes
- Bloquear en robots.txt para desindexar. Impide leer el
noindex; el efecto es el contrario del buscado. - Contar «visitas de bot» por cadena de user-agent. Sin verificar, la cifra mezcla rastreadores auténticos con tráfico falsificado.
- Leer el HTML en el inspector. Muestra el DOM ya ejecutado; hay que leer también el origen.
- Extrapolar una plantilla a todo el sitio sin haber segmentado.
- Tratar el estado de Search Console como causa. Resume una decisión, no la explica.
- Añadir URLs al sitemap para forzar la indexación. Si la arquitectura no las enlaza, el problema sigue intacto.
- Cambiar varias cosas a la vez. Con dos correcciones simultáneas no hay forma de saber cuál funcionó.
Preguntas habituales
Si Google rastrea una URL, ¿queda indexada?
No. Rastrear es solicitar la URL y recibir una respuesta; indexar es decidir, después de procesarla, conservarla como candidata a aparecer. Son fases distintas y fallan por motivos distintos: una URL puede rastrearse bien y no seleccionarse, o estar indexada y no recibir una sola impresión. Confundirlas lleva a corregir lo que no falla.
¿Cómo sé si las visitas de bot son de Googlebot de verdad?
La cadena de user-agent se falsifica con trivialidad, así que contar visitas por ese campo mezcla rastreadores auténticos con cualquiera que copie el nombre. La verificación se hace por DNS inverso o comprobando la IP contra los rangos que Google publica. Sin ese paso, la cifra de rastreo no sostiene ninguna conclusión.
¿Añadir una URL al sitemap fuerza que se indexe?
El sitemap es una señal de descubrimiento, no una garantía de rastreo ni una recomendación de indexación. Si la arquitectura no enlaza esa URL desde ninguna parte, el problema sigue intacto: se ha declarado que existe, no que merezca conservarse. Añadir URLs al sitemap para forzar la indexación tapa el síntoma.
¿Vale mirar el HTML en el inspector del navegador?
Sirve para ver el DOM ya ejecutado, que no es lo que se descarga. Hay que leer también el origen —el HTML que devuelve el servidor— y compararlos: un agente puede recibir una respuesta distinta a la del navegador por caché, WAF, geolocalización o reglas por user-agent, y esa diferencia es justo la que explica muchos casos.
Próximo paso
Elige una sola plantilla —no el sitio entero— y recorre la secuencia de comprobación sobre tres URLs suyas, guardando la evidencia de cada paso en un archivo con fecha. Normalmente la cadena se rompe en un punto concreto y el resto de hipótesis se descartan solas. Con ese punto identificado, aplica una corrección reversible y espera una ventana de observación comparable antes de tocar nada más. Si aparecen varios hallazgos de capas distintas, ordénalos antes de ejecutar: el proceso de auditoría SEO técnica establece prioridades y criterios de cierre.
Fuentes
- Google Search Central, verificar que una petición es de Google — documentación oficial.
- Google Search Central, cómo funciona la Búsqueda — documentación oficial.
- Google Search Console, informe de indexación de páginas — documentación oficial.
Servicio y herramienta relacionados
Si esto es lo que te está pasando, seo técnico es el trabajo que lo resuelve. Diagnóstico primero, prioridades después.
Y para hacerlo tú: el generador de meta robots sirve para componer la etiqueta con las directivas que necesitas y ver qué hace cada una. Funciona en tu navegador y no envía tus datos a ningún sitio.
Escrito por
Jesús Iturbide
Consultor SEO técnico · SEONIDAS
Diagnóstico, priorización e implementación SEO en WordPress y PrestaShop. Servicio prestado íntegramente en línea desde Villava, Navarra.
jesusiturbide.comHablemos
¿Tu web tiene un problema de rastreo, indexación o rendimiento que nadie te explica? Cuéntamelo: te respondo en 24 horas laborables con una primera lectura del caso.
Abrir consulta