SEO técnico
Por qué Google no indexa una web: diagnóstico por capas
Respuesta breve
Que Google no indexe una web casi nunca tiene una sola causa, y por eso conviene diagnosticarlo por capas en lugar de buscar el fallo culpable. Se comprueba en orden si la URL existe y se descubre, si responde de forma estable, si el buscador puede procesarla, si las señales de canonicalización coinciden entre sí y, solo al final, si la página aporta una respuesta propia. Cada capa se cierra con evidencia observable antes de pasar a la siguiente: saltar al último nivel y concluir «es un problema de calidad» es el atajo que más tiempo hace perder, porque describe un síntoma sin haber descartado un bloqueo técnico trivial.
Puntos clave
- El orden importa: una capa superior sin resolver invalida cualquier conclusión de las inferiores.
- Rastreo e indexación son procesos distintos; una URL rastreada correctamente puede no seleccionarse para el índice.
- Un código 200 no garantiza que se sirva la página correcta: puede ser un error blando, una respuesta de caché antigua o una versión distinta según el agente.
- Los estados del informe de indexación de Search Console son pistas, no diagnósticos cerrados.
- La salida del diagnóstico es una tabla con evidencia, hipótesis, confianza, acción y prueba de verificación, no una lista de recomendaciones genéricas.
- Nunca se usa
robots.txtpara ocultar información privada: impide el rastreo, no la indexación ni el acceso.
El diagnóstico, por capas
- ¿La URL existe y se descubre?Enlaces, sitemap, y que no la excluya el propio sitio.
- ¿Responde de forma estable?Un 200 puede ser un error blando o una caché antigua.
- ¿El buscador puede procesarla?Recursos accesibles y contenido en el HTML.
- ¿Las señales coinciden?Canonical, robots, sitemap y enlaces dicen lo mismo.
- ¿Aporta una respuesta propia?Solo al final, y solo si todo lo anterior está cerrado.
Capa 1: ¿la URL existe y se descubre?
Comprueba enlaces HTML internos, presencia en el sitemap y ruta desde páginas relevantes. Una URL huérfana puede estar en el XML y seguir sin formar parte de la arquitectura: el sitemap declara que existe, no que importe. Registra cuándo se creó, si la navegación la enlaza, a qué profundidad de clics queda desde la portada y si el host canónico es el correcto.
Aquí aparecen dos situaciones que se confunden. Una URL nueva sin enlaces internos puede tardar en descubrirse aunque todo lo demás sea correcto; en ese caso el problema es de arquitectura, no de indexación. Una URL antigua que dejó de estar enlazada porque se rediseñó un menú puede seguir en el índice durante un tiempo y desaparecer después sin que nadie relacione ambos hechos; es justo lo que evita registrar el estado del sitio antes de un rediseño. Guarda la fecha de creación y la fecha del último cambio estructural: sin esas dos referencias, cualquier hipótesis temporal es una suposición.
Capa 2: ¿responde de forma estable?
Solicita la URL sin sesión iniciada y revisa código de estado, cadena de redirecciones, cabeceras y cuerpo de la respuesta. Un 200 puede servir un error blando con un mensaje de «no encontrado» dentro de una plantilla normal; un cortafuegos puede responder de forma distinta según el agente de usuario o el rango de IP; una caché puede seguir devolviendo una versión antigua horas después de un despliegue.
Repite la comprobación en dos planos siempre que exista acceso: contra el origen y contra la superficie pública, con y sin CDN. Si difieren, el problema está en la capa intermedia y no en el CMS. Conviene también hacer varias solicitudes separadas en el tiempo: una respuesta intermitente de 5xx no aparece en una única prueba y explica bastantes casos de descubrimiento interrumpido. Anota siempre la cabecera de caché observada y qué capa la emitió, porque «HIT» no significa lo mismo en todos los entornos.
Capa 3: ¿el buscador puede procesar la página?
Revisa robots.txt, la meta robots, la cabecera X-Robots-Tag, los recursos que la página necesita y el HTML inicial que devuelve el servidor. Una directiva de bloqueo en robots.txt impide el rastreo, y por eso impide también que se lea un noindex que esté dentro de la página: las dos instrucciones combinadas producen el efecto contrario al que se busca; es uno de los errores de robots.txt que más caros salen.
Si el contenido esencial solo aparece después de una ejecución de JavaScript, documenta la diferencia entre el HTML de origen y el resultado renderizado; el artículo sobre cuándo Google no ve tu contenido por depender del renderizado detalla esa comparación. No basta con que el navegador lo muestre; hay que saber qué queda si un script falla, si una petición a un tercero se agota o si un recurso está bloqueado. Comprueba además que hojas de estilo y scripts necesarios sean rastreables, porque una página que no se puede renderizar se evalúa con lo que quede visible. Y no utilices robots.txt como medida de protección: para eso están la autenticación y los controles de acceso del servidor.
Capa 4: ¿las señales coinciden?
Canonical, sitemap, enlaces internos, redirecciones y las anotaciones hreflang deben apuntar a la misma versión de la URL. Una página que se declara duplicada de otra, que recibe noindex o que redirige no debe analizarse como candidata normal a indexación: su estado ya está decidido por una señal propia del sitio.
Los conflictos más habituales son mecánicos y se detectan comparando pares. Canonical que apunta a la versión con barra final mientras los enlaces internos usan la versión sin barra. Sitemap que incluye URLs con noindex. Paginación cuyo canonical apunta siempre a la primera página. Versiones con y sin www, o con http y https, servidas ambas con 200. Parámetros de seguimiento que generan direcciones distintas para el mismo contenido. Cada una de esas contradicciones obliga al buscador a elegir, y la elección puede no ser la que espera el proyecto. El sitemap XML de WordPress ofrece una lista de coherencia útil para cruzar esas señales, y la etiqueta canonical reúne los casos que exigen contexto antes de decidir.
Capa 5: ¿la URL aporta una respuesta propia?
Una página perfectamente accesible puede no seleccionarse si repite lo que ya dice otra del mismo sitio, si está incompleta o si no resuelve ninguna tarea concreta. Compara intención, contenido y enlaces con las páginas propias que compiten por la misma consulta antes de mirar hacia fuera: la mayoría de los solapamientos son internos.
El estado «Rastreada: actualmente sin indexar» no es un diagnóstico automático de baja calidad. Es una señal que necesita contexto: puede acompañar a una página recién publicada, a una URL de paginación profunda, a una ficha con poco contenido propio o a un solapamiento con otra página del sitio. Antes de reescribir nada, comprueba si existe canibalización real y si el destino correcto para esa intención es otro. La guía sobre rastreo e indexación desarrolla por qué esa distinción evita conclusiones apresuradas.
El estado «Rastreada: actualmente sin indexar» no es un diagnóstico automático de baja calidad.
Estados de Search Console y su capa
El informe de indexación de páginas agrupa las URLs por motivo. Situar cada motivo en su capa evita empezar la investigación por el sitio equivocado.
| Estado | Capa | Primera comprobación |
|---|---|---|
| Descubierta: actualmente sin indexar | 1 y 2 | enlaces internos, profundidad y estabilidad de respuesta |
| Bloqueada por robots.txt | 3 | regla que casa con la URL y agente afectado |
| Excluida por la etiqueta noindex | 3 y 4 | origen de la directiva: plantilla, plugin o cabecera |
| Página alternativa con canónica adecuada | 4 | si la canónica elegida es la que el proyecto quiere |
| Duplicada: Google eligió otra canónica | 4 y 5 | contradicción entre señales y solapamiento de contenido |
| Rastreada: actualmente sin indexar | 5 | solapamiento interno, completitud y utilidad |
| Error de servidor (5xx) o soft 404 | 2 | respuesta del origen frente a la superficie pública |
Un mismo síntoma puede tener orígenes distintos, así que la columna de capa indica dónde empezar, no dónde terminar. Si la comprobación de esa capa sale limpia, se baja a la siguiente y se registra que la anterior quedó descartada con evidencia.
Salida del diagnóstico
La tabla final debe incluir URL, capa donde se detiene el problema, evidencia observada, hipótesis, nivel de confianza, acción propuesta y prueba que confirmará el resultado. Sin la columna de prueba, el informe no permite saber más adelante si la acción funcionó o si el cambio coincidió con otra cosa.
El nivel de confianza importa más de lo que parece. Un bloqueo por robots.txt es una causa verificable y admite confianza alta. Un solapamiento de intención es una hipótesis razonable que solo se confirma observando qué ocurre después del cambio. Mezclar ambos con el mismo grado de certeza produce informes que prometen resultados que nadie puede sostener. El servicio de SEO técnico puede implementar los cambios; la auditoría SEO ordena las incidencias cuando son muchas y compiten por el mismo tiempo de desarrollo.
En cuatro láminas
5 capas, en orden. Una capa superior sin resolver invalida cualquier conclusión sobre las inferiores.
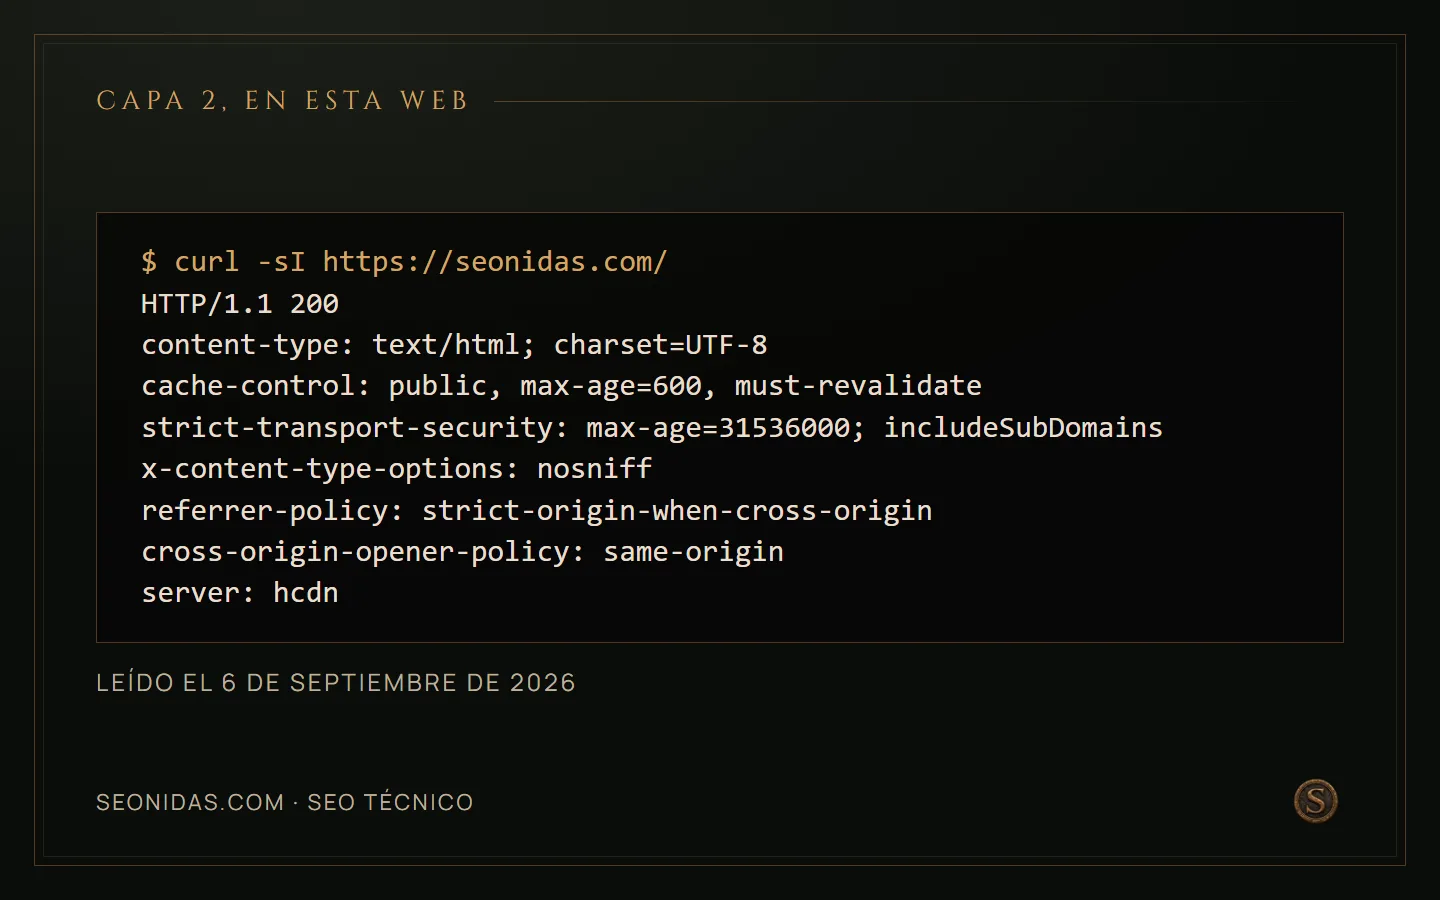
curl -sI https://seonidas.com/. HTTP/1.1 200 / content-type: text/html; charset=UTF-8 / cache-control: public, max-age=600, must-revalidate / strict-transport-security: max-age=31536000; includeSubDomains / x-content-type-options: nosniff / referrer-policy: strict-origin-when-cross-origin / cross-origin-opener-policy: same-origin / server: hcdn. Leído el 10 de septiembre de 2026.
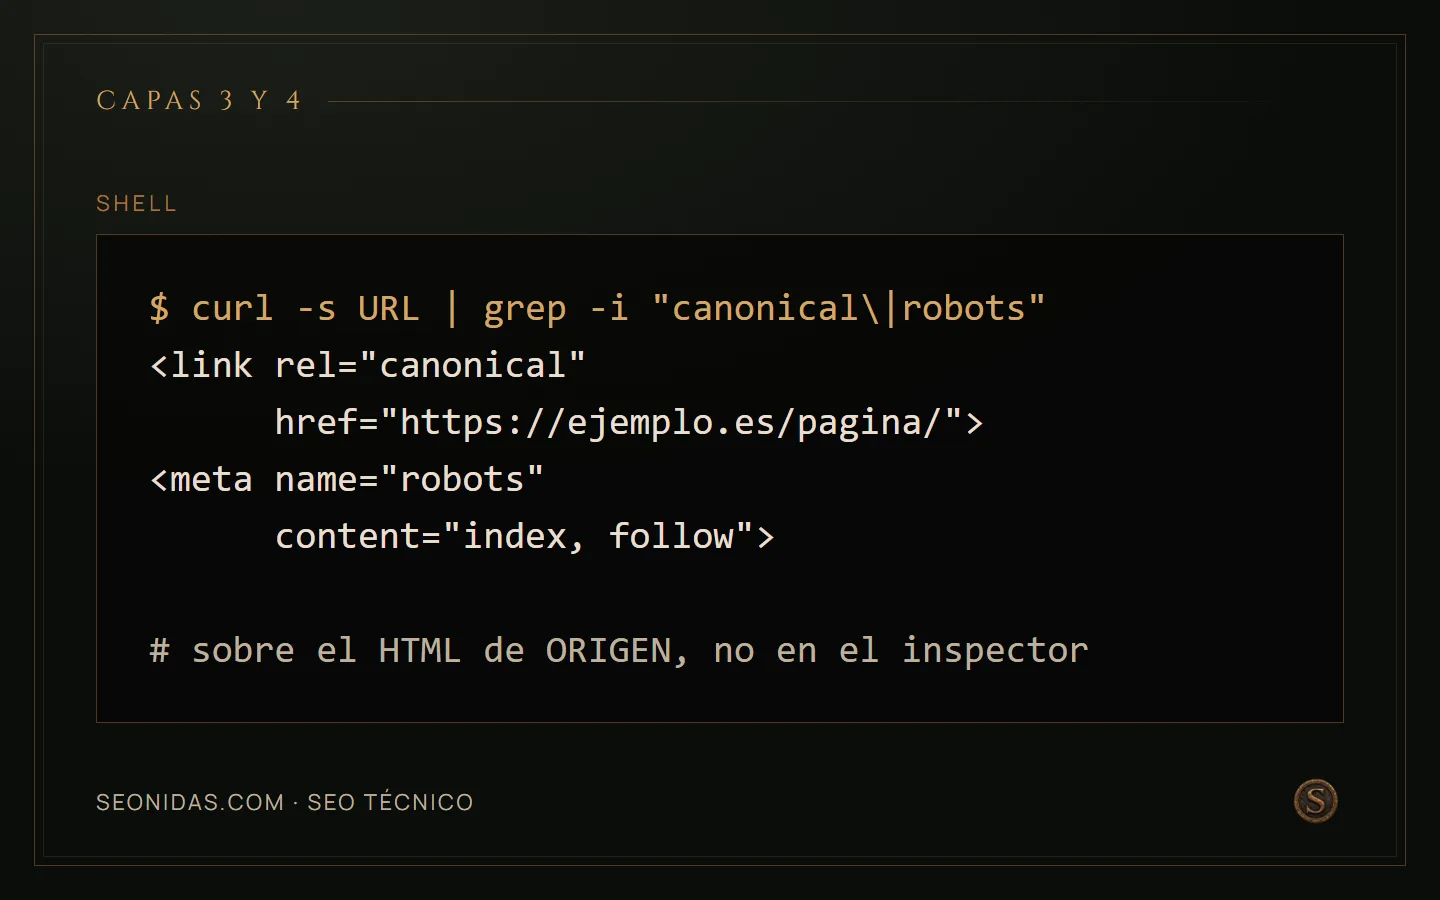
shell: $ curl -s URL | grep -i "canonical\|robots" / <link rel="canonical" / href="https://ejemplo.es/pagina/"> / <meta name="robots" / content="index, follow"> / / # sobre el HTML de ORIGEN, no en el inspector
Errores frecuentes
- Solicitar indexación manualmente en bucle sin haber tocado la causa: la petición no sustituye a la corrección.
- Añadir
noindexa una URL ya bloqueada enrobots.txt, con lo que la directiva nunca llega a leerse. - Interpretar «Rastreada: actualmente sin indexar» como sentencia de calidad y reescribir textos antes de revisar canonicalización.
- Probar solo desde el navegador con sesión iniciada y no ver la respuesta que recibe un cliente anónimo.
- Dar por buena una única comprobación cuando el fallo es intermitente.
- Incluir en el sitemap URLs que el propio sitio excluye por otra vía.
- Atribuir a un cambio reciente lo que empezó semanas antes por no tener fecha de referencia.
Preguntas habituales
¿Sirve pedir la indexación a mano una y otra vez?
La petición pone la URL en cola; no corrige lo que impide indexarla. Si la causa sigue ahí —un bloqueo, un canonical que apunta a otra página, una respuesta inestable—, el resultado será el mismo tras cada solicitud. Primero se cierra la capa que falla con evidencia; la petición va después, y una vez.
«Rastreada: actualmente sin indexar», ¿significa que el contenido es malo?
Es una pista, no un diagnóstico cerrado. Ese estado aparece también con plantillas casi idénticas, señales de canonicalización que no coinciden o URLs que el propio sitio no enlaza. Reescribir los textos antes de revisar las capas anteriores es el orden equivocado: si una capa superior falla, cualquier conclusión sobre la calidad es prematura.
¿Bloquear una URL en robots.txt la saca de los resultados?
No. Impide descargarla, que es otra cosa: la URL puede seguir apareciendo listada, y además el bloqueo impide leer la etiqueta noindex que sí la retiraría. Para sacar una página se deja rastreable con noindex, o se protege de verdad si el contenido es privado; robots.txt nunca es un control de acceso.
¿Cuánto hay que esperar antes de concluir que algo va mal?
Lo suficiente para que la comprobación sea comparable, y con una fecha de referencia anotada. Muchos diagnósticos se estropean por una única comprobación cuando el fallo es intermitente, o por atribuir a un cambio reciente algo que empezó semanas antes. Sin fecha de partida no hay forma de saber cuál de las dos cosas ocurre.
Próximo paso
Elige entre cinco y diez URLs representativas de los tipos de página que preocupan, no la lista completa. Recórrelas por capas en orden, anota la evidencia de cada nivel y detén el análisis en la primera capa que falle. Con ese material ya se puede decidir si el problema es de arquitectura, de configuración de servidor, de señales contradictorias o de contenido, y cada uno de esos cuatro caminos lleva a un plan distinto.
Si además se observa una pérdida de rendimiento en el tiempo y no solo URLs sin indexar, conviene separar los dos análisis: diagnosticar una caída en Search Console describe cómo delimitar el periodo y el segmento antes de atribuir causas.
Fuentes
- Google Search Console, informe de indexación de páginas — documentación oficial.
- Google Search Console, herramienta de inspección de URLs — documentación oficial.
- Google Search Central, introducción a robots.txt — documentación oficial.
- Google Search Central, consolidar URLs duplicadas — documentación oficial.
Servicio y herramienta relacionados
Si esto es lo que te está pasando, seo técnico es el trabajo que lo resuelve. Diagnóstico primero, prioridades después.
Y para hacerlo tú: el generador de meta robots sirve para componer la etiqueta con las directivas que necesitas y ver qué hace cada una. Funciona en tu navegador y no envía tus datos a ningún sitio.
Escrito por
Jesús Iturbide
Consultor SEO técnico · SEONIDAS
Diagnóstico, priorización e implementación SEO en WordPress y PrestaShop. Servicio prestado íntegramente en línea desde Villava, Navarra.
jesusiturbide.comHablemos
¿Tu web tiene un problema de rastreo, indexación o rendimiento que nadie te explica? Cuéntamelo: te respondo en 24 horas laborables con una primera lectura del caso.
Abrir consultaEn esta página
- Respuesta breve
- Puntos clave
- Capa 1: ¿la URL existe y se descubre?
- Capa 2: ¿responde de forma estable?
- Capa 3: ¿el buscador puede procesar la página?
- Capa 4: ¿las señales coinciden?
- Capa 5: ¿la URL aporta una respuesta propia?
- Estados de Search Console y su capa
- Salida del diagnóstico
- En cuatro láminas
- Errores frecuentes
- Preguntas habituales
- Próximo paso
- Fuentes