SEO técnico
robots.txt: los errores que bloquean justo lo que importa
Publicado el
En esta página
- Respuesta breve
- Puntos clave
- Lo que robots.txt hace y lo que no
- Dónde vive el fichero y a qué afecta
- Los errores que más caro salen
- Bloquear recursos y romper el renderizado
- robots.txt no es un control de acceso
- Reglas por agente y precedencia
- Procedimiento de verificación
- En cuatro láminas
- Errores frecuentes
- Preguntas habituales
- Próximo paso
- Fuentes
Respuesta breve
El fichero robots.txt controla el rastreo, no la indexación. Bloquear una URL impide que se descargue, pero no garantiza que desaparezca de los resultados, y además impide leer la etiqueta noindex que sí la sacaría. Los errores más caros no son las reglas exóticas, sino las cotidianas: una barra de más, un bloqueo de recursos que rompe el renderizado o el fichero de preproducción publicado en producción.
Puntos clave
- Rastreo e indexación son cosas distintas:
robots.txtsolo actúa sobre la primera. - Bloquear una URL y ponerle
noindexa la vez es contradictorio: la etiqueta no se llega a leer. - El fichero vive en la raíz del host y aplica a ese host, esquema y puerto.
- Un bloqueo de CSS o JavaScript puede impedir que la página se procese como la ve el usuario.
- No es un mecanismo de seguridad: lo que se bloquea sigue siendo público y queda listado.
- Toda regla se comprueba contra URLs reales antes y después de publicar.
Lo que robots.txt hace y lo que no
Hace
- Impide que se descargue una URL
- Aplica a su host, esquema y puerto
- Se lee por agente, con precedencia entre grupos
No hace
- Sacar una página de los resultados
- Dejar que se lea un noindex en una URL bloqueada
- Proteger nada: lo listado sigue siendo público
- Cubrir subdominios ni el entorno de pruebas
Lo que robots.txt hace y lo que no
La confusión de fondo consiste en tratar el fichero como un interruptor de visibilidad. Su función es indicar a los rastreadores que respetan el protocolo qué rutas no deben solicitar. La introducción oficial de Google lo plantea como una herramienta de gestión del tráfico de rastreo, y esa distinción tiene consecuencias prácticas.
Una URL bloqueada puede aparecer en los resultados si otras páginas la enlazan, porque el enlace basta para conocer su existencia aunque el contenido no se haya descargado. El resultado es una entrada sin descripción útil, que es exactamente lo contrario de lo que se buscaba al bloquearla.
Para que una página no aparezca, la herramienta es la etiqueta noindex o la cabecera equivalente, documentadas en la guía de bloqueo de indexación. Y aquí está la contradicción que se repite en auditoría tras auditoría: si la URL está bloqueada en robots.txt, la etiqueta no puede leerse, porque leerla exige descargar la página. Las dos medidas juntas se anulan. La diferencia entre ambos planos está desarrollada en el artículo sobre rastreo e indexación.
Dónde vive el fichero y a qué afecta
El fichero debe estar en la raíz del host y se aplica a ese host concreto. Un robots.txt en el dominio principal no gobierna un subdominio: la tienda, el blog alojado aparte o el entorno de pruebas necesitan el suyo. El esquema y el puerto también forman parte de esa identidad.
De ahí sale un error clásico: el sitio migra a HTTPS y el fichero se sirve solo en la versión antigua, o el subdominio de preproducción se queda sin bloqueo y termina rastreado e indexado en paralelo al sitio real. La comprobación es directa, y consiste en pedir el fichero en cada combinación de esquema y host que responda, no solo en la canónica.
En WordPress, la pregunta de dónde está el archivo tiene truco. Si en la raíz del alojamiento no hay un robots.txt físico, WordPress responde en esa dirección con uno virtual que genera él mismo. Si hay un fichero real en la raíz, el servidor lo entrega antes de que WordPress intervenga y la versión virtual deja de tener efecto, también lo que se le haya añadido desde un plugin. Para saber cuál manda, se pide /robots.txt en el navegador y se compara con lo que se esperaba ver.
Google documenta además el comportamiento ante fallos, y conviene conocerlo porque cambia con el tiempo. Si no puede obtener una versión nueva del fichero, durante los treinta días siguientes utiliza la última copia buena que tenga; si los errores continúan después de ese plazo, el comportamiento cambia. También indica que la respuesta se cachea normalmente hasta veinticuatro horas, lo que explica que un cambio no surta efecto de inmediato.
Otra consecuencia del mismo mecanismo: un 4xx distinto de 429 se interpreta como si no existiera fichero, es decir, sin restricciones de rastreo. Un error del servidor en la ruta del robots.txt no es, por tanto, un detalle menor.
Los errores que más caro salen
La mayoría de incidentes graves proceden de un puñado de patrones repetidos, no de reglas sofisticadas.
| Error | Qué ocurre | Cómo se detecta |
|---|---|---|
Disallow: / heredado de preproducción | se bloquea el sitio entero | lectura del fichero en producción tras cada despliegue |
| Bloqueo de CSS o JavaScript | la página no se procesa como la ve el usuario | prueba de renderizado en Search Console |
| Bloqueo del sitemap o de sus URLs | se envían URLs que no se pueden descargar | contraste entre sitemap y reglas |
Disallow con prefijo demasiado amplio | arrastra rutas legítimas que empiezan igual | prueba con lista de URLs reales |
Bloqueo más noindex en la misma URL | la etiqueta nunca se lee | cruce de reglas y cabeceras |
| Fichero ausente en un subdominio | preproducción accesible al rastreo | petición por host, no solo al principal |
El caso del prefijo demasiado amplio merece detenimiento porque es silencioso. Las reglas funcionan por prefijo de ruta: bloquear /print alcanza también a cualquier ruta que empiece por esa cadena, aunque no tuviera relación con la intención original. Cuando la ruta bloqueada coincide con el comienzo de una sección legítima, el bloqueo se lleva por delante contenido que nadie quería tocar, y no hay ningún aviso.
Bloquear recursos y romper el renderizado
Impedir el acceso a hojas de estilo, scripts o imágenes fue durante años una práctica para ahorrar rastreo. Hoy es contraproducente, porque el procesamiento de la página necesita esos recursos para reconstruir lo que ve el usuario. Si la hoja de estilos está bloqueada, la evaluación se hace sobre una versión que no se corresponde con la real.
El síntoma típico es una discrepancia entre lo que muestra el navegador y lo que devuelve la prueba de URL de Search Console: contenido que no aparece, diseño roto o menús vacíos. Antes de buscar causas complejas conviene revisar si el bloqueo procede del propio robots.txt, de una regla heredada del CDN o de un directorio de assets bloqueado por costumbre. Cuando el contenido depende además de la ejecución de scripts, conviene separar las dos causas posibles: que el recurso esté bloqueado o que la ejecución falle por su cuenta.
robots.txt no es un control de acceso
El fichero es público y legible por cualquiera. Listar en él las rutas de administración, las carpetas privadas o los directorios de copias de seguridad es publicar un índice de lo que se quiere esconder. Quien busque esas rutas empezará precisamente por ahí.
Lo que no debe ser accesible se protege con autenticación, permisos y configuración del servidor. El protocolo, formalizado en el RFC 9309, describe una convención voluntaria: los rastreadores que la respetan la cumplen, y los que no la respetan simplemente la ignoran. Esa distinción es relevante cuando se trata de rastreadores de sistemas de IA, cuyo comportamiento y verificación se analizan en la matriz de crawlers de IA.
Reglas por agente y precedencia
Un fichero puede contener bloques para distintos agentes. Un rastreador aplica el grupo más específico que coincide con su nombre, y si existe un bloque propio, el genérico deja de aplicársele por completo. De ahí un fallo habitual: se añade un bloque específico para un agente con dos líneas y, sin querer, ese agente pierde todas las reglas generales que sí debía cumplir.
- escribe un bloque genérico completo y trata cada bloque específico como una configuración independiente, no como un añadido;
- recuerda que una regla
Allowmás específica puede prevalecer sobre unDisallowmás amplio; - comprueba mayúsculas y minúsculas en las rutas cuando el servidor distingue entre ellas;
- declara el sitemap con URL absoluta;
- usa codificación UTF-8, porque Google advierte que puede ignorar caracteres fuera de ese rango y con ellos la regla completa;
- evita directivas obsoletas o no soportadas y no supongas que se cumplen porque no dan error;
- mantén el fichero corto y comentado: la longitud dificulta el mantenimiento y existe un límite de tamaño procesado.
Procedimiento de verificación
Un cambio en este fichero afecta a todo el sitio a la vez, así que la verificación no es opcional ni puede hacerse a ojo sobre el texto de las reglas.
- guarda el fichero en control de versiones y revisa cada cambio como código;
- prepara una lista de URLs de referencia que deben ser rastreables y otra de las que no;
- prueba ambas listas contra el fichero nuevo antes de publicarlo;
- publica y vuelve a pedir el fichero desde fuera de la red, para comprobar qué sirve el CDN;
- usa la prueba de URL de Search Console sobre una muestra de plantillas y revisa el renderizado;
- vigila durante los días siguientes el informe de páginas, buscando aumentos en las URLs bloqueadas;
- si el bloqueo era el objetivo, confirma que la URL deja de rastrearse y no solo que dejó de aparecer.
Cuando una página que debería estar visible desaparece, este fichero es una de las primeras capas que hay que descartar, junto con la etiqueta robots, el canonical y el estado del servidor. Ese recorrido por capas está ordenado en el artículo sobre por qué Google no indexa una web.
Un cambio en este fichero afecta a todo el sitio a la vez, así que la verificación no es opcional ni puede hacerse a ojo sobre el texto de las reglas.
En cuatro láminas
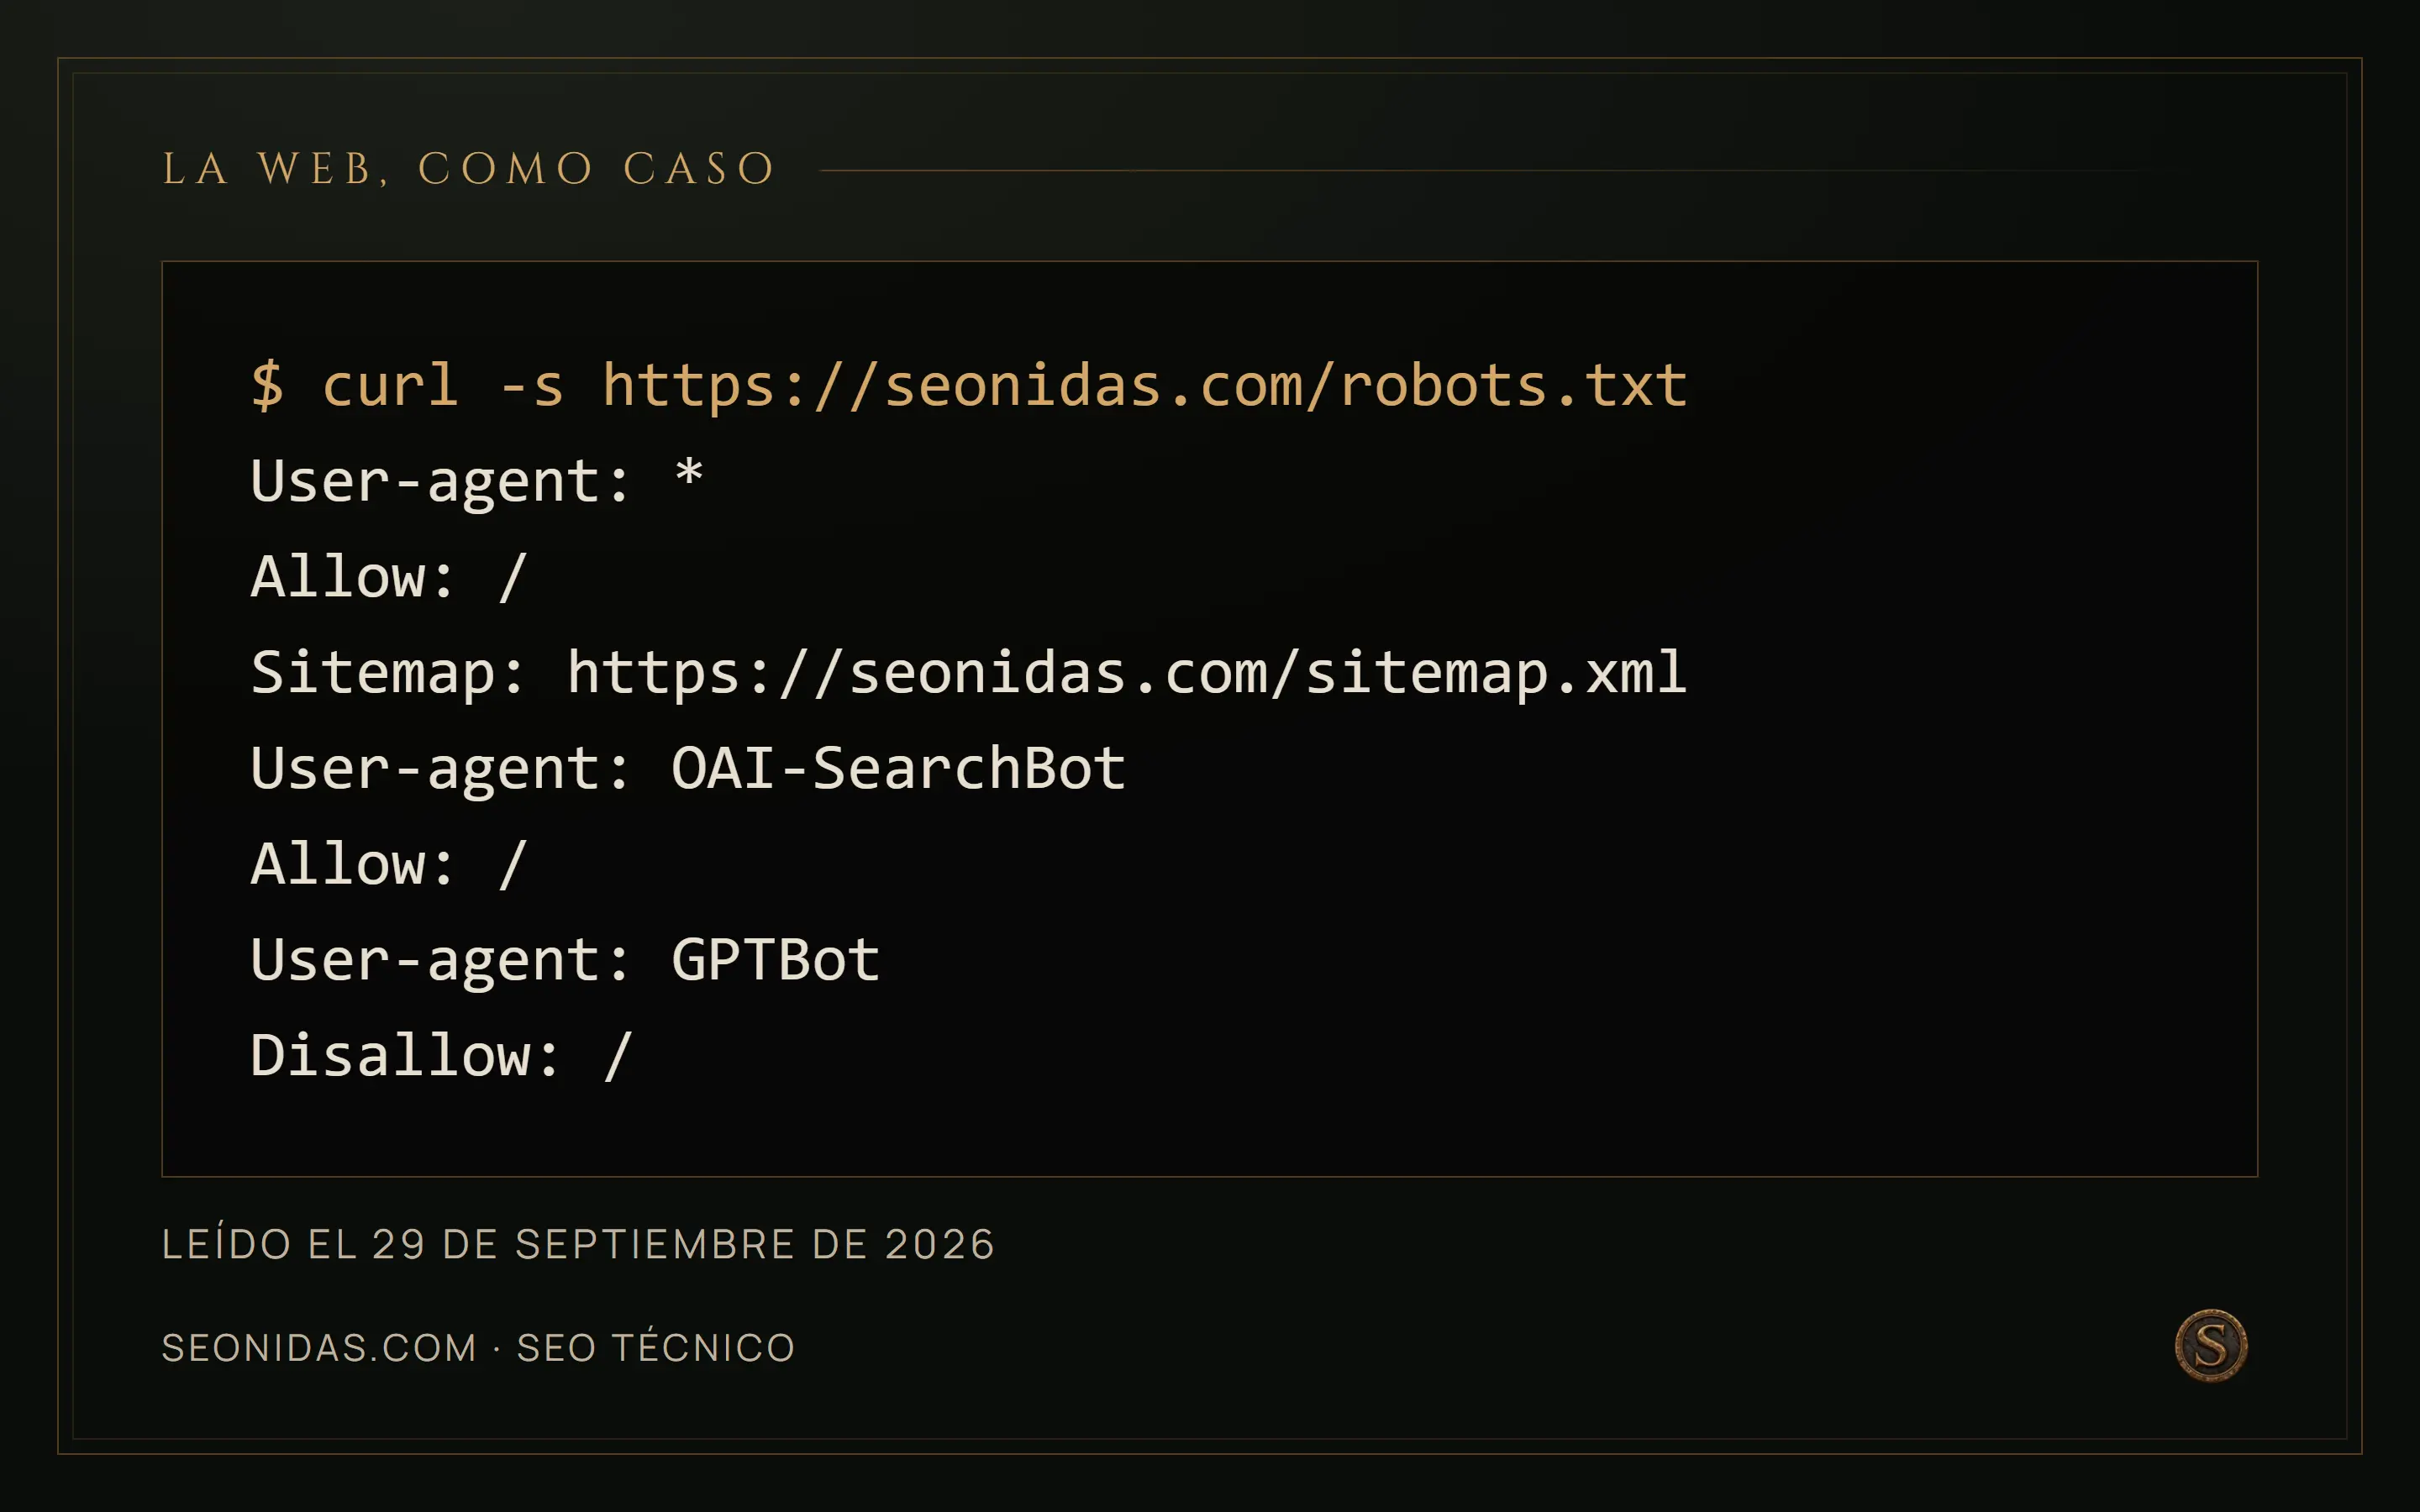
curl -s https://seonidas.com/robots.txt. User-agent: * / Allow: / / Sitemap: https://seonidas.com/sitemap.xml / User-agent: OAI-SearchBot / Allow: / / User-agent: GPTBot / Disallow: /. Leído el 28 de septiembre de 2026.
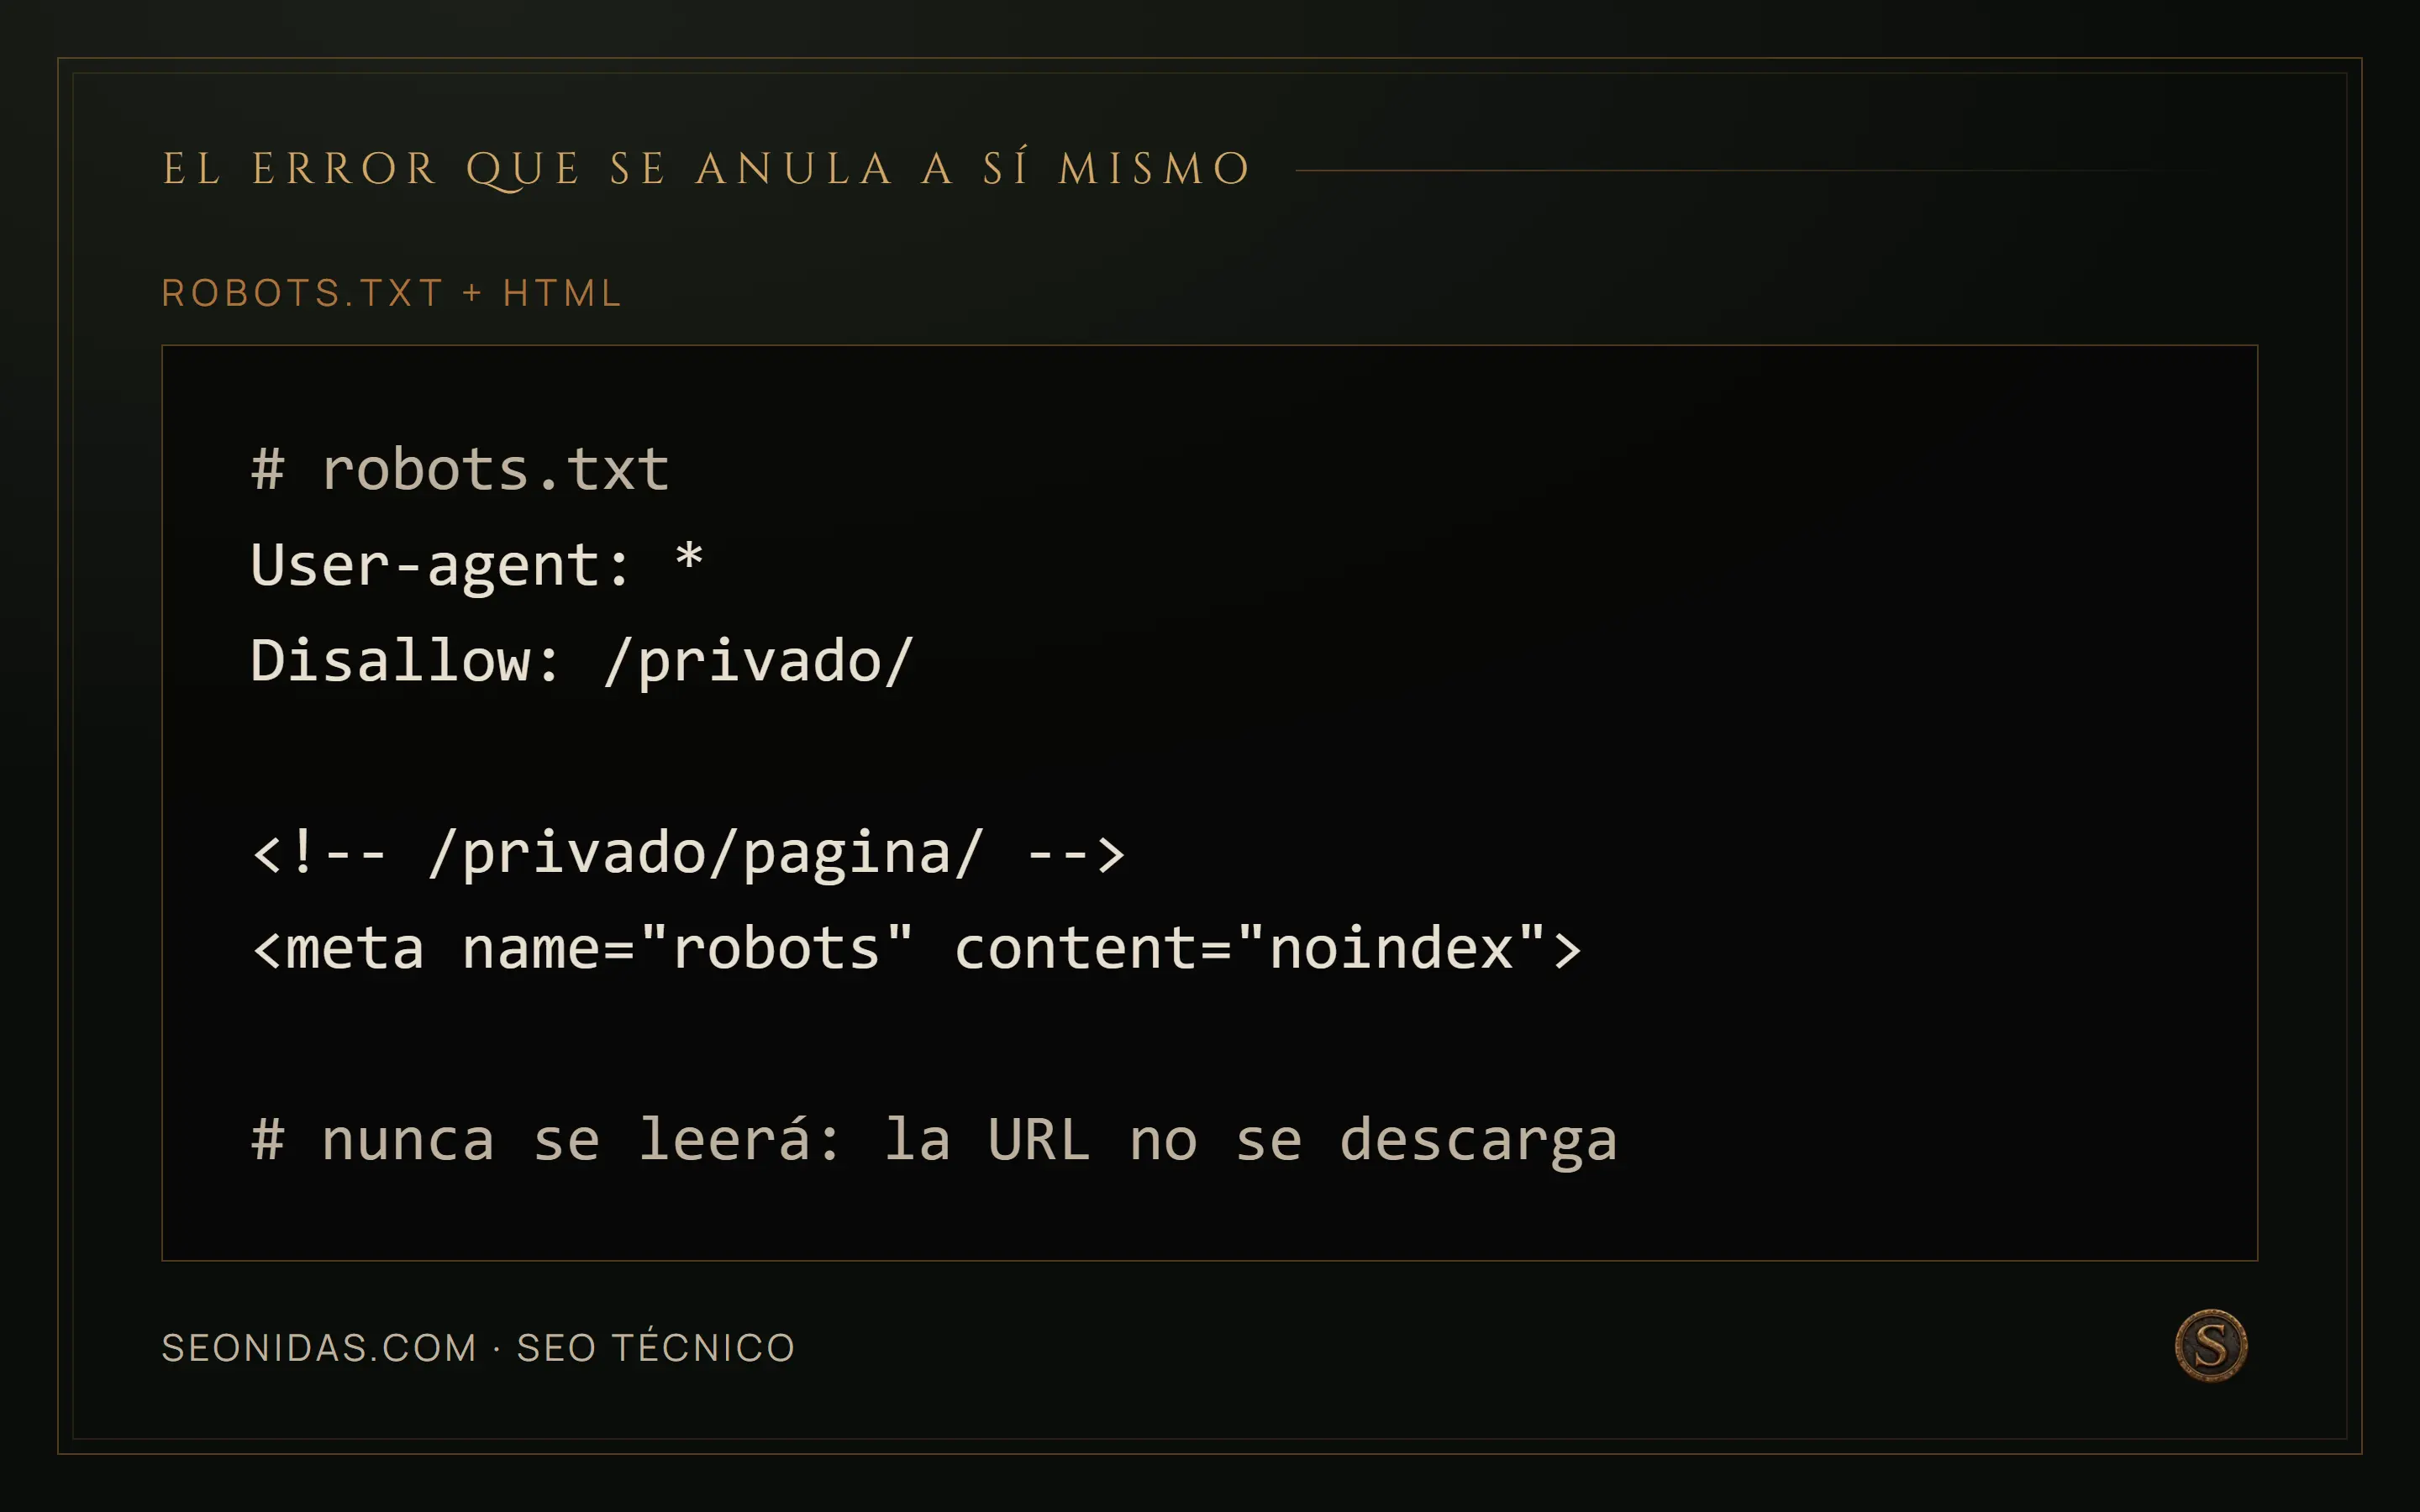
robots.txt + HTML: # robots.txt / User-agent: * / Disallow: /privado/ / / <!-- /privado/pagina/ --> / <meta name="robots" content="noindex"> / / # nunca se leerá: la URL no se descarga
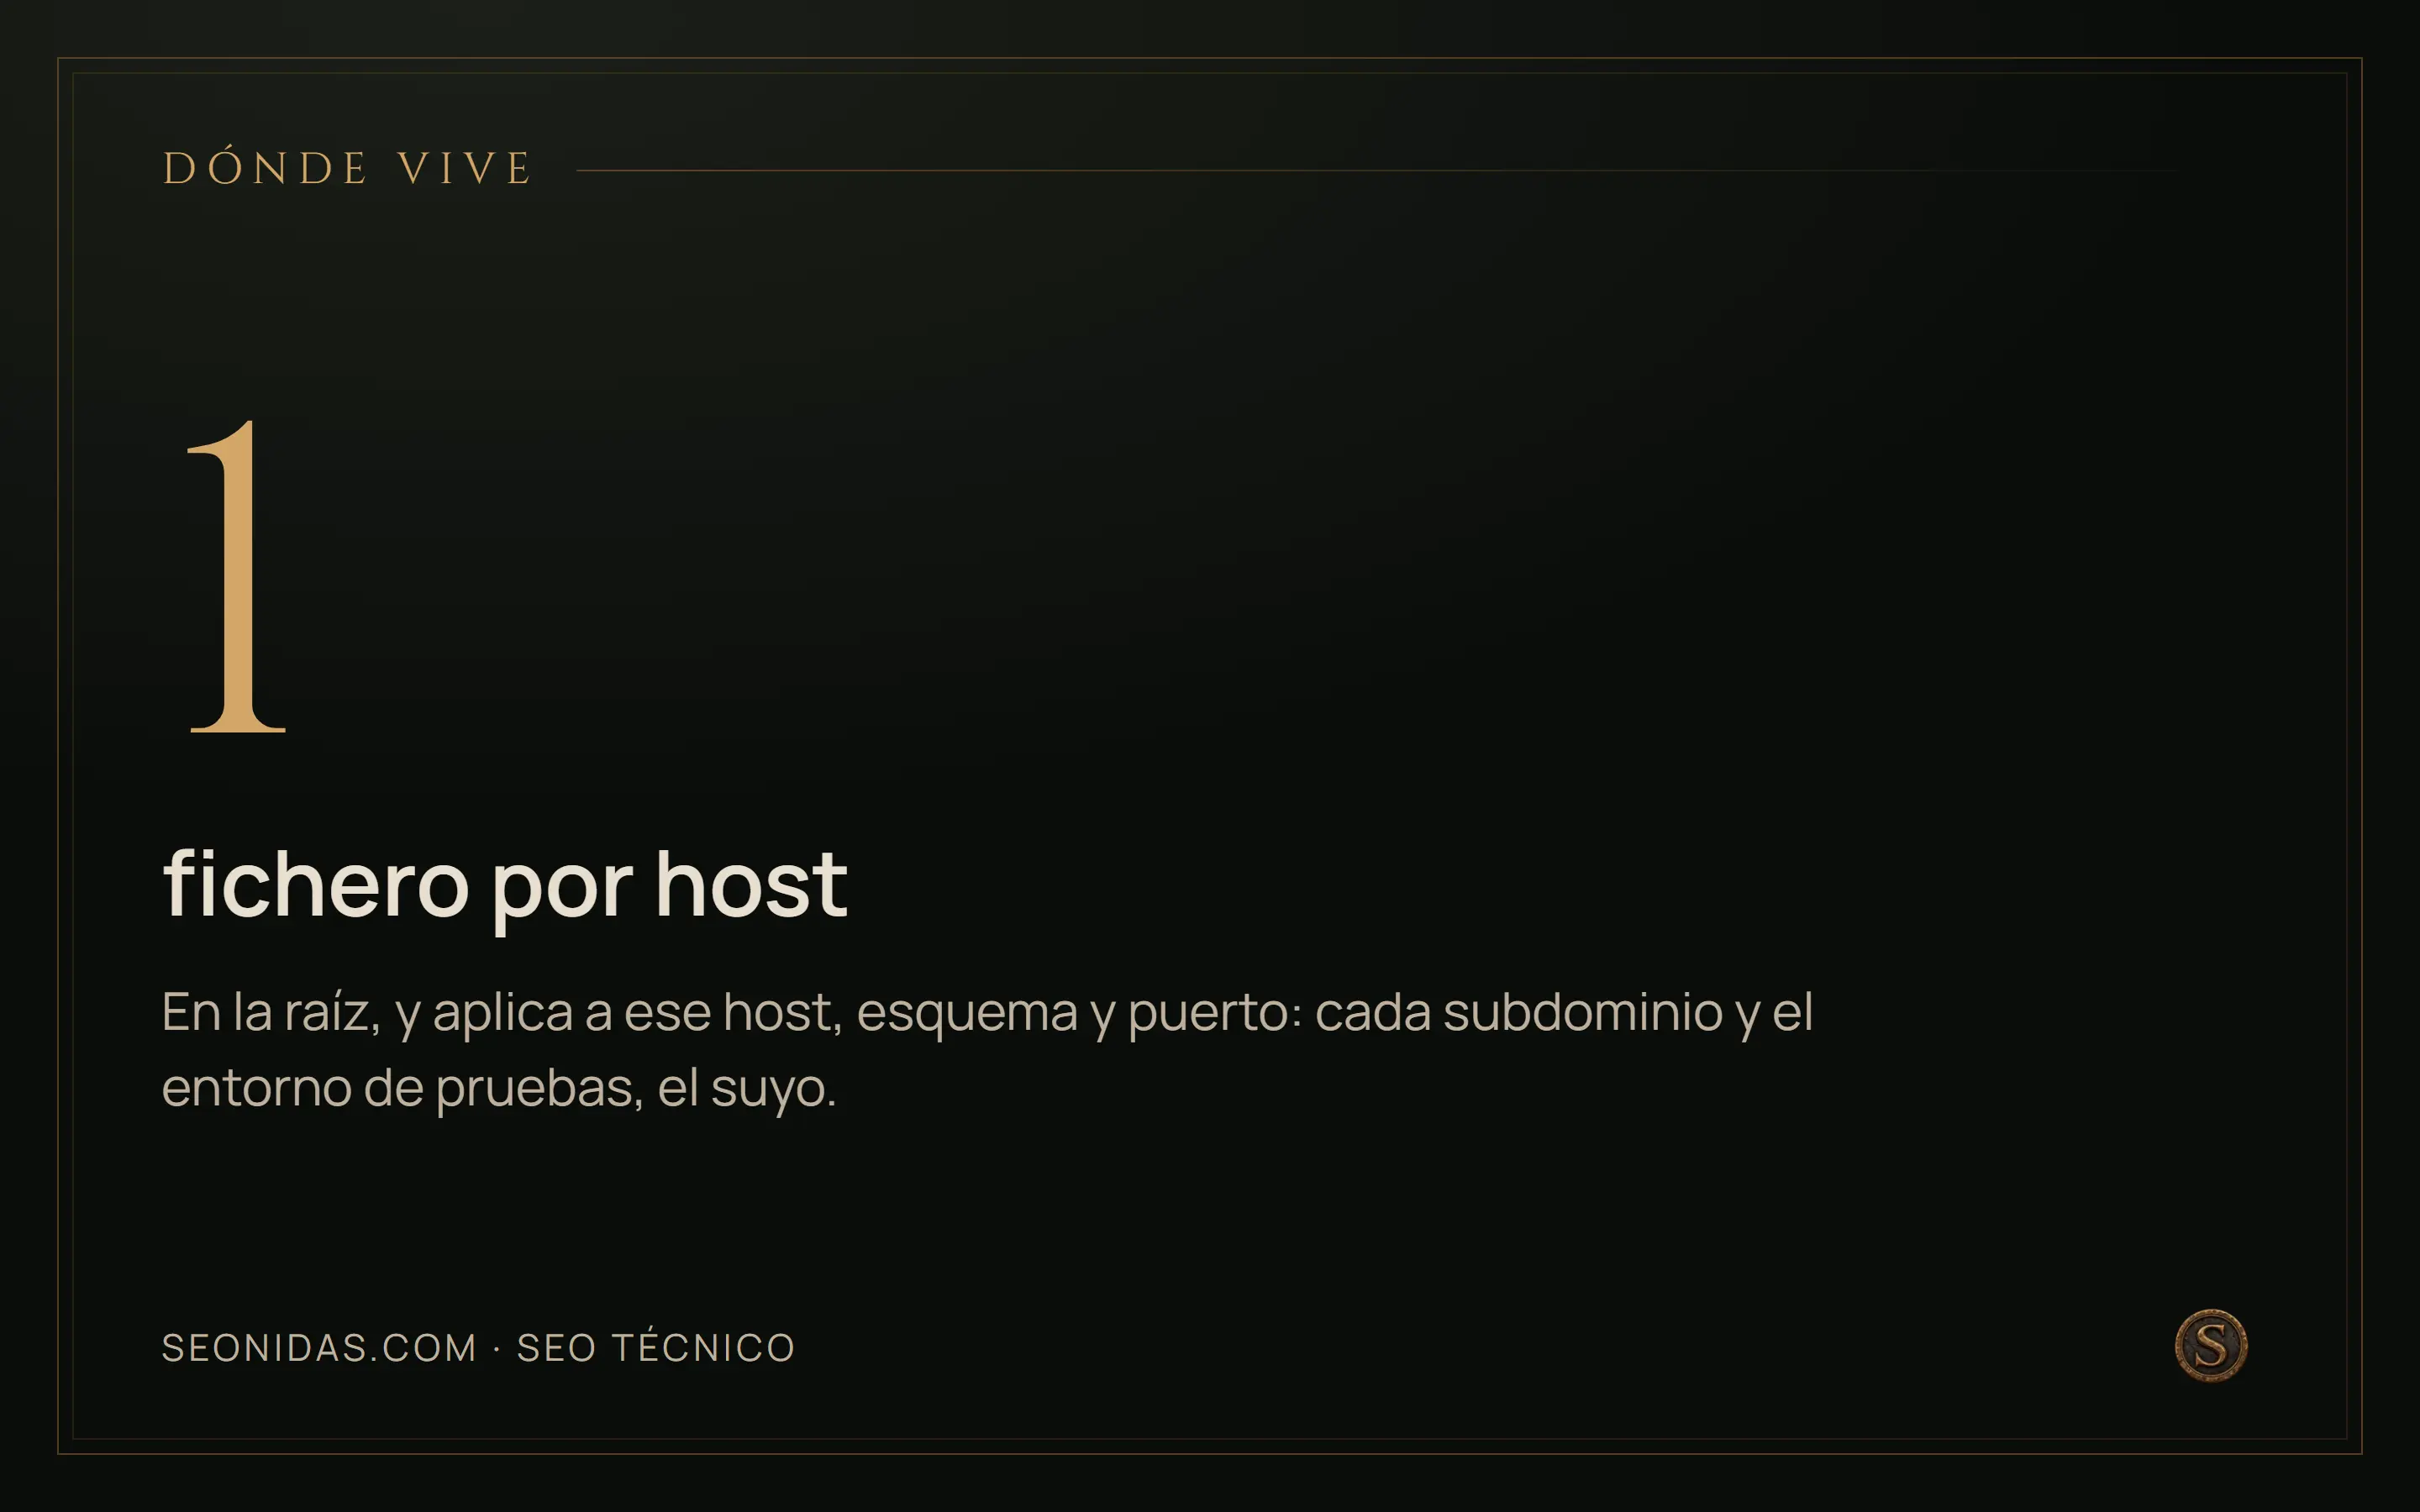
1 fichero por host. En la raíz, y aplica a ese host, esquema y puerto: cada subdominio y el entorno de pruebas, el suyo.
Errores frecuentes
- Publicar en producción el
robots.txtde preproducción conDisallow: /. - Bloquear una URL y esperar que desaparezca de los resultados.
- Combinar bloqueo y
noindexen la misma URL. - Bloquear CSS, JavaScript o imágenes necesarios para el renderizado.
- Olvidar el fichero en subdominios y en el entorno de pruebas.
- Escribir un prefijo que arrastra rutas legítimas sin comprobarlo.
- Añadir un bloque por agente y perder con ello las reglas generales.
- Listar rutas sensibles y convertir el fichero en un índice de lo privado.
- Bloquear URLs que están incluidas en el sitemap.
- Editar el fichero directamente en producción sin control de versiones.
Preguntas habituales
¿robots.txt sirve para desindexar una página?
No: controla el rastreo, no la indexación. Bloquear una URL impide descargarla, pero puede seguir apareciendo listada en los resultados, y además impide leer la etiqueta noindex que sí la retiraría. Para sacar una página se deja rastreable con noindex hasta que desaparezca, y solo entonces se valora bloquearla.
¿Puedo poner Disallow y noindex a la vez en la misma URL?
Es contradictorio y el resultado es el contrario del buscado. El bloqueo impide descargar la página, así que la etiqueta noindex que lleva dentro no llega a leerse nunca. Es uno de los errores que más tiempo sobreviven, porque las dos medidas parecen reforzarse y en realidad se anulan.
¿Sirve robots.txt para proteger algo privado?
No es un mecanismo de seguridad: el fichero es público y lo que se lista en él queda a la vista de cualquiera. Bloquear una ruta sensible convierte el fichero en un índice de lo privado. Lo que no debe ser accesible se protege con autenticación o permisos del servidor, no con una directiva de rastreo.
¿Un robots.txt vale para todos mis subdominios?
No. El fichero vive en la raíz del host y aplica a ese host, esquema y puerto. Un subdominio necesita el suyo, y el entorno de pruebas también: publicar en producción el robots.txt de preproducción con Disallow para todo es uno de los accidentes más caros y más difíciles de ver desde dentro.
Próximo paso
Pide el robots.txt de cada host y esquema que responda en el proyecto, incluidos subdominios y entornos de pruebas, y contrasta las reglas con una lista de URLs que deban ser rastreables. Si alguna regla bloquea contenido que sí debe verse, corrígela antes de tocar nada más: mientras el rastreo esté bloqueado, ninguna otra optimización se puede evaluar.
Fuentes
- Google Search Central, introducción a robots.txt — documentación oficial.
- Google Search Central, cómo interpreta Google la especificación de robots.txt: errores del servidor, caché, codificación, tamaño y precedencia entre grupos y reglas — documentación oficial.
- Google Search Central, bloquear la indexación con noindex — documentación oficial.
- WordPress Developer Resources, función
do_robots(): el robots.txt virtual que genera WordPress cuando no hay fichero físico — documentación oficial. - IETF, RFC 9309, Robots Exclusion Protocol (2022) — norma publicada.
Servicio y herramienta relacionados
Si esto es lo que te está pasando, seo técnico es el trabajo que lo resuelve. Diagnóstico primero, prioridades después.
Y para hacerlo tú: el generador de meta robots sirve para componer la etiqueta con las directivas que necesitas y ver qué hace cada una. Funciona en tu navegador y no envía tus datos a ningún sitio.
Escrito por
Jesús Iturbide
Consultor SEO técnico · SEONIDAS
Diagnóstico, priorización e implementación SEO en WordPress y PrestaShop. Servicio prestado íntegramente en línea desde Villava, Navarra.
jesusiturbide.comHablemos
¿Tu web tiene un problema de rastreo, indexación o rendimiento que nadie te explica? Cuéntamelo: te respondo en 24 horas laborables con una primera lectura del caso.
Abrir consulta