GEO e IA
Matriz de crawlers de IA: robots, WAF y verificación
Publicado el
En esta página
Respuesta breve
Una matriz de crawlers de IA es el inventario que documenta, para cada agente declarado, qué función le atribuye su proveedor, qué regla recibe en robots.txt, qué política se le aplica en el WAF o el CDN, qué se ha observado en los registros del servidor y con qué grado de certeza se ha verificado su identidad. No es una lista de permitidos y bloqueados: es un registro con fuente primaria, fecha, propietario de la decisión y estado de verificación, porque la documentación de los proveedores cambia y un user-agent declarado nunca prueba por sí solo quién hizo la petición.
Puntos clave
- La decisión se toma una vez y se aplica en varias capas. Si discrepan, la política real es la que ejecuta la red, no la escrita.
- Un user-agent es una cadena que el cliente elige. Solo los rangos publicados o la resolución inversa autorizada aumentan la confianza, nunca hasta la certeza.
- Impedir el rastreo no equivale a impedir la indexación ni retira lo ya recogido.
- Cada fila necesita fuente primaria fechada, propietario de la decisión y fecha de próxima revisión.
- Los estados útiles son documentado, configurado, observado, no verificado y bloqueado por acceso; mezclarlos convierte la matriz en una opinión.
- Los registros se conservan con los campos mínimos y sin URLs con datos personales.
- Un cambio en la documentación del proveedor abre una revisión, no un despliegue.
Una decisión, varias capas
- robots.txtLo que se pide a quien lo respeta; no autentica ni protege.
- WAF y CDNLo que se impone: por IP y comportamiento, no por user-agent.
- AplicaciónLo que la web sirve a cada agente.
- LogsLo que de verdad ocurrió, con campos mínimos y sin datos personales.
- ValidaciónDocumentado, configurado, observado, no verificado o bloqueado.
Qué problema resuelve la matriz
El problema no es decidir si un agente entra: es que esa decisión se toma una vez, se implementa en tres o cuatro sitios distintos y después nadie recuerda dónde quedó escrita ni por qué. Meses más tarde alguien añade una regla en el WAF para frenar un pico, otra persona ajusta robots.txt durante una migración y la política declarada deja de coincidir con la aplicada.
La matriz existe para que esa deriva sea visible: su unidad no es el agente, sino la decisión sobre el agente. Y separa dos preguntas que se confunden: el rastreo, si el agente puede pedir el recurso, y el uso, qué hace el proveedor con lo que obtiene. Un bloqueo técnico no cambia unas condiciones de uso.
Campos de la matriz
- agente y propósito;
- documentación oficial y fecha;
- control mediante robots;
- decisión del propietario;
- política WAF/CDN;
- rangos o verificación actualizable;
- logs y retención;
- prueba de acceso o bloqueo;
- owner y fecha de revisión.
Ninguno es decorativo. Agente y propósito guarda la cadena exacta de user-agent y el uso que le atribuye su proveedor: rastreo para índice, recuperación durante una consulta del usuario o recogida para entrenamiento. Son funciones distintas y merecen decisiones distintas. Una fuente sin fecha no es verificable, y sin owner la fila queda huérfana.
La guía de OAI-SearchBot, GPTBot y ChatGPT-User muestra por qué el propósito no puede rellenarse por intuición: son tres agentes del mismo proveedor con funciones diferentes, y tratarlos como uno produce decisiones incoherentes. Según la documentación para editores y desarrolladores de OpenAI, cada uno se controla por separado.
Una fuente sin fecha no es verificable, y sin owner la fila queda huérfana.
Robots
Genera una única respuesta y comprueba host, sitemap y reglas generales. No bloquees recursos públicos necesarios. Staging se protege con autenticación, no solo con Disallow. Si una página lleva noindex, debe poder rastrearse para procesar la directiva.
Esa última regla concentra el error más caro del fichero. robots.txt controla la solicitud, no el índice: al prohibir el rastreo de una URL ya indexada, el buscador deja de leer la página y con ella el noindex que la retiraría. Hay que permitir el rastreo hasta que la directiva se procese y solo después considerar el bloqueo. El segundo punto de fricción es la especificidad: un agente que encuentra un grupo con su nombre ignora por completo el genérico *, de modo que un bloque específico con un Disallow parcial concede todo lo demás. El artículo sobre rastreo e indexación desarrolla esa separación.
WAF y CDN
Un WAF puede verificar rangos oficiales y comportamiento, pero la lista cambia. Mantén configuración como código o inventario con fecha, sin publicar secretos. Evita una allowlist que salte controles de aplicación. Una petición del bot sigue sin acceder a admin o datos privados.
Es la capa donde la política declarada se rompe más a menudo, porque sus reglas se escriben bajo presión operativa: ante un pico de peticiones alguien añade un límite por tasa o un reto de navegador, resuelve el incidente y la regla sobrevive sin haber sido evaluada como política. Los retos interactivos merecen atención propia: un agente automatizado no resuelve un desafío pensado para un navegador con persona delante y desde fuera se ve un bloqueo silencioso. Anota el modo de la regla, no solo su existencia: registrar, limitar, desafiar o denegar tienen consecuencias distintas.
Logs
Conserva datos mínimos: timestamp, ruta normalizada, agente declarado, status y regla aplicada. Evita URLs con PII y retén solo lo necesario. Un user-agent observado no prueba identidad; un reverse lookup o rangos documentados aumentan confianza cuando el proveedor lo permite.
Normalizar la ruta significa recortar la cadena de consulta antes de guardarla, o conservar solo parámetros de una lista aprobada. Ahí se cuelan los datos personales sin que nadie lo decida: un formulario que envía por GET, un buscador interno que registra la consulta literal, un enlace con un token. Una vez en el registro, ese dato se replica en copias y sobrevive a la retención prevista.
La confianza en la identidad tiene tres niveles: la coincidencia del user-agent, que no aporta nada; la pertenencia a un rango publicado por el proveedor; y la resolución inversa a un dominio suyo con resolución directa de vuelta a la misma dirección. Ninguno es prueba absoluta.
Validación
Prueba desde origen y capa pública, con caché purgada. Guarda status, cabeceras y cuerpo de robots.txt. Simula agentes sin concluir autenticidad. Revisa que usuarios normales no queden bloqueados y que los controles administrativos permanezcan.
La doble lectura es lo único que distingue tres situaciones con el mismo síntoma: la regla no se guardó, se guardó pero la caché sirve la respuesta anterior, o se guardó y una capa intermedia la anula. El procedimiento encadena cuatro comprobaciones: petición al origen con el user-agent evaluado; la misma contra la URL pública tras purgar esa ruta; una de control con user-agent de navegador, para confirmar que la regla no afecta a personas; y una contra una ruta administrativa, para confirmar que la excepción no abrió nada.
Enviar una cabecera con el nombre de un agente demuestra cómo responde tu infraestructura ante esa cadena, no cómo se comporta el agente real: la evidencia se redacta como «la ruta X devuelve 200 a quien declara el agente Y».
Estados de verificación
La matriz no debe reducirse a permitido o bloqueado. Usa estados como documentado, configurado, observado, no verificado y bloqueado por acceso. “Configurado” describe una regla guardada; “observado” exige una petición registrada y una respuesta coherente. Ninguno demuestra por sí solo que el agente fuese auténtico.
| Estado | Qué afirma | Evidencia mínima | Qué no afirma |
|---|---|---|---|
| documentado | el proveedor describe el agente | URL de la fuente y fecha de consulta | que el agente se comporte así |
| configurado | existe una regla guardada | regla textual y capa donde vive | que llegue a aplicarse |
| observado | hubo peticiones y respuesta coherente | líneas de log con fecha y estado | que quien pidió fuese ese agente |
| no verificado | falta evidencia para decidir | qué dato falta y quién lo consigue | nada; es un estado de espera |
| bloqueado por acceso | no se puede comprobar | motivo del impedimento | que la política sea correcta |
«No verificado» es el estado que más se resiste a usarse y el que más aporta: un inventario donde ninguna fila admite ignorancia la oculta, no la elimina.
Coherencia entre capas y revisión
Cada fila incluye propietario de la decisión, fecha de la fuente y próxima revisión. Cuando cambie la documentación del proveedor, se abre una revisión en vez de modificar producción automáticamente. Los desacuerdos entre robots y WAF se tratan como incidencias: una política editorial no sirve si la capa de red aplica otra conducta.
La comprobación es mecánica y se ejecuta entera. Un agente permitido debe recibir contenido en robots, paso en la red y respuesta normal de la aplicación; uno bloqueado, el mismo trato en las tres. Cualquier combinación mixta es una incidencia aunque el resultado parezca el deseado: significa que la política depende del orden de evaluación y no de la decisión.
La revisión tiene dos disparadores: el calendario, que fija una fecha por fila según su volatilidad, y el evento — agente nuevo, cambio de documentación, migración de servidor o CDN, pico de tráfico automatizado. En ambos se reverifica la fuente, se relee la regla en cada capa y se actualiza la fecha aunque nada cambie. Y recuerda el alcance real: impedir el rastreo reduce la recogida futura, no elimina lo recogido antes. El artículo sobre el alcance de llms.txt desarrolla la misma distinción.
En cuatro láminas
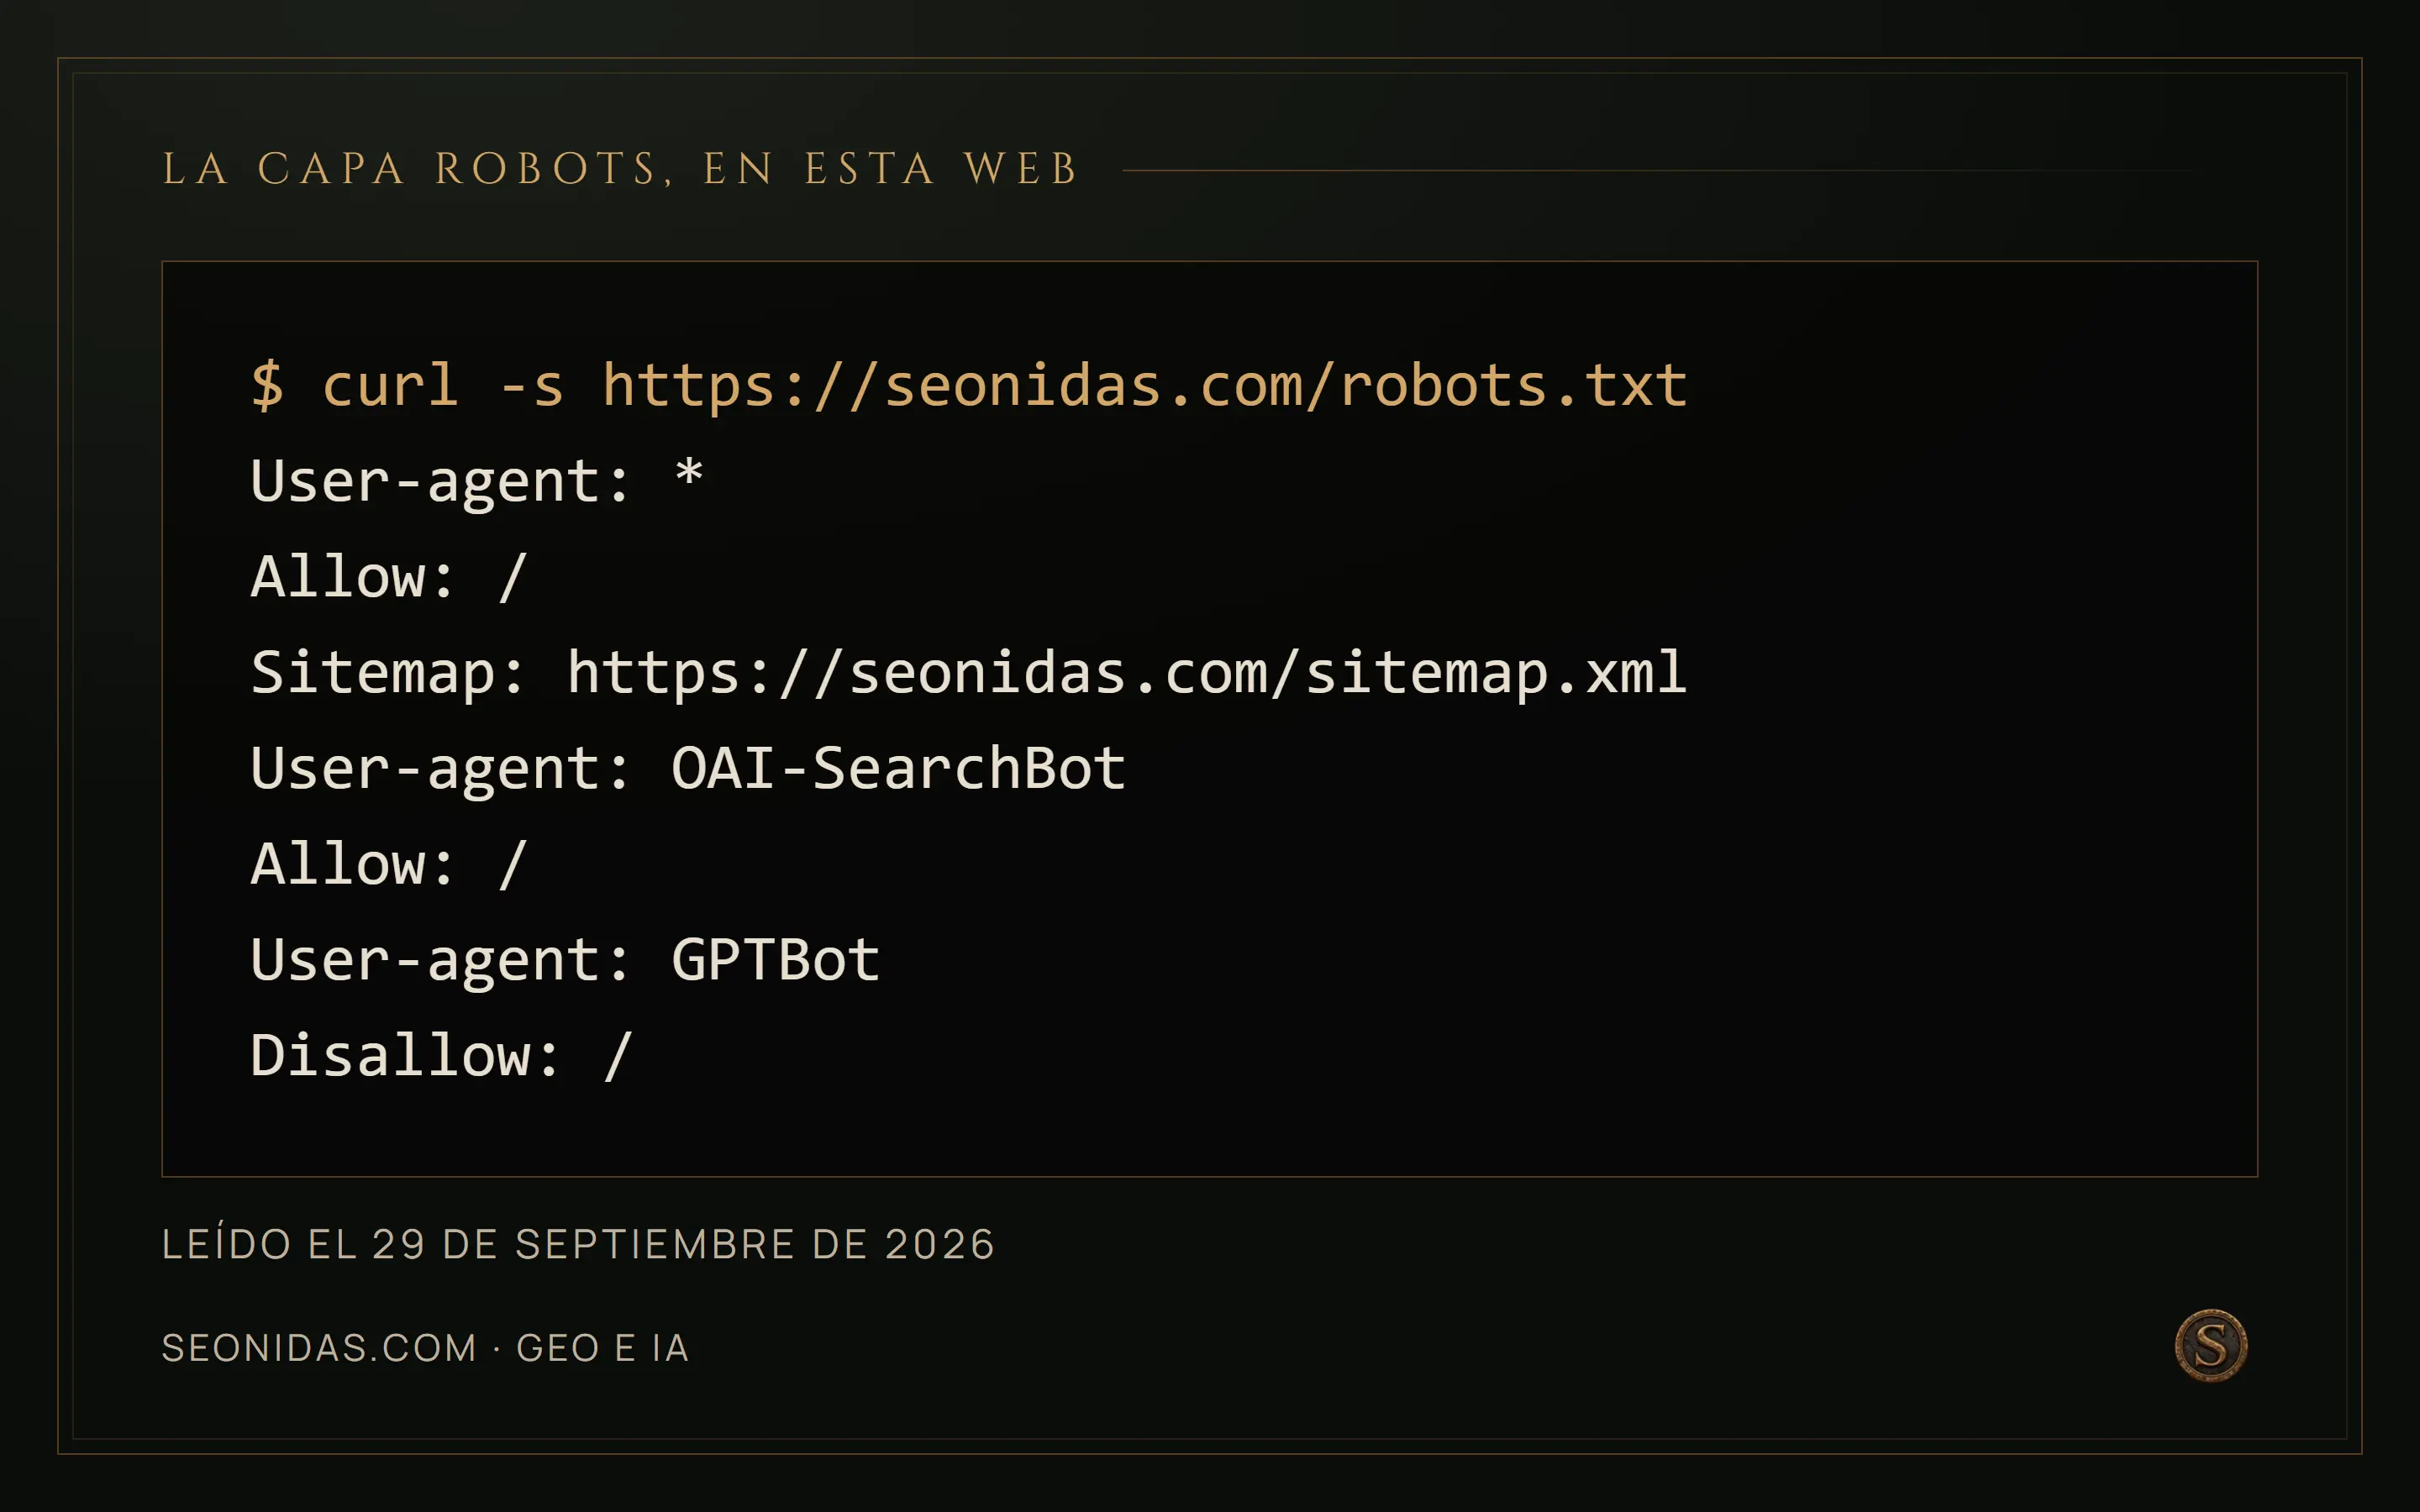
curl -s https://seonidas.com/robots.txt. User-agent: * / Allow: / / Sitemap: https://seonidas.com/sitemap.xml / User-agent: OAI-SearchBot / Allow: / / User-agent: GPTBot / Disallow: /. Leído el 28 de septiembre de 2026.
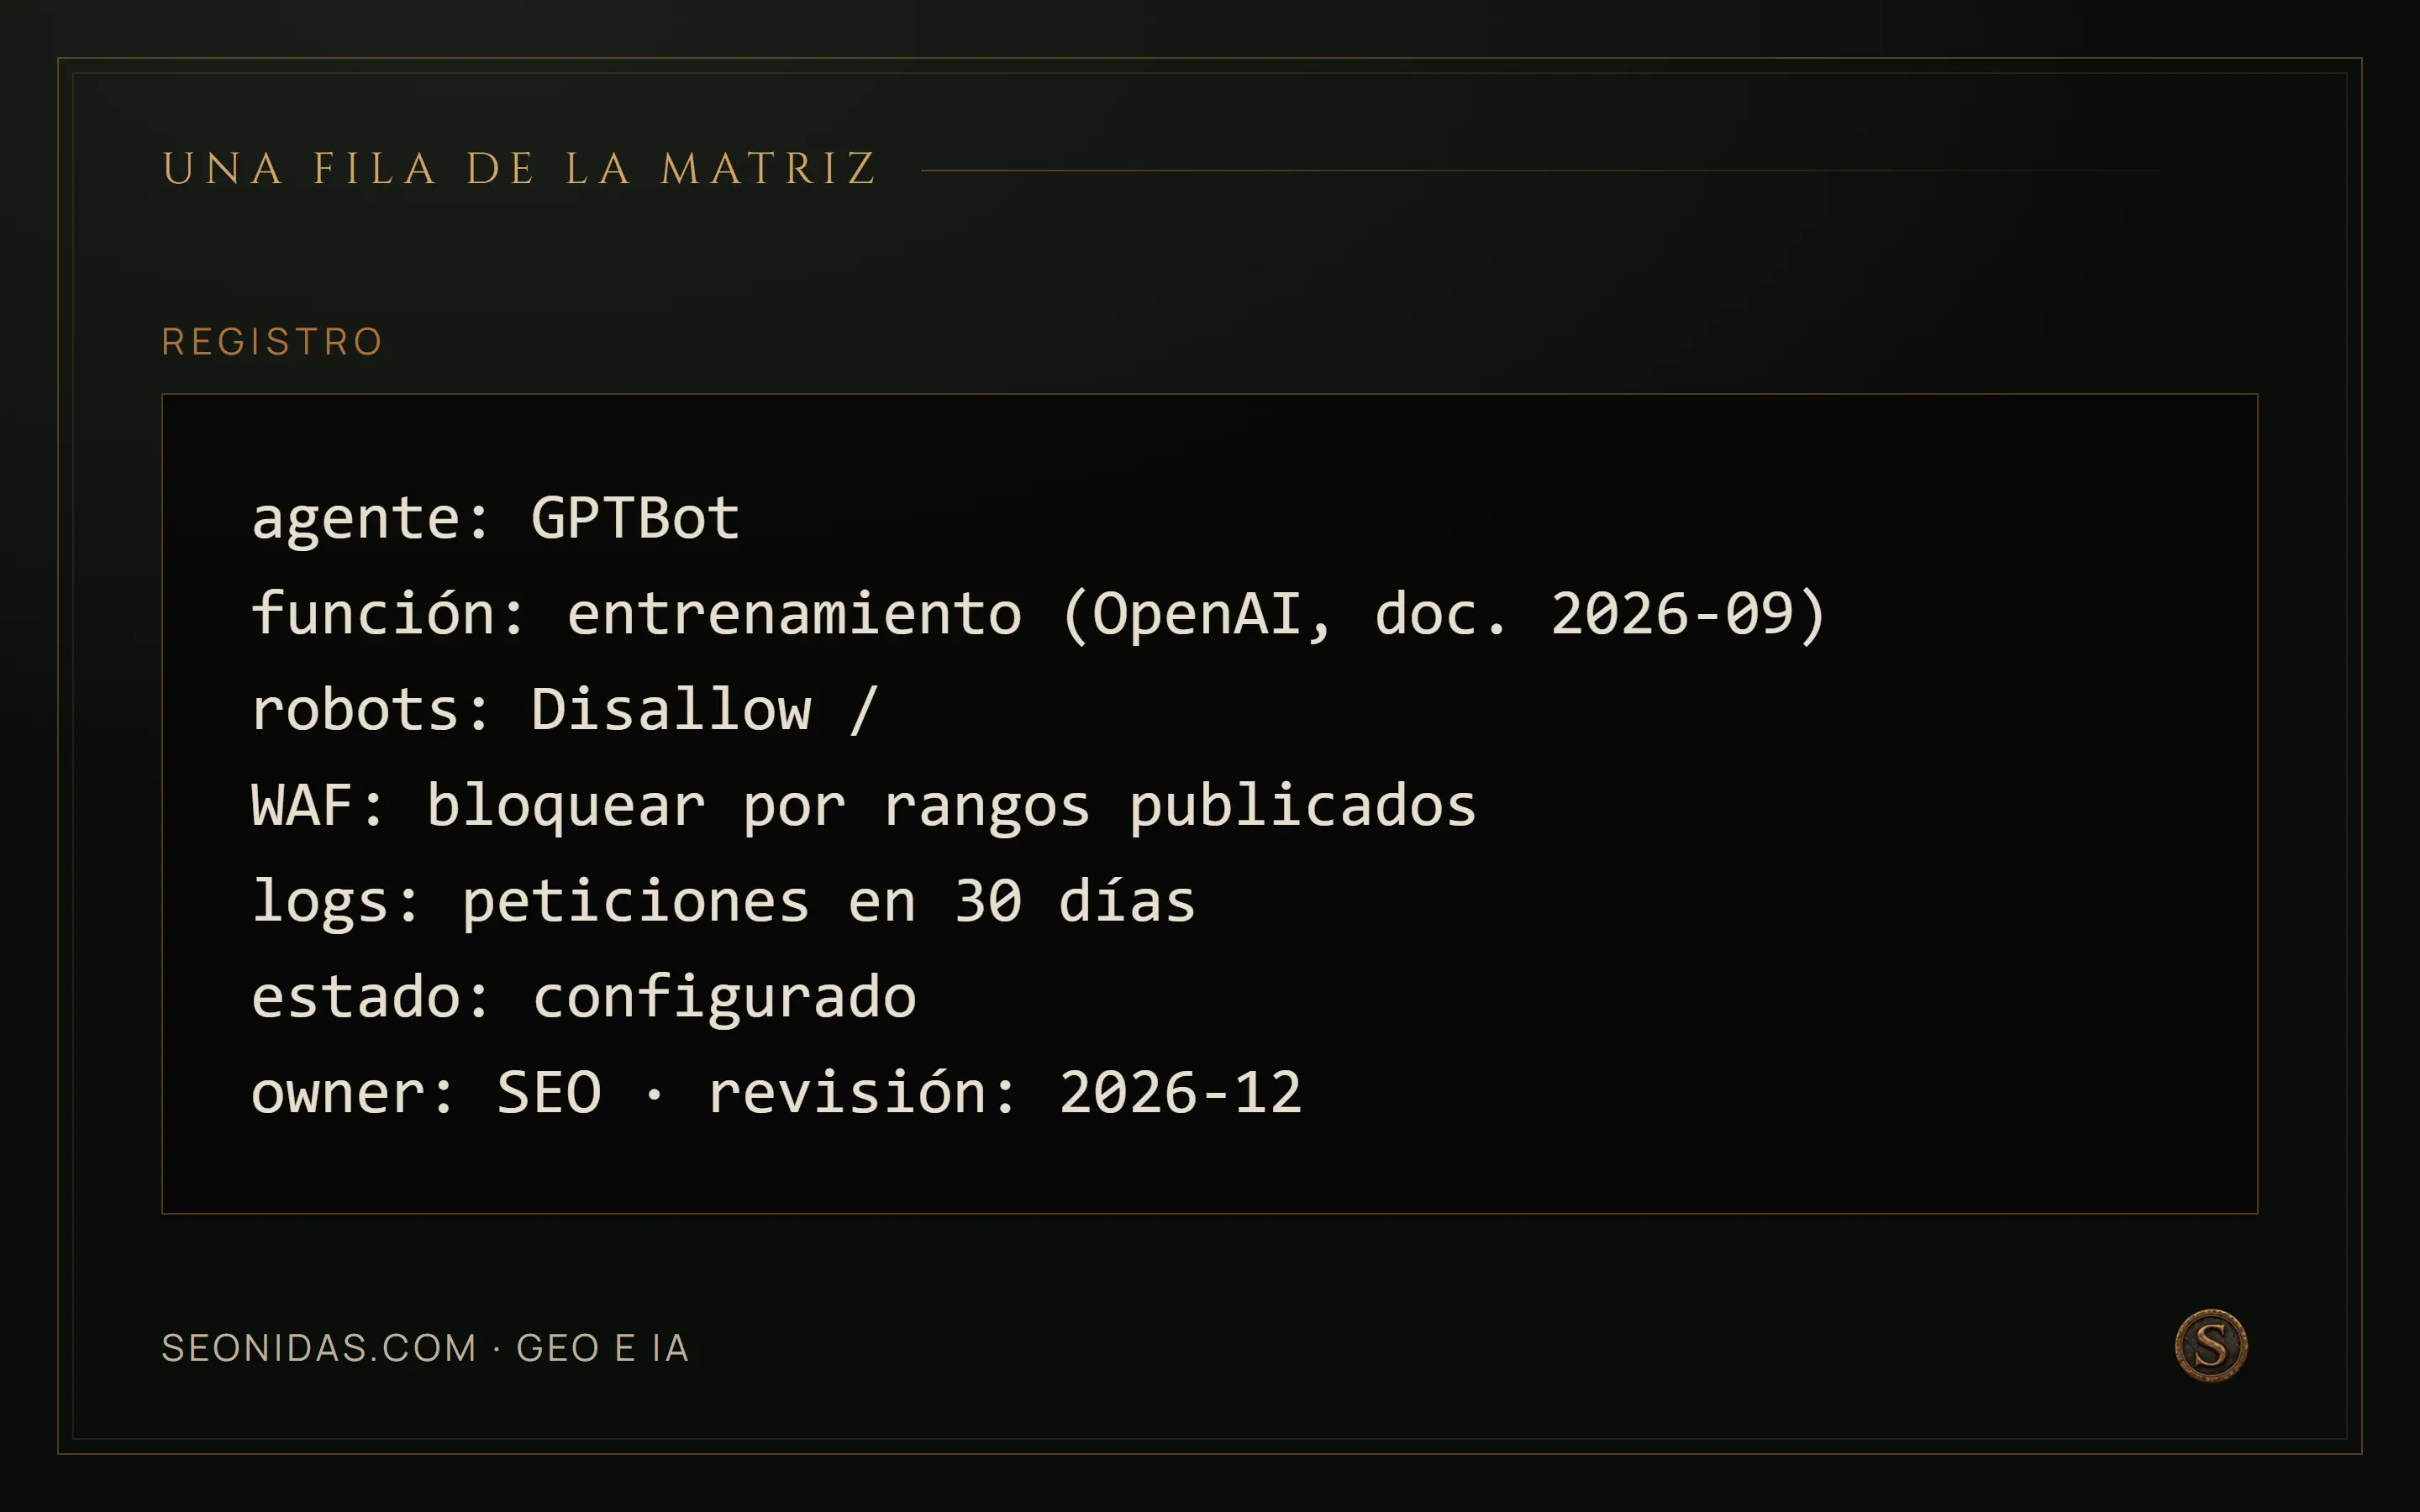
registro: agente: GPTBot / función: entrenamiento (OpenAI, doc. 2026-09) / robots: Disallow / / WAF: bloquear por rangos publicados / logs: peticiones en 30 días / estado: configurado / owner: SEO · revisión: 2026-12
5 estados de verificación. Documentado, configurado, observado, no verificado y bloqueado por acceso. Mezclarlos convierte la matriz en una opinión.
Errores frecuentes
- Bloquear en
robots.txtuna URL que se quiere sacar del índice, impidiendo que se lea elnoindexque la retiraría. - Escribir un grupo específico para un agente olvidando que dejará de leer el genérico, y concederle lo que este prohibía.
- Colocar una allowlist por rango antes de las comprobaciones de la aplicación, convirtiéndola en un salto de autenticación.
- Registrar la URL completa con su cadena de consulta y arrastrar datos personales a los logs.
- Modificar producción en cuanto cambia la documentación de un proveedor, sin validación.
Preguntas habituales
¿Basta con robots.txt para decidir qué entra?
Es una de las capas. La decisión se toma una vez y se aplica en robots.txt, en el WAF o el CDN y en la aplicación; si las tres discrepan, la política real es la que ejecuta la capa que responde primero, no la que está documentada. Por eso la matriz registra las tres.
¿Puedo fiarme del user-agent para saber quién entra?
No: es una cadena que el cliente elige y falsificarla es trivial. Solo los rangos de IP publicados por el proveedor o la resolución inversa acreditan quién llamó. Un informe de «visitas de bot» construido sobre el user-agent mezcla rastreadores auténticos con cualquiera que copie el nombre.
Si bloqueo un rastreador, ¿desaparece lo que ya recogió?
No. Impedir el rastreo no equivale a impedir la indexación ni retira lo ya recogido: son decisiones sobre el futuro. Lo que ya está fuera se pide por el canal que ofrezca cada proveedor, y no siempre existe.
El proveedor ha cambiado su documentación. ¿Actualizo producción?
Eso abre una revisión, no un despliegue. La fila afectada se marca, se comprueba contra la fuente primaria fechada y se valida antes de tocar nada: modificar reglas de acceso en caliente por una nota de versión es cómo se bloquea sin querer a un agente que sí interesaba.
Próximo paso
Empieza por el inventario de lo aplicado, no por la lista de agentes que existen. Extrae el robots.txt tal como lo sirve el servidor, exporta las reglas del WAF o del CDN que discriminen por user-agent o por rango, y saca de los registros recientes los agentes automatizados que realmente han pedido algo. Con esas tres fuentes tienes las filas que importan: las de producción.
Completa cada fila con la evidencia disponible y marca como «no verificado» lo que hoy no puedas sostener. Ejecuta después la comprobación de coherencia y trata cada discrepancia como una incidencia con responsable y fecha. Solo entonces conviene discutir qué agentes añadir: tocar reglas sobre un inventario que no coincide con producción reproduce la deriva que la matriz debía evitar.
Fuentes
- Google Search Central, rastreadores y fetchers de Google — documentación oficial.
- Google Search Central, verificar que una petición es de Google — documentación oficial.
- OpenAI, rastreadores y agentes declarados — documentación oficial.
Servicio y herramienta relacionados
Si esto es lo que te está pasando, posicionamiento en ia es el trabajo que lo resuelve. Diagnóstico primero, prioridades después.
Y para hacerlo tú: el generador de meta robots sirve para componer la etiqueta con las directivas que necesitas y ver qué hace cada una. Funciona en tu navegador y no envía tus datos a ningún sitio.
Escrito por
Jesús Iturbide
Consultor SEO técnico · SEONIDAS
Diagnóstico, priorización e implementación SEO en WordPress y PrestaShop. Servicio prestado íntegramente en línea desde Villava, Navarra.
jesusiturbide.comHablemos
¿Tu web tiene un problema de rastreo, indexación o rendimiento que nadie te explica? Cuéntamelo: te respondo en 24 horas laborables con una primera lectura del caso.
Abrir consulta