GEO e IA
Cómo medir citas en sistemas de IA con un protocolo reproducible
Publicado el
En esta página
Respuesta breve
Medir citas en sistemas de IA con un protocolo reproducible consiste en fijar antes de empezar un conjunto de preguntas justificadas, registrar el contexto completo de cada ejecución, repetir sin descartar salidas incómodas, clasificar lo observado en niveles que no se confundan entre sí y anotar todo lo que cambió en la web entre pasadas. El resultado se expresa como recuentos de esa muestra concreta, con su fecha y sus limitaciones, nunca como cobertura general del sistema: los modelos y sus capas de recuperación cambian, personalizan y no garantizan reproducibilidad.
Puntos clave
- El conjunto de preguntas se define antes y no se toca durante la ventana; añadir prompts a mitad invalida la comparación.
- Sin contexto registrado —producto, versión visible, fecha, idioma, sesión, búsqueda activada— una salida no es un dato, es una anécdota.
- Repetir es obligatorio: una única ejecución no distingue una respuesta estable de una casual.
- Descartar una salida porque «parece rara» convierte la medición en una selección.
- Los niveles de resultado —mención, atribución, enlace, referral, acción— necesitan fuentes distintas y no se deducen unos de otros.
- Si cambian varias cosas entre pasadas, ninguna conclusión es atribuible.
- Los recuentos describen la muestra, no el sistema; la limitación viaja siempre junto a la tabla.
El protocolo, de principio a fin
- Definir preguntasAntes, y sin tocarlas durante la ventana.
- Registrar contextoProducto, versión, fecha, idioma, sesión y búsqueda.
- RepetirSin descartar lo que «parece raro».
- ClasificarMención, atribución, enlace, referral y acción: por separado.
- Control de cambiosSi cambian varias cosas, nada es atribuible.
- PublicarObservación e interpretación, separadas.
Qué puede probar el protocolo
Conviene fijar el alcance antes de invertir esfuerzo, porque la expectativa habitual es más ambiciosa de lo que ninguna metodología puede sostener. Un protocolo bien ejecutado puede demostrar que, en unas condiciones declaradas y en unas fechas concretas, un conjunto de preguntas produjo cierto número de menciones y enlaces. Puede detectar que una referencia es incorrecta. Puede mostrar que un cambio propio coincidió con una variación observable.
Lo que no puede es medir cuota de visibilidad, estimar cuántas personas vieron una respuesta o afirmar que un cambio causó una mejora. Estos sistemas personalizan según cuenta y sesión, varían entre versiones y no exponen una población sobre la que muestrear. La diferencia con el SEO clásico es exactamente esa, y el artículo sobre GEO frente a SEO desarrolla por qué las métricas de uno no se trasladan al otro.
Definir preguntas
Construye familias: definición, comparación, recomendación contextual y tarea local. Evita preguntas diseñadas para incluir la marca. Cada prompt necesita una justificación y una intención. Mantén un conjunto de control que no cambia durante la ventana.
Una pregunta que nombra la marca solo comprueba que el sistema sabe repetir un nombre que ya le has dado. Las preguntas informativas son las que describen la situación real: alguien con un problema que no conoce todavía a quién acudir. Escribirlas cuesta más porque obligan a pensar desde la necesidad, no desde el negocio.
La justificación se anota junto al prompt: impide colar preguntas cómodas y permite revisar el diseño meses después sin depender de la memoria. El conjunto de control cumple otra función: son preguntas cuya respuesta no debería cambiar por nada de lo que hagas, y si cambian, el sistema se ha movido y esa pasada no es comparable.
Registrar contexto
- producto y sistema;
- modelo o versión visible;
- fecha y hora;
- idioma y ubicación aproximada;
- cuenta, plan y sesión cuando influyen;
- conversación nueva o previa;
- búsqueda activada;
- prompt exacto;
- respuesta, enlaces y citas;
- limitaciones o errores.
La comparación GEO–SEO explica por qué estas dimensiones importan.
Tres campos concentran la mayor parte de los errores de interpretación. Conversación nueva o previa: reutilizar un hilo arrastra contexto y contamina la respuesta con lo dicho antes, de modo que cada ejecución debería partir de conversación limpia salvo que el diseño exija lo contrario. Búsqueda activada: la misma pregunta contestada con recuperación web o solo con conocimiento del modelo produce resultados incomparables. Cuenta y plan: personalización, memoria e historial cambian la salida sin avisar.
El prompt se guarda exacto, no parafraseado, y la respuesta íntegra, no resumida: un resumen escrito por quien mide ya es interpretación, y pierde el matiz que luego resultará relevante.
Repetir sin seleccionar
Ejecuta cada familia varias veces y conserva todas las salidas. No reemplaces un resultado porque “parece raro”. Calcula tasas dentro de la muestra y evita convertirlas en probabilidad global. Los sistemas pueden cambiar durante el estudio.
La repetición es la única forma de distinguir estabilidad de casualidad. Una respuesta que aparece una vez de cinco describe algo muy distinto de una que aparece cinco de cinco, y sin repetir ambas se ven idénticas en un informe. Separa además las repeticiones en el tiempo: cinco ejecuciones seguidas comparten condiciones que cinco en cinco días no comparten.
Sobre el descarte, la regla es dura por un motivo concreto: la salida que parece anómala suele ser la más informativa. Una respuesta que atribuye a tu web algo que no dice, o que te confunde con otra empresa, es un hallazgo, no un fallo de la medición. Guardar todas las salidas y marcar las dudosas es distinto de eliminarlas.
Clasificar resultados
- la página es accesible mediante prueba autorizada;
- la entidad se menciona;
- existe atribución textual;
- aparece un enlace o cita verificable;
- llega un referral;
- ocurre una acción.
Cada nivel necesita una fuente distinta. Un enlace en respuesta no demuestra conversión; una visita con UTM no prueba que se citó una página concreta.
| Nivel | Dónde se comprueba | Confusión habitual |
|---|---|---|
| accesible | respuesta del servidor a la petición del agente | suponerlo por estar publicado |
| mención | texto de la respuesta | contarla como atribución |
| atribución | el texto asigna la afirmación a la fuente | darla por buena sin verificar el contenido |
| enlace o cita | URL presente y comprobable | asumir que el enlace se pulsa |
| referral | analítica del sitio | atribuirlo a una respuesta concreta |
| acción | evento de conversión | encadenarlo con el nivel anterior sin evidencia |
Los dos últimos niveles pertenecen a la analítica del sitio y arrastran sus propias limitaciones de consentimiento y atribución; la guía sobre medir conversiones orgánicas con privacidad cubre esa parte.
Control de cambios
Registra contenido, robots, schema, menciones y release entre pasadas. Si cambian varias variables, no atribuyas el resultado a una. El laboratorio exige hipótesis, entorno, limitaciones y hashes.
El registro de cambios se lleva aunque no se esté probando nada, porque lo que invalida una comparación no suele ser el cambio planificado sino el que hizo otra persona: una actualización de plugin, un ajuste de plantilla, una nota publicada en otro sitio. Basta una línea por evento con fecha, qué cambió y quién lo hizo.
Cuando aparece una variación en los resultados, la pregunta correcta no es qué la causó sino cuántas cosas podrían haberla causado. Si la lista tiene más de un elemento —y casi siempre lo tiene— la conclusión honesta es que se observó una variación en presencia de varios cambios. Eso sigue siendo información útil: señala dónde repetir con menos variables.
Separar observación e interpretación
La hoja de captura guarda primero lo observable: respuesta, enlace, dominio, posición visual, fecha y configuración declarada. Una segunda capa clasifica si la referencia es correcta, parcial, ausente o no verificable. Esta separación permite revisar criterios sin alterar la evidencia original.
Los resultados se expresan como recuentos de la muestra definida, nunca como cobertura general del sistema. Si una plataforma personaliza o no permite repetir condiciones, esa limitación acompaña la tabla. Las conversaciones privadas y datos de cuenta no se publican; se emplean prompts sintéticos y capturas recortadas cuando sea lícito.
La ventaja de las dos capas aparece cuando cambia el criterio de clasificación. Si a mitad del estudio se decide que una mención sin URL no cuenta como cita, con la evidencia intacta basta reclasificar; sin ella habría que repetir todo. Por eso la capa de observación se escribe sin adjetivos.
Publicar resultados
Un informe honesto se reconoce por lo que declara antes de las cifras: qué preguntas, cuántas repeticiones, en qué fechas, con qué producto y versión, y qué no se pudo controlar. Las cifras van después y en términos absolutos —cuántas ejecuciones de cuántas— porque un porcentaje sobre una muestra pequeña sugiere una precisión que no existe.
Las limitaciones no son un descargo final: son parte del resultado. Declarar que una plataforma no permitió repetir condiciones, o que la versión visible cambió a mitad de ventana, permite a quien lee decidir cuánto peso dar a la tabla. Y una muestra así no autoriza a estimar tráfico, cuota ni retorno.
Las limitaciones no son un descargo final: son parte del resultado.
En cuatro láminas

5 niveles de resultado. Mención, atribución, enlace, referral y acción: fuentes distintas, no se deducen unos de otros.
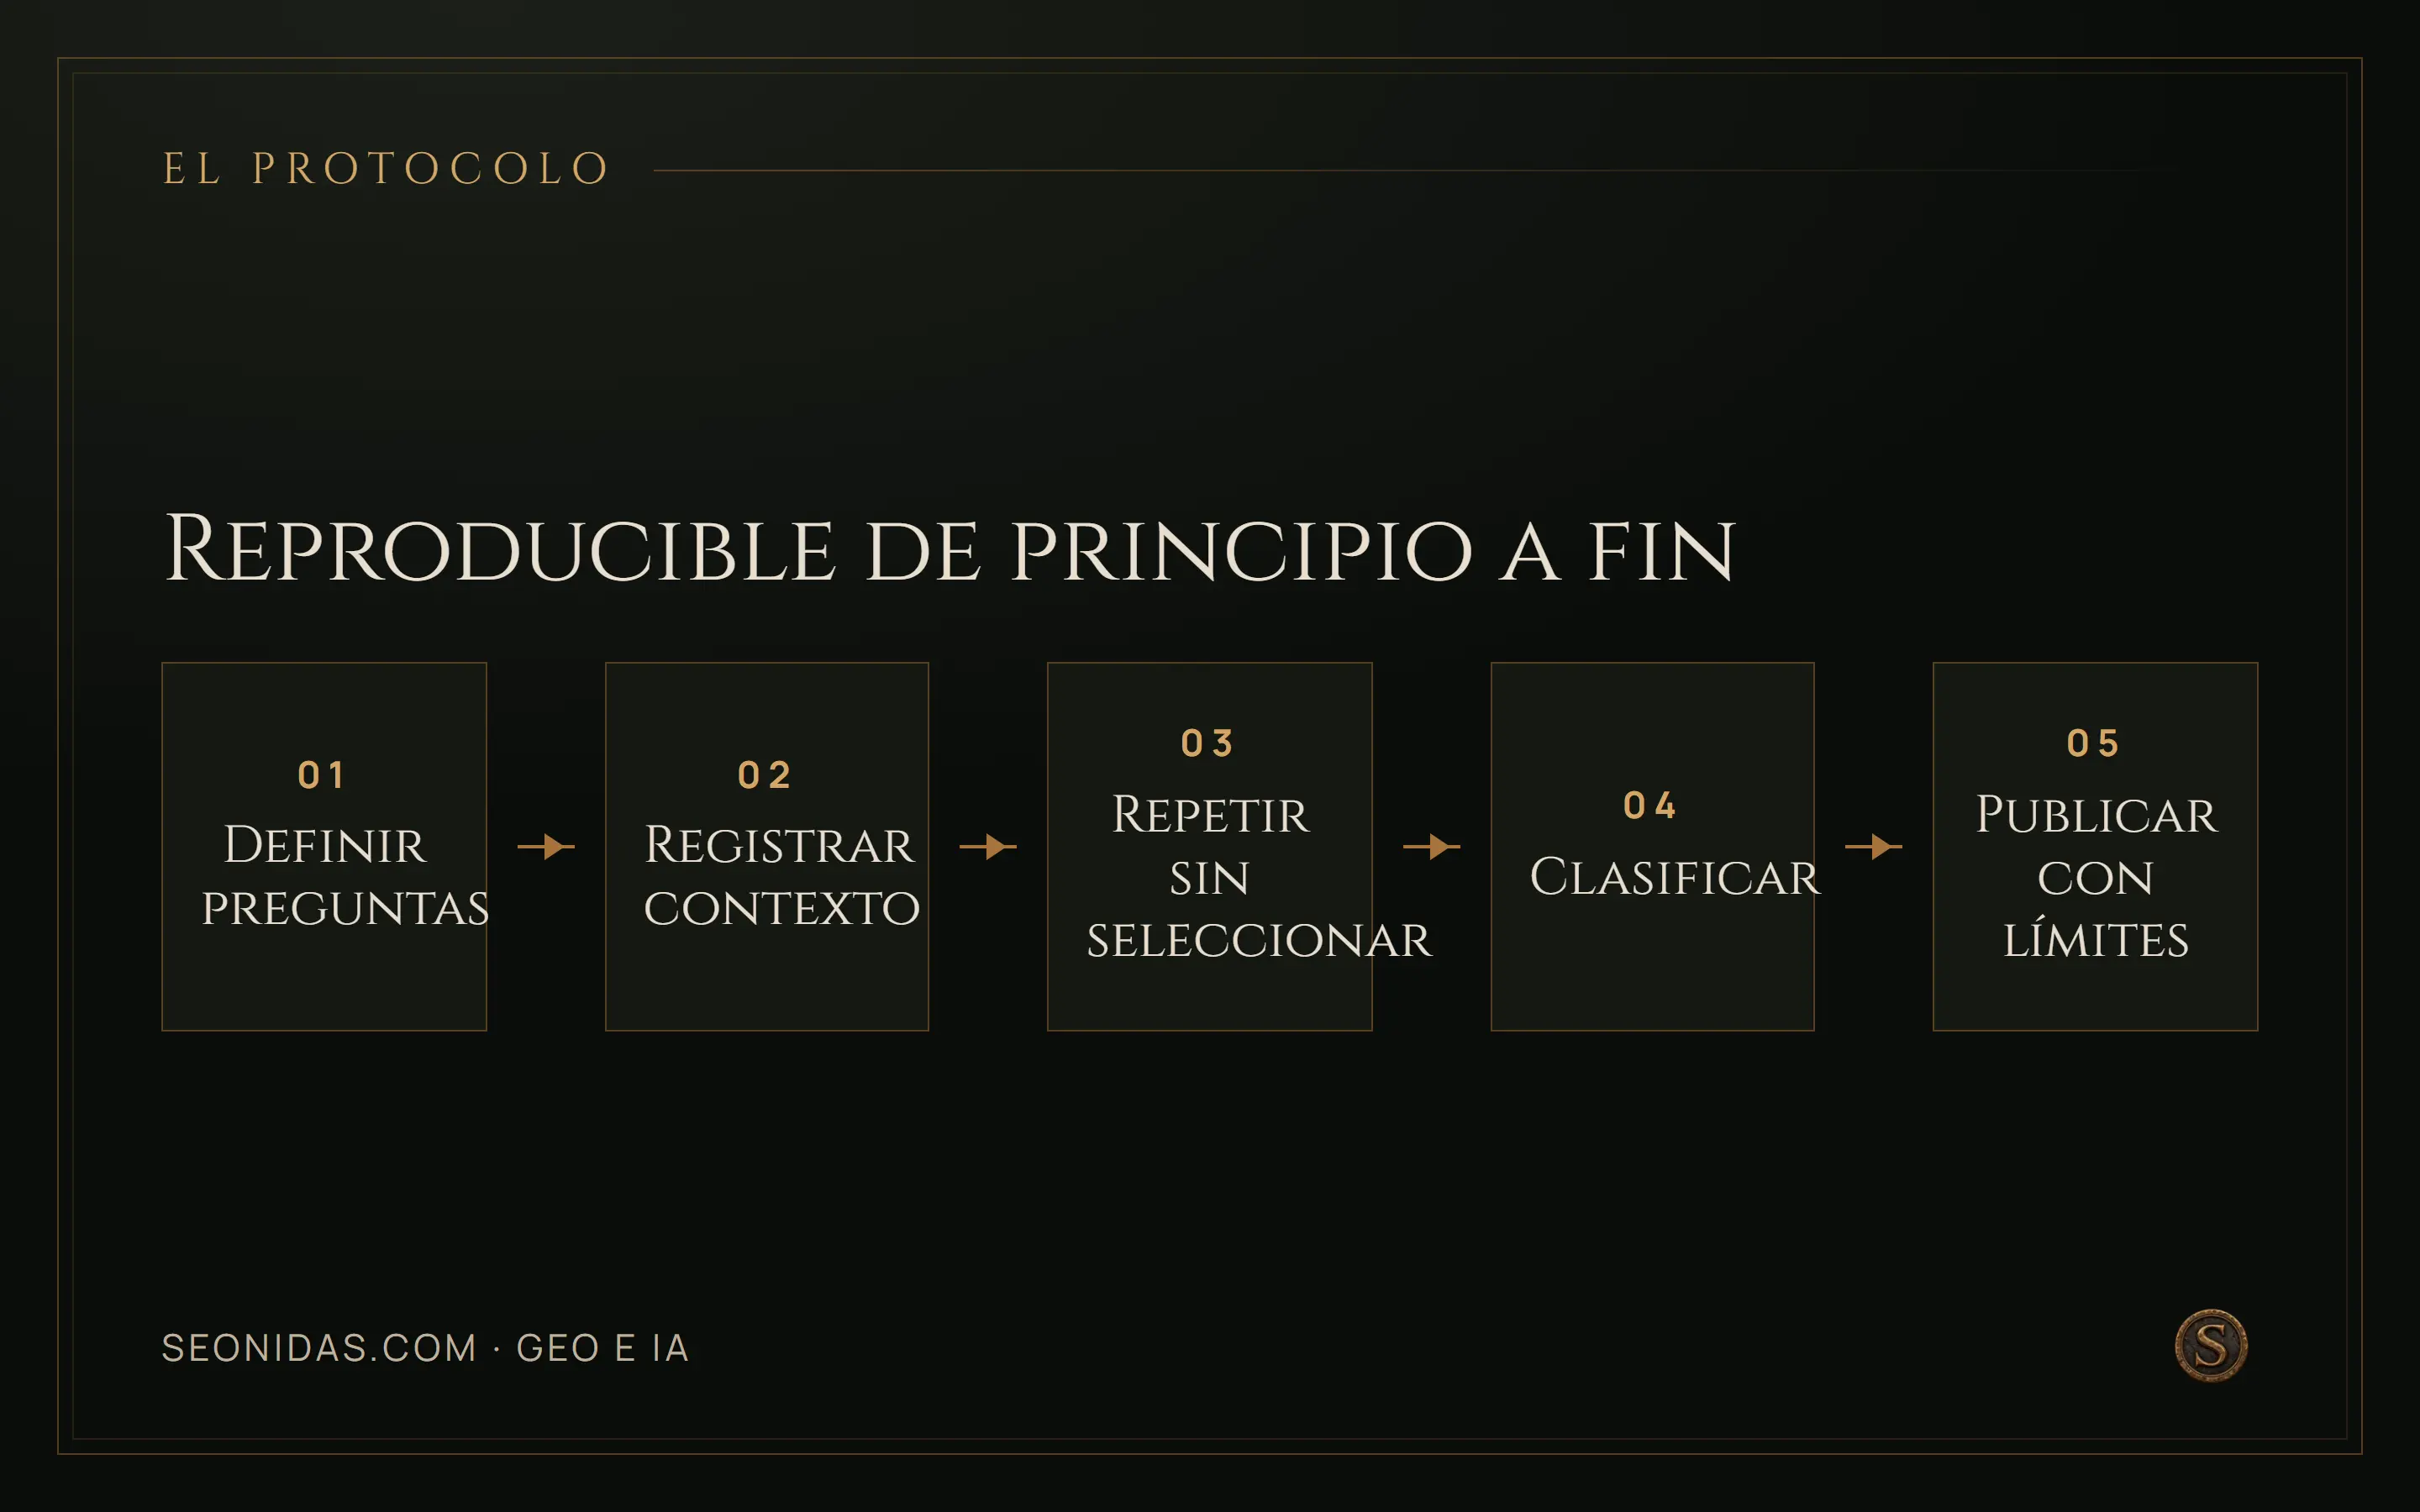
Reproducible de principio a fin: 1. Definir preguntas → 2. Registrar contexto → 3. Repetir sin seleccionar → 4. Clasificar → 5. Publicar con límites
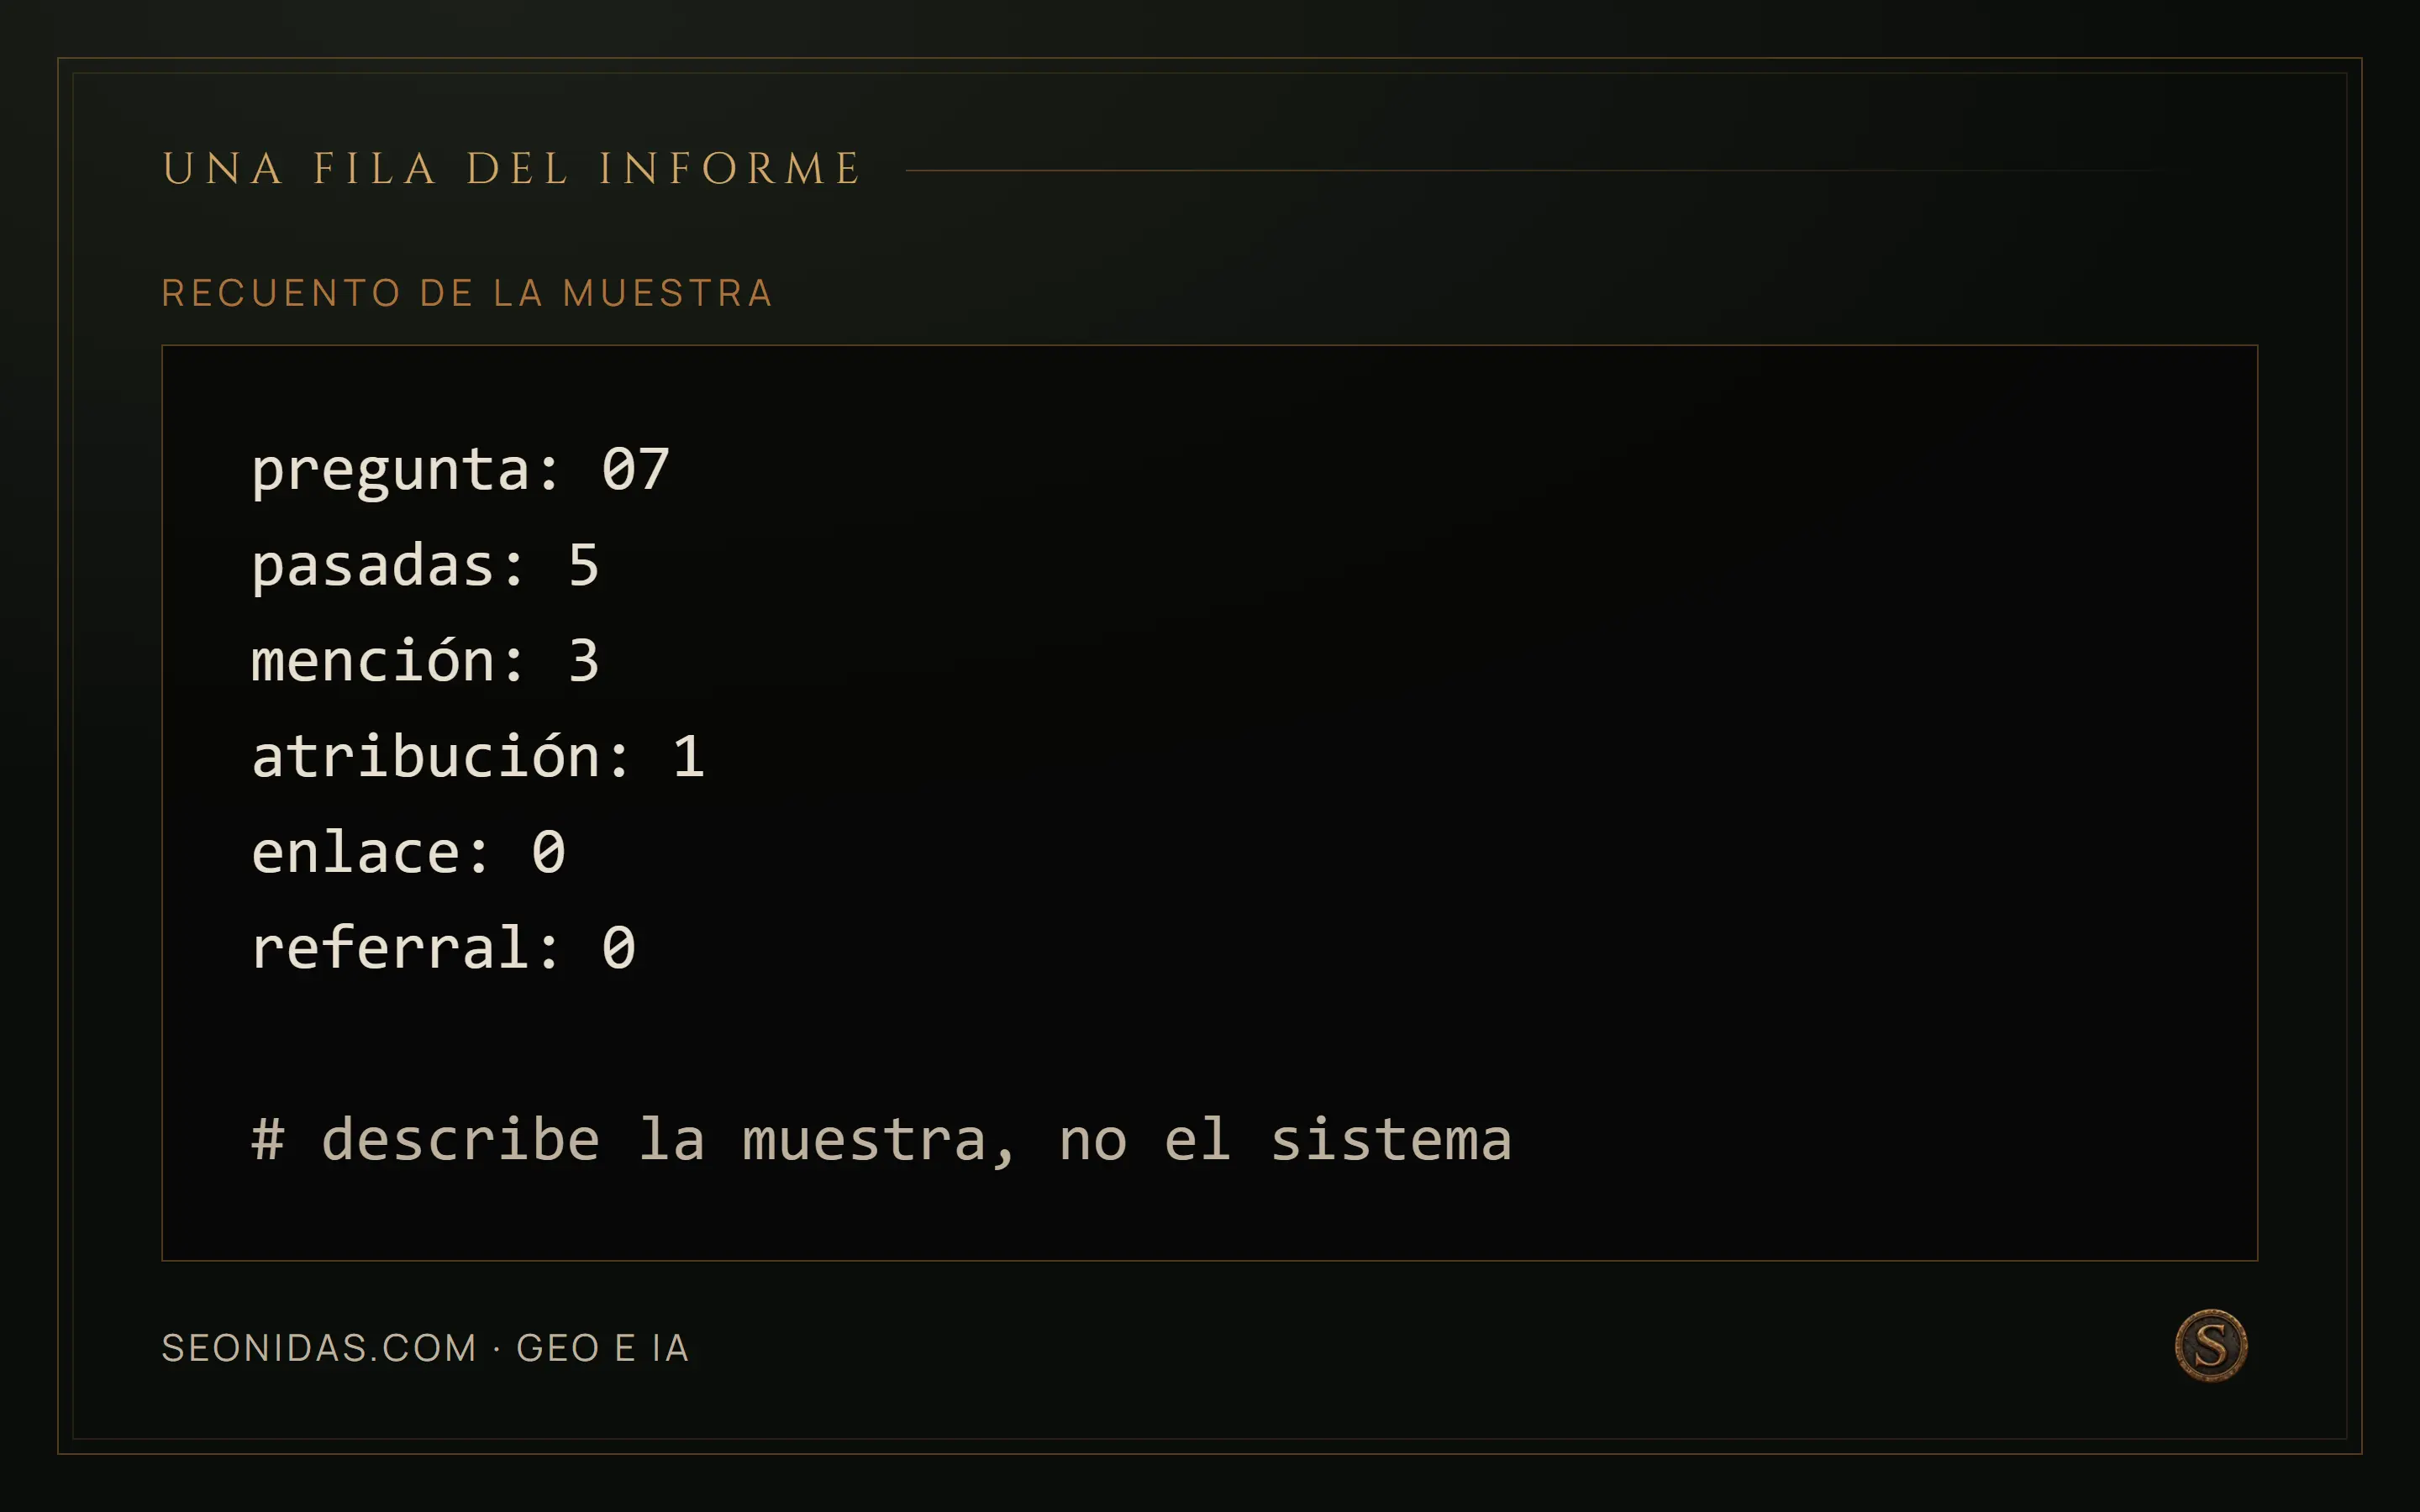
recuento de la muestra: pregunta: 07 / pasadas: 5 / mención: 3 / atribución: 1 / enlace: 0 / referral: 0 / / # describe la muestra, no el sistema
Errores frecuentes
- Diseñar preguntas que nombran la marca y presentar el resultado como visibilidad.
- Añadir o retocar prompts durante la ventana y comparar después con las pasadas anteriores.
- Ejecutar una sola vez cada pregunta y tratar la salida como estable.
- Descartar las respuestas anómalas, que suelen ser las que más informan.
- Reutilizar la misma conversación entre ejecuciones y arrastrar contexto sin registrarlo.
- Guardar un resumen de la respuesta en lugar de la respuesta íntegra.
- Contar una mención como atribución, o un enlace como visita.
- Atribuir una variación a un cambio propio cuando entre pasadas cambiaron varias cosas.
- Convertir los recuentos de la muestra en porcentajes de cobertura del sistema.
Preguntas habituales
¿Cuántas veces hay que repetir cada pregunta?
Las suficientes para distinguir una respuesta estable de una casual, y el número se fija antes de empezar, no sobre la marcha. Una sola ejecución no permite ninguna afirmación: en estos sistemas la misma pregunta puede dar salidas distintas en la misma tarde. Lo que se publica es el recuento de esa muestra, con su fecha.
¿Puedo añadir prompts mejores a mitad de la medición?
No sin abrir una ventana nueva. Cambiar el conjunto de preguntas durante la medición rompe la comparación con las pasadas anteriores: lo que se compare después mezclará dos muestras distintas. Si aparece una pregunta que merece la pena, se anota y entra en la siguiente ventana, con su fecha de incorporación.
¿Una mención cuenta como visita?
No, y confundirlas es el error que más infla los informes. Mención, atribución, enlace, referral y acción son niveles distintos, se observan con fuentes distintas y no se suman entre sí. Una marca puede aparecer nombrada muchas veces sin recibir una sola visita, y eso es información útil siempre que se cuente como lo que es.
¿Los porcentajes describen al sistema de IA?
Describen la muestra. Un recuento sobre veinte preguntas repetidas cinco veces dice qué pasó en esas cien ejecuciones, en esa fecha y con ese contexto; no la cobertura del sistema, que ni se conoce ni es estable. La limitación viaja junto a la tabla, no en una nota al pie.
Próximo paso
Antes de ejecutar nada, escribe el diseño: las familias de preguntas con su justificación, el número de repeticiones, la ventana, los productos y versiones que se van a observar, y el conjunto de control. Ese documento es el que impide, más adelante, la tentación de ajustar el método a los resultados.
Monta después la hoja de captura con las dos capas separadas —observación y clasificación— y prueba el protocolo con una familia antes de lanzarlo entero: la primera pasada casi siempre revela un campo que faltaba o una condición que no se estaba registrando. Con el diseño estable, ejecuta la ventana completa, mantén en paralelo el registro de cambios de la web y publica los recuentos con sus limitaciones delante. Mientras tanto, trabajar el contenido para que sea fácil de citar aporta más que optimizar contra una medición que todavía no es estable.
Fuentes
- Google Search Central, guía de optimización para funciones de IA en la Búsqueda — documentación oficial.
- Google Search Central, contenido útil y experiencia de página — documentación oficial.
- Google Search Central, rastreadores y fetchers: cómo se identifican — documentación oficial.
Servicio y herramienta relacionados
Si esto es lo que te está pasando, posicionamiento en ia es el trabajo que lo resuelve. Diagnóstico primero, prioridades después.
Y para hacerlo tú: el generador de UTM sirve para etiquetar las URLs con parámetros consistentes antes de medir nada. Funciona en tu navegador y no envía tus datos a ningún sitio.
Escrito por
Jesús Iturbide
Consultor SEO técnico · SEONIDAS
Diagnóstico, priorización e implementación SEO en WordPress y PrestaShop. Servicio prestado íntegramente en línea desde Villava, Navarra.
jesusiturbide.comHablemos
¿Tu web tiene un problema de rastreo, indexación o rendimiento que nadie te explica? Cuéntamelo: te respondo en 24 horas laborables con una primera lectura del caso.
Abrir consulta