GEO e IA
Qué es llms.txt y qué no puede hacer por tu visibilidad
Respuesta breve
llms.txt es una convención emergente para ofrecer a posibles consumidores automáticos un resumen y enlaces prioritarios en texto simple. No sustituye el sitemap, robots.txt, el HTML ni la arquitectura. Tampoco es un factor universal, una vía de indexación o una garantía de aparecer citado por un sistema de IA.
Puntos clave
- Trátalo como recurso opcional y de bajo coste.
- Genera su contenido desde datos públicos y verificados.
- No incluyas secretos, borradores ni información privada.
- Conserva URLs canónicas y una selección breve.
- No confundas el archivo con permisos de crawling.
- Mide acceso y utilidad antes de ampliar a una versión completa.
Qué es y qué no es
Qué es
- Un índice legible por máquinas del contenido público
- Se genera desde datos verificados
- Conserva URLs canónicas y una selección breve
- Se valida y se mantiene como cualquier fichero público
Qué no es
- Un permiso ni una directiva de rastreo
- Un sustituto de robots.txt o del sitemap
- Una garantía de cita
- Un sitio para secretos, borradores o información privada
Índice
- Definición operativa
- Relación con robots y sitemap
- Cuándo puede ser útil
- Qué contenido incluir
- Qué debe quedar fuera
- Implementación segura en WordPress
- Validación y mantenimiento
- Cómo medir sin atribuir de más
- Errores frecuentes
- Preguntas habituales
Definición operativa
Un archivo llms.txt se publica normalmente en la raíz y utiliza texto o Markdown sencillo. Puede presentar el nombre del sitio, una descripción breve y enlaces a servicios, recursos, política editorial y contacto. La idea es ofrecer un mapa legible sin exigir interpretar toda la navegación.
“Convención emergente” significa que no todos los sistemas la consumen, su comportamiento puede cambiar y no existe una obligación universal. La especificación de SEONIDAS lo incluye como mejora opcional, no como puerta de lanzamiento (RS-001).
Relación con robots y sitemap
Cada recurso responde a una pregunta distinta:
| Recurso | Función principal | Lo que no hace |
|---|---|---|
robots.txt | expresa controles de rastreo para agentes compatibles | no protege datos privados |
| sitemap XML | enumera URLs candidatas y metadatos compatibles | no obliga a indexar |
| HTML y enlaces | entregan contenido, estructura y navegación | no garantizan selección |
llms.txt | resume y prioriza enlaces para consumidores que lo adopten | no concede permisos ni reemplaza los anteriores |
La política de OAI-SearchBot y GPTBot se configura en robots y WAF, no dentro de llms.txt. Una URL listada sigue sometida a su respuesta, autenticación y directivas.
Cuándo puede ser útil
El coste es razonable cuando el sitio ya tiene:
- arquitectura estable;
- páginas canónicas completas;
- autoría y entidad coherentes;
- recursos sustanciales;
- un proceso para regenerar el archivo;
- una persona responsable de revisarlo.
Puede ayudar a ofrecer un índice compacto a consumidores compatibles y a documentar prioridades internas. No conviene si obliga a mantener manualmente una segunda navegación que diverge o si se utiliza para justificar que el contenido principal permanezca desordenado.
Google Search Central mantiene que sus funciones de IA se apoyan en los fundamentos y contenido útil (RS-004). No existe base en las fuentes registradas para afirmar que Google requiere llms.txt.
Qué contenido incluir
Una versión mínima de SEONIDAS podría contener:
- nombre y descriptor aprobados;
- una descripción honesta;
- mercado y servicios permitidos;
- URLs canónicas de páginas completas;
- blog, herramientas y recursos revisados;
- política editorial;
- contacto solo cuando exista un canal público válido.
La selección debe ser breve. No copies artículos completos ni generes una línea por cada entrada. Un enlace lleva a la fuente HTML, que conserva contexto, accesibilidad y actualización.
Los datos se obtienen de una fuente de configuración aprobada y del mapa de URLs, no de cadenas duplicadas dentro del plugin. Así, un cambio de canonical o estado puede regenerar el recurso de forma determinista.
Qué debe quedar fuera
- datos personales no autorizados;
- emails o teléfonos retirados del repositorio;
- borradores o páginas
noindexincompletas; - rutas administrativas o de staging;
- parámetros, búsquedas internas y archivos pobres;
- afirmaciones comerciales sin evidencia;
- instrucciones dirigidas a manipular un modelo;
- contenido privado, tokens o configuración.
Un archivo público no es un lugar para el backlog editorial. Si una ruta no está lista para usuarios, no se presenta a consumidores automáticos.
Un archivo público no es un lugar para el backlog editorial.
Implementación segura en WordPress
Hay dos opciones proporcionadas:
- endpoint dinámico controlado: WordPress responde en
/llms.txtdesde datos validados; - artefacto de build: el release genera un archivo desde una allowlist.
En ambos casos:
- respuesta
text/plaincon codificación correcta; - caché y purge documentados;
- contenido escapado como texto;
- orden determinista;
- cero inputs de usuario;
- cero fetch remoto por request;
- tests de estado, cabecera y ausencia de datos bloqueados.
En SEONIDAS, el plugin puede generar la ruta porque la funcionalidad persiste al cambiar de tema. /llms-full.txt permanece desactivado hasta demostrar necesidad: duplicar el corpus aumenta peso y riesgo de divergencia.
Validación y mantenimiento
Antes de publicar:
- compara cada URL con el mapa canónico;
- verifica que responde 200 y no tiene
noindex; - revisa que title y contenido coinciden con el resumen;
- escanea secretos, emails y teléfonos;
- comprueba codificación y saltos de línea;
- valida caché de origen y pública;
- registra hash del contenido;
- programa revisión junto con cada release editorial.
No es necesario regenerar en cada request. Un hash o invalidación por cambio de contenido reduce trabajo y facilita reproducibilidad.
Cómo medir sin atribuir de más
Los logs pueden indicar solicitudes al archivo, pero el user-agent puede falsificarse. Un hit no demuestra consumo ni cita; su ausencia tampoco prueba que ningún sistema haya utilizado las páginas. La medición útil registra acceso agregado, respuesta, agente declarado y periodo con retención mínima.
Después se observa la superficie real con el protocolo reproducible para medir citas en sistemas de IA: sistema, modelo, prompt, contexto, fecha y citas. No atribuyas un cambio a llms.txt si también cambiaron contenido, robots o autoridad. Idealmente introduce un cambio por fase y conserva línea base.
En cuatro láminas
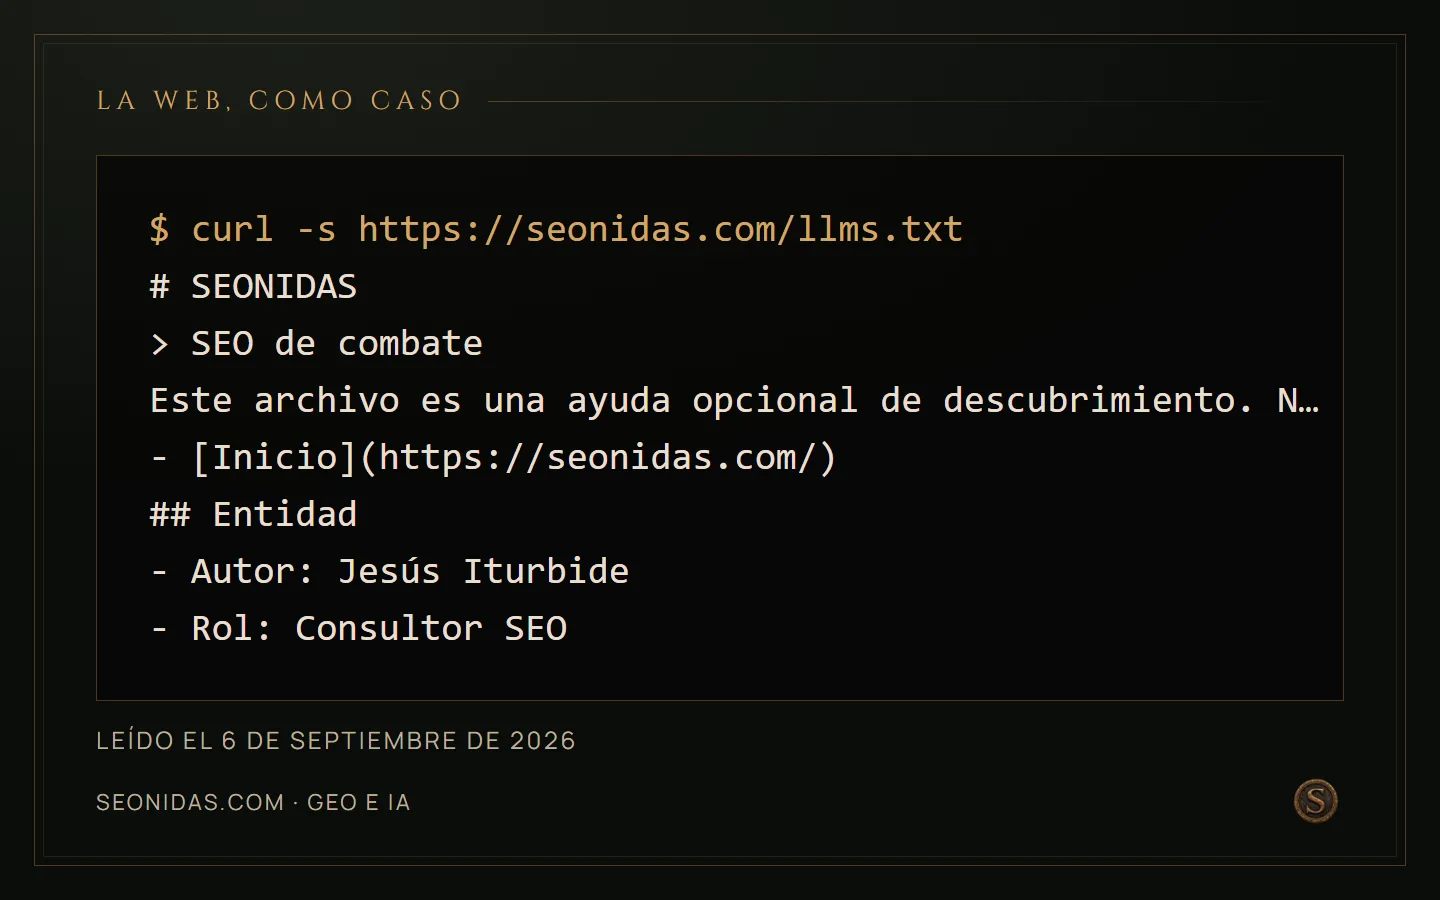
curl -s https://seonidas.com/llms.txt. # SEONIDAS / > SEO de combate / Este archivo es una ayuda opcional de descubrimiento. N… / - [Inicio](https://seonidas.com/) / ## Entidad / - Autor: Jesús Iturbide / - Rol: Consultor SEO. Leído el 10 de septiembre de 2026.
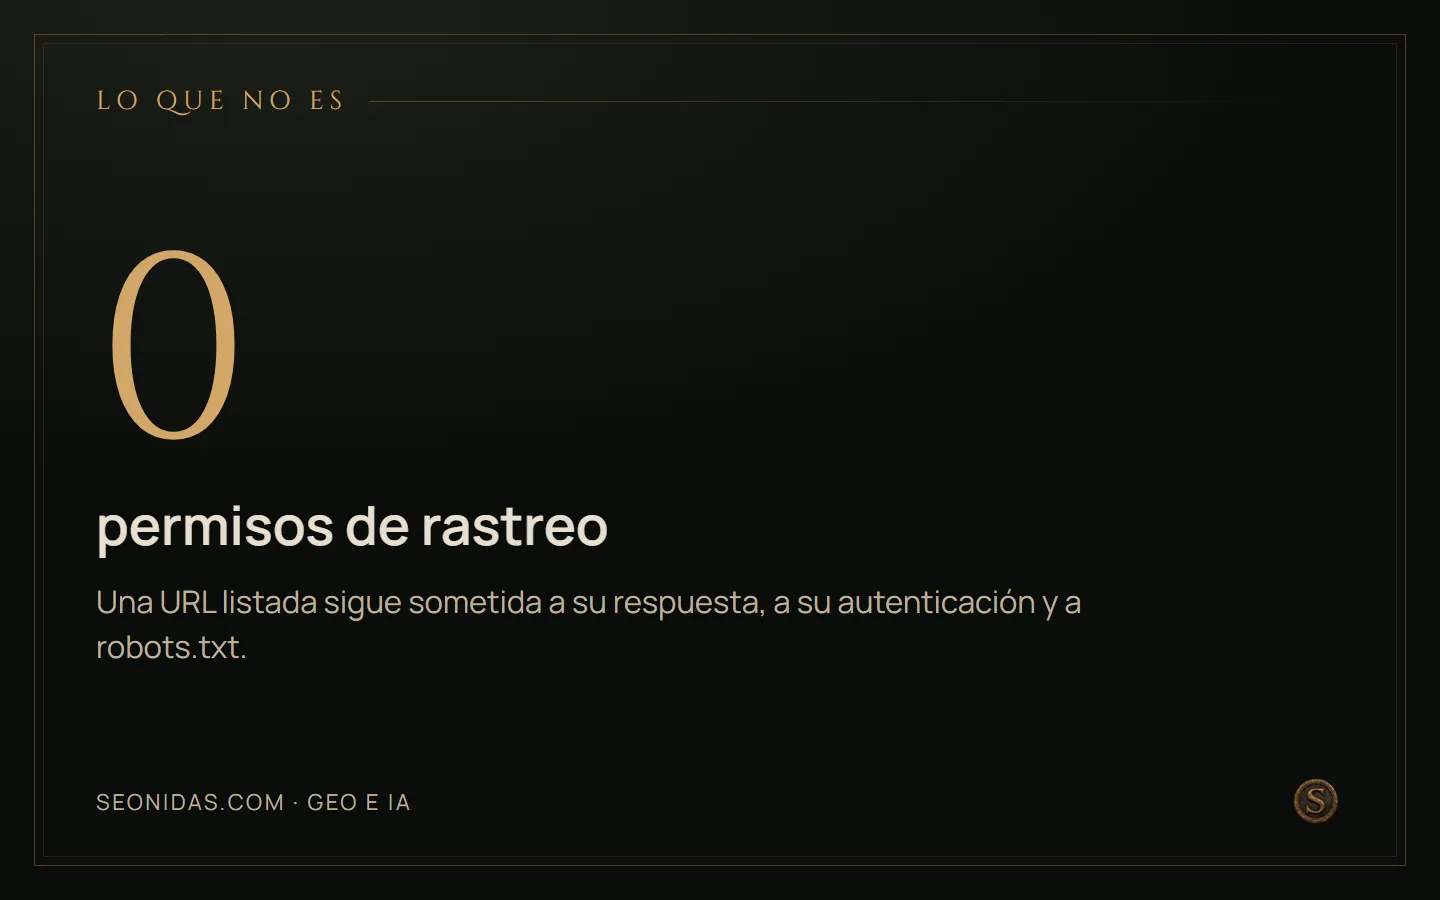
0 permisos de rastreo. Una URL listada sigue sometida a su respuesta, a su autenticación y a robots.txt.
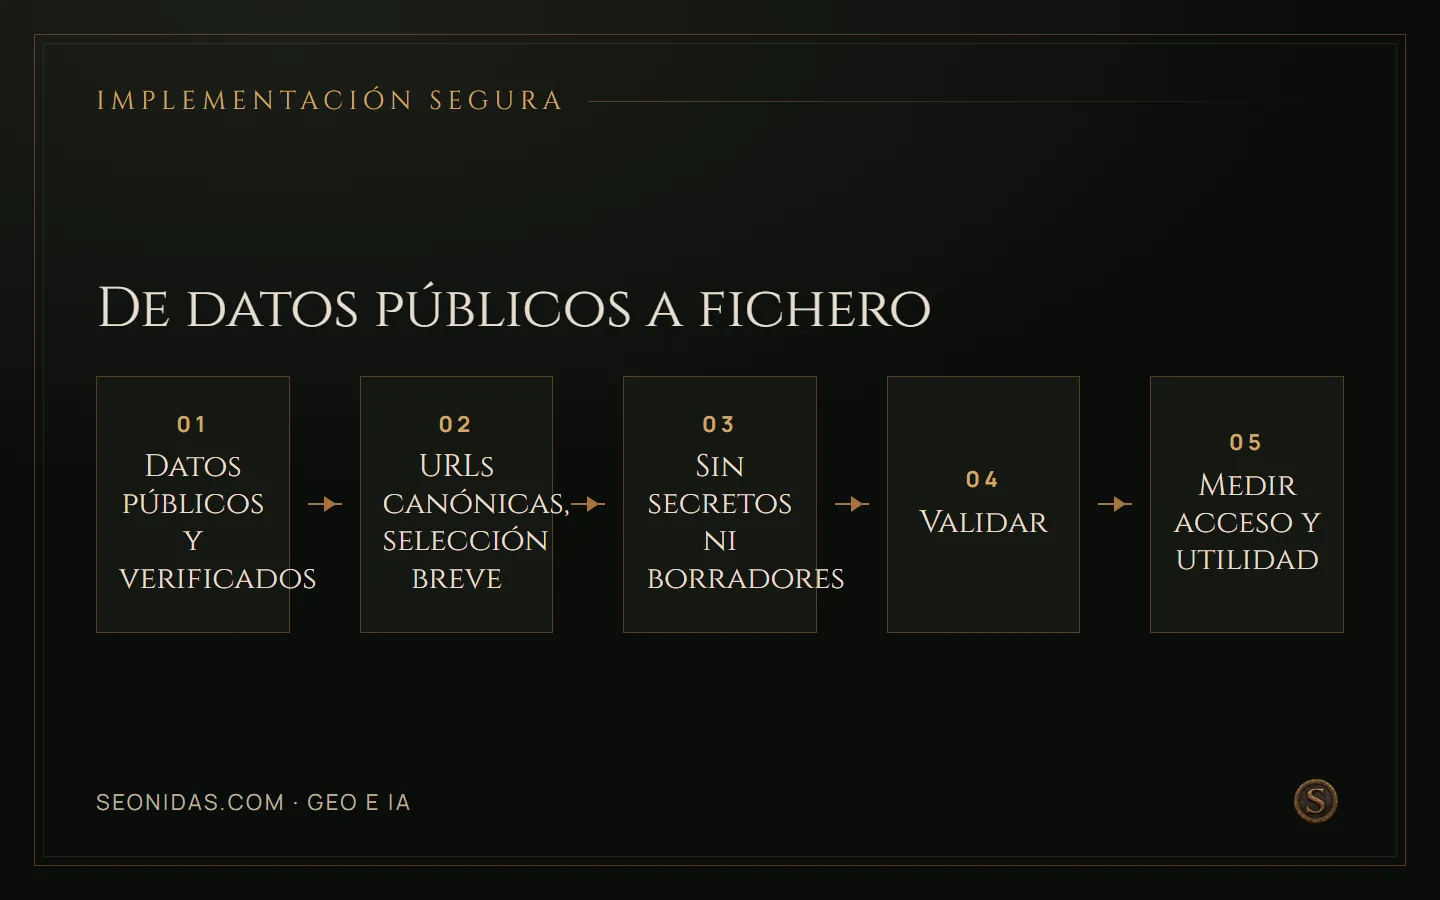
De datos públicos a fichero: 1. Datos públicos y verificados → 2. URLs canónicas, selección breve → 3. Sin secretos ni borradores → 4. Validar → 5. Medir acceso y utilidad
Errores frecuentes
- Prometer visibilidad por crear el archivo.
- Copiar todo el sitemap en Markdown.
- Incluir contacto no confirmado.
- Listar borradores o páginas legales incompletas.
- Mantener el archivo manual separado del mapa de URLs.
- Usarlo como control de bots.
- Publicar
llms-full.txtcon todo el contenido sin necesidad. - No purgar CDN después de actualizar.
- Contar requests como citas.
Preguntas habituales
¿Google utiliza llms.txt?
No debe afirmarse a partir de las fuentes de este proyecto. La guía oficial consultada no lo presenta como requisito. La arquitectura web y el contenido útil siguen siendo la base.
¿ChatGPT necesita llms.txt?
La documentación de OpenAI registrada para publishers diferencia crawlers, pero no convierte llms.txt en condición de aparición. Puede ser un recurso complementario para consumidores que lo adopten.
¿Debo incluir artículos completos?
No en la versión mínima. Enlaza páginas canónicas. Una versión completa añade mantenimiento y riesgo; solo procede con un caso verificado.
¿Puede contener instrucciones para una IA?
Debe describir el sitio y sus recursos, no intentar modificar las reglas del consumidor. Además de poco fiable, mezclar instrucciones con contenido dificulta el propósito editorial.
Conclusión
llms.txt puede ser un índice ligero y transparente, pero su valor depende de una web ya ordenada. Implementarlo con una allowlist, datos verificados y tests cuesta poco; presentarlo como atajo desinforma y distrae de los fundamentos.
Próximo paso
Antes de crear el archivo, revisa el mapa de URLs, el estado editorial y la política de crawlers. Si todos están alineados, genera una versión mínima y prueba su salida junto con GEO/IA y SEO técnico.
Fuentes
- Especificación del proyecto y alcance opcional de
llms.txt—RS-001. - Google Search Central, contenido útil — RS-002.
- Google Search Central, guía para funciones de IA en Search — RS-004.
- Google Search Central, SEO Starter Guide — RS-005.
- OpenAI, FAQ para publishers y developers — RS-009.
Servicio relacionado
Si esto es lo que te está pasando, posicionamiento en ia es el trabajo que lo resuelve. Diagnóstico primero, prioridades después.
Escrito por
Jesús Iturbide
Consultor SEO técnico · SEONIDAS
Diagnóstico, priorización e implementación SEO en WordPress y PrestaShop. Servicio prestado íntegramente en línea desde Villava, Navarra.
jesusiturbide.comHablemos
¿Tu web tiene un problema de rastreo, indexación o rendimiento que nadie te explica? Cuéntamelo: te respondo en 24 horas laborables con una primera lectura del caso.
Abrir consultaEn esta página
- Respuesta breve
- Puntos clave
- Definición operativa
- Relación con robots y sitemap
- Cuándo puede ser útil
- Qué contenido incluir
- Qué debe quedar fuera
- Implementación segura en WordPress
- Validación y mantenimiento
- Cómo medir sin atribuir de más
- En cuatro láminas
- Errores frecuentes
- Preguntas habituales
- Conclusión
- Próximo paso
- Fuentes