SEO técnico
Análisis de logs: qué rastrea Googlebot y qué ignora
Publicado el
En esta página
- Respuesta breve
- Puntos clave
- Qué registra un log y qué no
- Conseguir los logs
- Verificar que Googlebot es Googlebot
- Preguntas que solo responde un log
- Agrupar por plantilla y directorio
- Códigos de estado y peticiones desperdiciadas
- Los otros rastreadores
- Logs y protección de datos
- En cuatro láminas
- Errores frecuentes
- Próximo paso
- Fuentes
Respuesta breve
El log del servidor registra cada petición que llega: fecha, IP, URL, código de respuesta, tamaño y agente de usuario. Es la única fuente que dice qué visitó Googlebot de verdad, con qué frecuencia y qué respuesta recibió, sin depender de muestreos ni de informes agregados. Sirve para detectar zonas que nunca se rastrean, URLs que consumen peticiones sin aportar nada y errores que ninguna herramienta externa ve. Antes de analizar hay que verificar que el rastreador era quien decía ser.
Puntos clave
- El agente de usuario se falsifica en un segundo: sin verificar, tu análisis mide bots ajenos.
- Google documenta dos métodos de verificación: DNS inverso y contraste con sus rangos de IP publicados.
- El log responde preguntas que Search Console no responde: frecuencia por URL, orden de descubrimiento, respuesta exacta servida.
- Agrupar por plantilla y por directorio convierte millones de líneas en decisiones.
- Una IP es un dato personal: la retención y el tratamiento entran en el RGPD.
- El log dice qué se pidió, no qué se indexó ni por qué.
El análisis, en el orden en que no engaña
- Conseguir los logsCon los campos mínimos y sin URLs con datos personales.
- Verificar el agenteDNS inverso o rangos de IP publicados por Google.
- AgruparPor plantilla y por directorio: millones de líneas en decisiones.
- Leer respuestasCódigos de estado y peticiones que no aportan nada.
- DecidirEl log dice qué se pidió, no qué se indexó ni por qué.
Índice
- Qué registra un log y qué no
- Conseguir los logs
- Verificar que Googlebot es Googlebot
- Preguntas que solo responde un log
- Agrupar por plantilla y directorio
- Códigos de estado y peticiones desperdiciadas
- Los otros rastreadores
- Logs y protección de datos
- Errores frecuentes
- Próximo paso
Qué registra un log y qué no
Una línea de log en formato combinado contiene la IP de origen, la marca temporal, el método y la ruta solicitada, el código de estado devuelto, los bytes enviados, el referente y el agente de usuario. Muchos servidores permiten añadir el tiempo de respuesta, y ese campo convierte el fichero en una herramienta de rendimiento además de rastreo.
Lo que no está en el log conviene tenerlo presente desde el principio:
- No hay contenido. Sabes que se pidió una URL y qué código respondió; no sabes qué HTML se sirvió ni si llevaba
noindex. - No hay renderizado. Verás la petición del HTML y, si acaso, la de algunos recursos; no verás qué ejecutó el navegador de Google después.
- No hay indexación. Una URL rastreada mil veces puede no estar indexada. Son fases distintas, y confundirlas es el error de partida más caro; la separación entre rastreo e indexación es lo primero que hay que tener claro.
- No hay intención. El log no dice por qué Google pidió una URL, solo que la pidió.
Con ese perímetro claro, el log deja de prometer respuestas que no puede dar y empieza a ser útil para las que sí.
Conseguir los logs
La primera dificultad suele ser el acceso. Los escenarios habituales:
| Escenario | Dónde están | Problema típico |
|---|---|---|
| Hosting compartido | Registros de acceso del panel, a veces rotados a diario | Retención corta; hay que descargar antes de que se borren |
| Servidor propio | Directorio de logs del servidor web | Rotación y compresión; volumen en disco |
| CDN o proxy delante | Panel del CDN | El origen ve la IP del proxy, no la del rastreador |
| Balanceador | Log del balanceador o cabecera reenviada | Sin cabecera de IP real, todas las peticiones parecen internas |
El caso del CDN es el que más análisis arruina en silencio: si toda la caché se sirve en el borde, el log del origen solo contiene lo que falló en caché, y las conclusiones sobre frecuencia de rastreo serán falsas. Comprueba de dónde procede el fichero antes de sacar conclusiones.
Un mes de datos suele bastar para ver patrones; siete días son suficientes para detectar un problema agudo. Lo importante es que el periodo sea continuo y no coincida con una migración, un despliegue o una caída, porque entonces mides el incidente y no el comportamiento normal.
Verificar que Googlebot es Googlebot
El agente de usuario es texto libre que cualquiera puede escribir. Una parte no despreciable de las peticiones que se anuncian como Googlebot no lo son: raspadores, herramientas de análisis y tráfico malicioso que se disfrazan para evitar bloqueos. Analizar sin filtrar produce cifras infladas y decisiones equivocadas.
Google documenta dos métodos válidos:
- DNS inverso y directo. Resuelve la IP a un nombre de host; debe pertenecer a los dominios de Google. Después resuelve ese nombre de vuelta a una IP y comprueba que coincide con la original. Un solo paso no basta.
- Contraste con los rangos publicados. Google publica listas de rangos de IP en ficheros JSON, separados por tipo de rastreador. Es el método adecuado para procesar volúmenes grandes, porque no exige una consulta DNS por línea.
En la práctica: resuelve las IP únicas —que son muy pocas comparadas con el número de líneas—, marca cada una como verificada o no, y aplica la etiqueta al conjunto. Guarda el resultado de la verificación junto a los datos: dentro de seis meses no recordarás qué se filtró.
Preguntas que solo responde un log
Estas son las preguntas que justifican el trabajo, porque ninguna otra fuente las contesta con precisión:
- ¿Qué porcentaje de las URLs publicadas ha recibido al menos una visita del rastreador en el periodo?
- ¿Hay secciones enteras del sitio que nunca aparecen en el log?
- ¿Qué URLs concentran más peticiones y merecen esa atención?
- ¿Cuánto tarda una URL nueva en recibir su primera visita desde que se publica y se enlaza?
- ¿Qué proporción de las peticiones acaba en redirección o en error?
- ¿Se rastrean URLs con parámetros, filtros o resultados de búsqueda interna que no deberían existir?
- ¿El tiempo de respuesta del servidor empeora en las franjas de más rastreo?
La última pregunta suele ser la más rentable y la que menos se hace. Si el servidor se degrada cuando el rastreo se intensifica, el problema no es de SEO sino de capacidad, y se manifiesta también en los usuarios.
Cruzar el log con la lista de URLs del sitemap y con un rastreo propio da el mapa completo: publicadas y rastreadas, publicadas y nunca rastreadas, rastreadas y no publicadas. El tercer grupo —URLs que reciben peticiones y no están en ninguna lista tuya— es donde aparecen los restos de migraciones y las URLs generadas por error.
Agrupar por plantilla y directorio
Una lista de URLs ordenada por número de peticiones no es un análisis: es un ranking sin acción asociada. El paso que convierte el fichero en decisiones es clasificar cada URL en un tipo.
La clasificación se hace con patrones de ruta: portada, categoría, artículo, ficha, archivo, paginación, filtro, búsqueda interna, recurso estático. Con esa columna añadida, las preguntas cambian de escala: qué porcentaje del rastreo se lleva la paginación, si las fichas nuevas reciben menos atención que las antiguas, si los filtros consumen más peticiones que las categorías que deberían concentrarlas.
Ahí es donde el análisis produce trabajo concreto. Si la paginación profunda absorbe una parte desproporcionada de las peticiones, la conversación es de arquitectura y de enlazado interno, no de directivas, y entra de lleno en cuándo el presupuesto de rastreo importa de verdad.
Una lista de URLs ordenada por número de peticiones no es un análisis: es un ranking sin acción asociada.
Códigos de estado y peticiones desperdiciadas
La distribución de códigos por tipo de URL es el resumen más denso que puede sacarse de un log.
- 200 mayoritario es lo esperado. Si no lo es, hay algo estructural roto.
- 301 y 302 en volumen alto indican cadenas de redirección o enlaces internos que apuntan a la URL antigua. Cada salto es una petición que no sirve contenido.
- 404 no son un problema en sí; sí lo es que se concentren en un patrón, porque significa que algo los está generando o enlazando.
- 5xx es la prioridad absoluta. Un error de servidor durante el rastreo hace que Google reduzca el ritmo, y esa reducción tarda en recuperarse.
- 304 indica que la validación de caché funciona: contenido no modificado, respuesta barata.
Una comprobación que rara vez se hace y suele dar resultado: mirar qué se sirve realmente en las URLs que el buscador visita con más frecuencia y que tú considerabas irrelevantes. Cuando una web no aparece en resultados, el log a menudo muestra el motivo antes que cualquier herramienta; el diagnóstico por capas de indexación gana precisión con esta evidencia delante.
Los otros rastreadores
Googlebot no es un único agente. Google documenta rastreadores separados para móvil, escritorio, imágenes, vídeo y noticias, además de agentes específicos para la herramienta de inspección y para otros productos. Distinguirlos importa: un pico atribuido al rastreo de contenido puede ser en realidad el de imágenes.
Y fuera de Google hay un ecosistema creciente de rastreadores de sistemas de IA, con reglas propias y con la misma facilidad para ser suplantados. Si el objetivo del análisis incluye entender ese tráfico, la matriz de crawlers de IA cubre la identificación y las decisiones de bloqueo, que no son las mismas que para un buscador.
Logs y protección de datos
Una dirección IP es un dato personal cuando permite identificar indirectamente a una persona. Un log de acceso completo contiene IPs de usuarios reales junto a las de los rastreadores, y eso lo sitúa bajo el RGPD.
Medidas razonables y proporcionadas para un análisis de rastreo:
- Filtra las peticiones de bots verificados y trabaja solo con ese subconjunto: no necesitas el tráfico humano para este análisis.
- Si necesitas el conjunto completo, anonimiza o cifra las IPs de usuarios antes de exportar.
- Define un plazo de conservación y cúmplelo; guardar logs indefinidamente sin finalidad declarada no es defendible.
- No subas ficheros de log sin tratar a servicios de terceros sin comprobar dónde se almacenan y bajo qué condiciones.
- Deja constancia del tratamiento en el registro de actividades si la organización lo mantiene.
En cuatro láminas
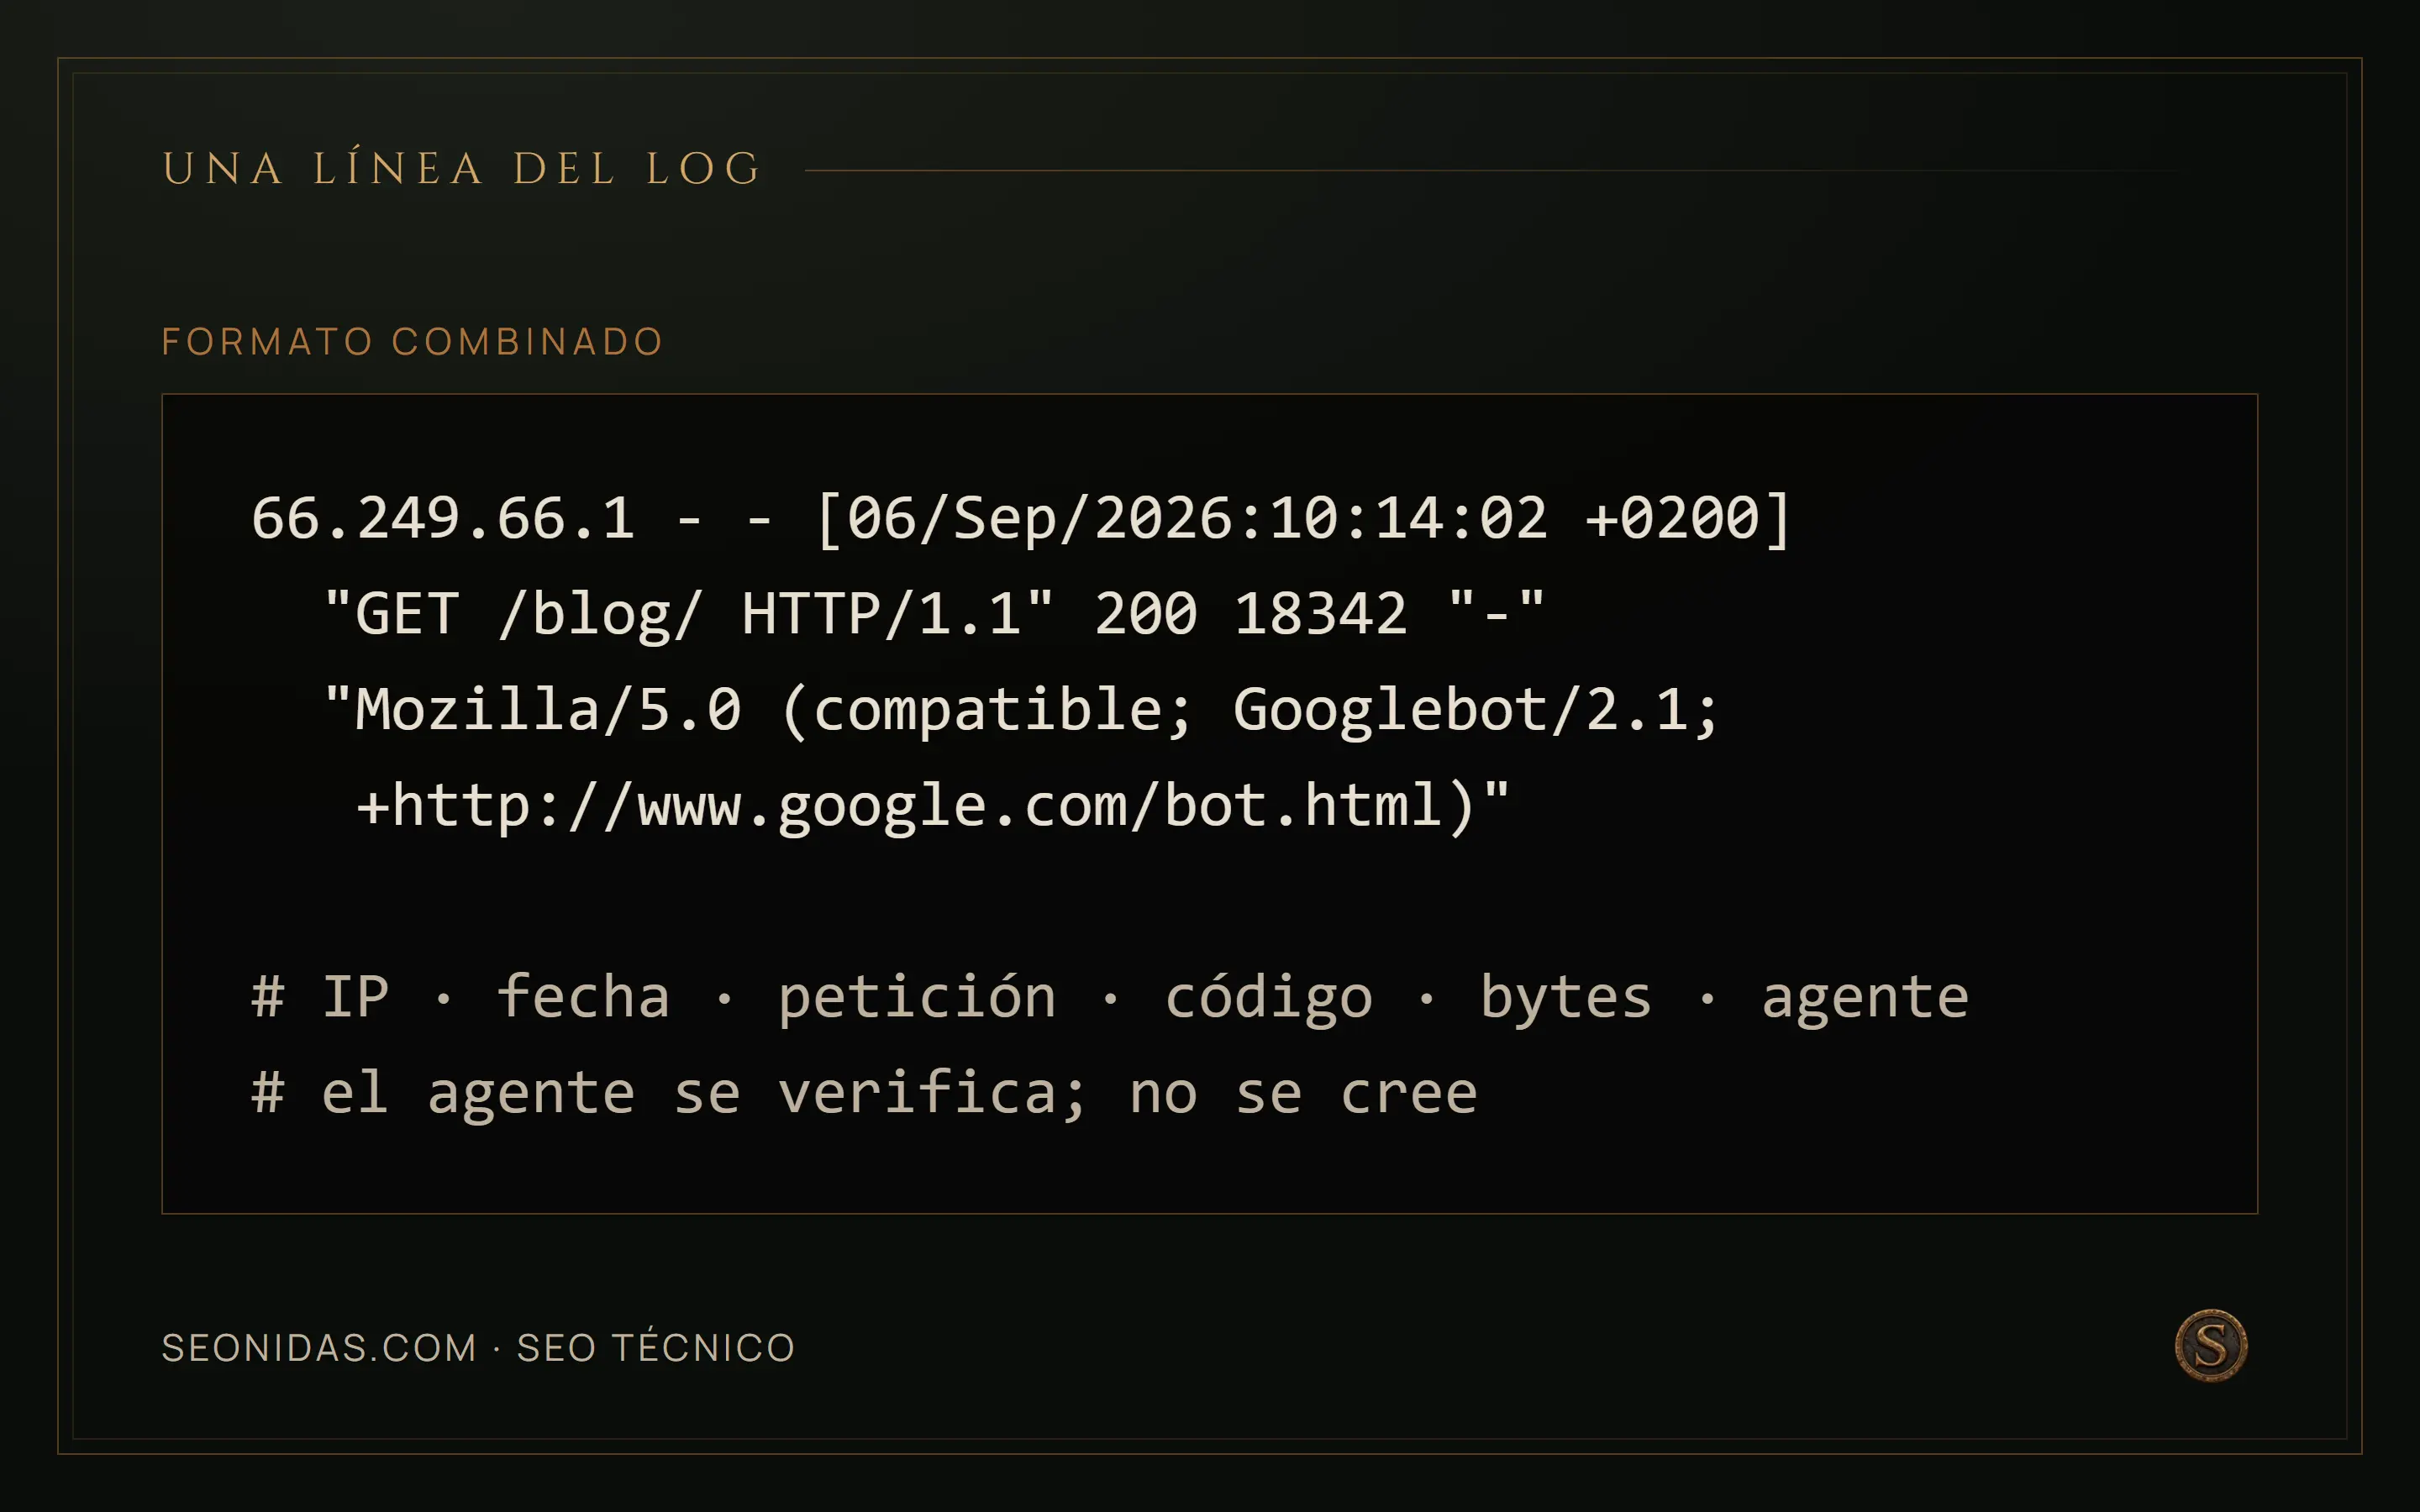
formato combinado: 66.249.66.1 - - [06/Sep/2026:10:14:02 +0200] / "GET /blog/ HTTP/1.1" 200 18342 "-" / "Mozilla/5.0 (compatible; Googlebot/2.1; / +http://www.google.com/bot.html)" / / # IP · fecha · petición · código · bytes · agente / # el agente se verifica; no se cree
2 métodos documentados. DNS inverso y contraste con los rangos de IP que Google publica. Sin uno de los dos, el análisis mide bots ajenos.
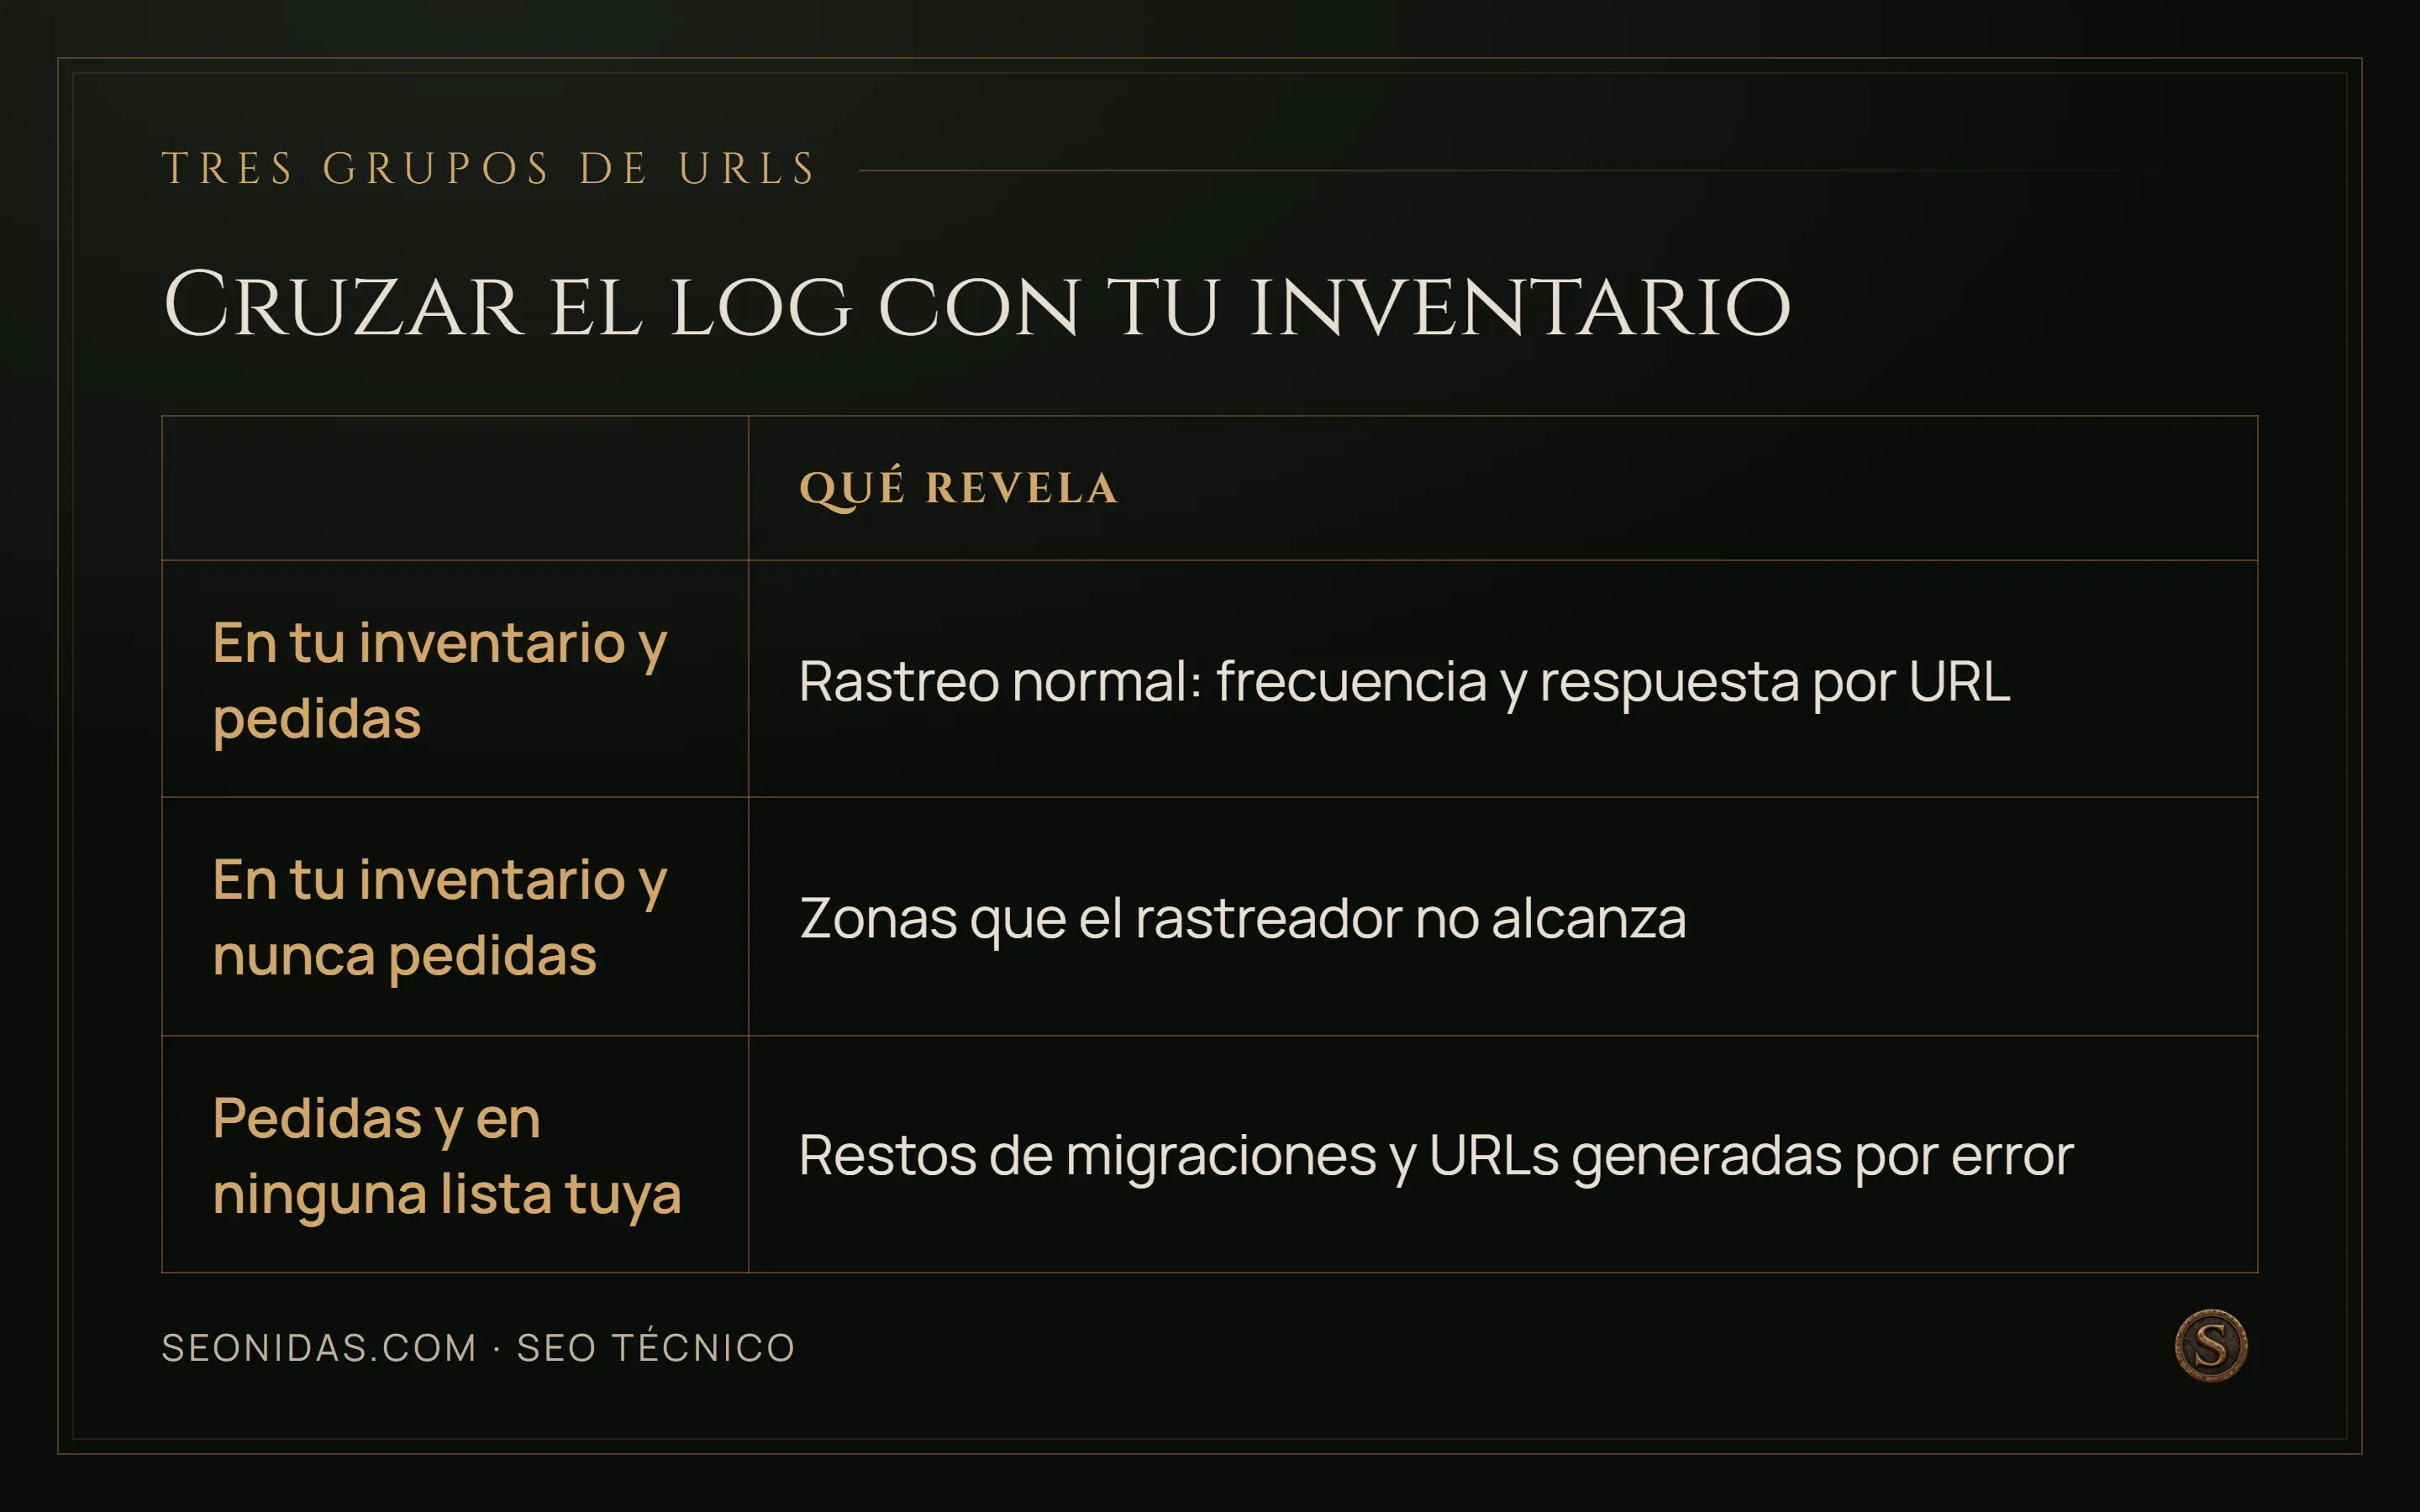
Cruzar el log con tu inventario. Columnas: Qué revela. En tu inventario y pedidas: Qué revela → Rastreo normal: frecuencia y respuesta por URL. En tu inventario y nunca pedidas: Qué revela → Zonas que el rastreador no alcanza. Pedidas y en ninguna lista tuya: Qué revela → Restos de migraciones y URLs generadas por error
Errores frecuentes
- Contar como Googlebot todo lo que se anuncia como Googlebot.
- Analizar el log del origen cuando hay un CDN sirviendo la mayor parte del tráfico.
- Elegir un periodo que coincide con una migración o una caída.
- Presentar una lista de URLs por volumen sin clasificarlas por plantilla.
- Concluir que una URL rastreada está indexada.
- Ignorar los 5xx porque el porcentaje total parece pequeño.
- Mezclar peticiones de recursos estáticos con las de documentos HTML en la misma métrica.
- Sacar conclusiones de tres días de datos.
- Exportar logs con IPs de usuarios a una herramienta externa sin evaluar el tratamiento.
Próximo paso
Descarga treinta días continuos de log, verifica las IPs únicas contra los métodos documentados por Google y quédate solo con el tráfico confirmado. Añade una columna de tipo de plantilla por patrón de ruta y saca dos tablas: peticiones y códigos de estado por tipo, y lista de URLs publicadas sin ninguna visita. Esas dos tablas ya contienen el trabajo de las próximas semanas.
Fuentes
- Google Search Central, verificar que una petición procede de Google — documentación oficial.
- Google Search Central, rastreadores y fetchers de Google — listado de agentes.
- Google Search Central, gestión del presupuesto de rastreo en sitios grandes — guía.
- OpenAI, rastreadores y agentes declarados — documentación.
Servicio relacionado
Si esto es lo que te está pasando, seo técnico es el trabajo que lo resuelve. Diagnóstico primero, prioridades después.
Escrito por
Jesús Iturbide
Consultor SEO técnico · SEONIDAS
Diagnóstico, priorización e implementación SEO en WordPress y PrestaShop. Servicio prestado íntegramente en línea desde Villava, Navarra.
jesusiturbide.comHablemos
¿Tu web tiene un problema de rastreo, indexación o rendimiento que nadie te explica? Cuéntamelo: te respondo en 24 horas laborables con una primera lectura del caso.
Abrir consulta