SEO técnico
Paginación y scroll infinito: cómo no perder páginas por el camino
Publicado el
En esta página
- Respuesta breve
- Puntos clave
- Por qué la paginación es un problema de descubrimiento
- Las tres implementaciones y sus consecuencias
- Qué hace que un enlace sea rastreable
- Qué etiquetas corresponden a cada página
- Una página para verlo todo
- Paginación en catálogos con filtros
- Cómo verificarlo
- En cuatro láminas
- Errores frecuentes
- Preguntas habituales
- Próximo paso
- Fuentes
Respuesta breve
El SEO de una serie paginada se juega en algo simple: cada página necesita su propia URL y un enlace HTML que lleve hasta ella. El scroll infinito no es incompatible con eso, pero lo es la implementación que carga resultados sin cambiar la dirección ni ofrecer enlaces alternativos: entonces todo lo que hay más allá de la primera pantalla queda fuera de alcance. La regla práctica es que el contenido debe seguir siendo accesible con JavaScript desactivado.
Puntos clave
- Cada página de la serie necesita una URL propia, estable y enlazada con un
<a href>. - Canonicalizar todas las páginas hacia la primera esconde el contenido de las siguientes.
- El scroll infinito funciona si se apoya en URLs paginadas reales por debajo.
- Un botón de cargar más sin enlace equivalente deja el catálogo sin ruta de descubrimiento.
- Las fichas deben ser alcanzables por otra vía además de la serie paginada.
- La comprobación decisiva es el HTML inicial, no lo que se ve en el navegador.
Las tres implementaciones y lo que descubren
Paginación con enlaces
Cada página con URL propia, estable y un enlace hacia ella: todo se descubre.
Scroll infinito con URLs debajo
Funciona si se apoya en páginas reales enlazadas; el desplazamiento solo las recorre.
Botón de cargar más sin enlace
Lo que hay tras la primera pantalla queda fuera de alcance.
Por qué la paginación es un problema de descubrimiento
La paginación no se diseña para posicionar la página cinco de una categoría, sino para que exista un camino hasta los elementos que contiene. En un catálogo o un archivo grande, las URLs profundas dependen casi por completo de esa ruta: si la serie se interrumpe, lo que está detrás deja de tener enlaces internos y se convierte en contenido huérfano.
El efecto no es inmediato ni evidente. Las fichas ya conocidas siguen funcionando durante un tiempo, y por eso el fallo se atribuye después a otras causas. Lo que cambia es la capacidad de descubrir lo nuevo y de revisitar lo antiguo, que es justamente lo que sostiene un catálogo vivo.
Por eso la primera pregunta no es qué etiquetas poner, sino qué otras rutas existen hacia esos elementos. Una arquitectura que solo ofrece la serie paginada como camino es frágil por diseño; el criterio para construir esas rutas alternativas está en el artículo sobre enlazado interno.
La paginación no se diseña para posicionar la página cinco de una categoría, sino para que exista un camino hasta los elementos que contiene.
Las tres implementaciones y sus consecuencias
Google describe en su guía de paginación y carga incremental los patrones habituales y qué necesita cada uno para funcionar. La diferencia entre ellos no es estética: cambia lo que un rastreador puede alcanzar.
| Patrón | URL por página | Enlace rastreable | Riesgo |
|---|---|---|---|
| Paginación clásica | sí | sí | bajo, si las URLs son estables |
| Scroll infinito con URLs paginadas | sí | sí, si hay enlaces reales | medio, depende de la implementación |
| Scroll infinito sin URL | no | no | alto, el contenido queda inalcanzable |
| Botón de cargar más con enlace | sí | sí | bajo |
| Botón de cargar más sin enlace | no | no | alto |
El patrón recomendable combina las dos cosas: la interfaz carga resultados sin recargar la página, y por debajo existe una serie de URLs paginadas que se pueden solicitar directamente y que están enlazadas en el HTML. La experiencia del usuario no cambia y la ruta de descubrimiento se mantiene.
Qué hace que un enlace sea rastreable
Un enlace se sigue cuando es un elemento <a> con un atributo href que apunta a una URL. Los sustitutos habituales no cumplen esa condición, aunque funcionen perfectamente al hacer clic.
- un
<button>que dispara una petición no es un enlace; - un
<div>con un manejador de eventos tampoco lo es; - un
<a>sinhref, o conhref="#", no aporta destino; - una ruta construida solo en JavaScript al hacer clic no existe hasta que alguien la pulsa;
- un enlace generado tras una interacción del usuario no está presente en la carga inicial.
La consecuencia es que la interfaz puede funcionar bien para las personas y dejar sin salida a los rastreadores. La prueba que resuelve la duda es directa: solicita el HTML de la primera página sin ejecutar scripts y comprueba si aparecen enlaces a la segunda. Si no aparecen, la serie no existe desde fuera del navegador, con independencia de lo que muestre la pantalla.
Qué etiquetas corresponden a cada página
El error más extendido consiste en apuntar el canonical de todas las páginas de la serie hacia la primera. La intención es evitar duplicidad, pero el efecto es declarar que la versión preferida es una página que no contiene los elementos de las demás. La serie deja de tener sentido y los elementos profundos pierden su referencia.
Cada página de la serie es una URL distinta con contenido distinto, y su canonical debe apuntar a sí misma. La revisión de casos en el artículo sobre errores de canonical desarrolla este escenario junto con otros donde la etiqueta se usa como si fuera una herramienta de limpieza.
- canonical autorreferencial en cada página de la serie;
- sin
noindexen las páginas siguientes salvo decisión razonada y documentada; - títulos y descripciones que reflejen la posición en la serie, sin repetir el mismo texto;
- URLs de paginación estables, con un parámetro o segmento constante;
- enlaces a primera y última página además de a la anterior y la siguiente en series largas;
- orden de resultados determinista, para que la página tres contenga lo mismo en dos peticiones seguidas.
Ese último punto se pasa por alto y explica incoherencias difíciles de reproducir. Si el orden por defecto cambia con cada consulta, o si depende de disponibilidad en tiempo real, la misma URL devuelve conjuntos distintos y los elementos aparecen y desaparecen de la serie sin patrón aparente.
Una página para verlo todo
Cuando el número de elementos lo permite, una página que muestre la colección completa puede sustituir a la serie. Es una opción razonable en catálogos pequeños o archivos acotados, y simplifica el problema: hay una URL, un canonical y ningún camino que se pueda romper.
Deja de ser razonable cuando el resultado es una página que tarda en cargar, consume memoria en el móvil o exige descargar cientos de imágenes. En ese caso la solución empeora la experiencia y el rendimiento, con efecto sobre las métricas que se miden en el artículo sobre Core Web Vitals en WordPress. El criterio es el peso real de la página, medido, no la comodidad de la implementación.
Paginación en catálogos con filtros
Cuando la serie paginada convive con filtros, las combinaciones se multiplican. Una categoría con varios filtros y varias páginas genera un espacio de URLs que crece rápido y que incluye resultados vacíos o casi idénticos.
La decisión sensata separa dos planos. Por un lado, la serie paginada de la categoría base, que debe ser rastreable y completa. Por otro, las combinaciones de filtros, que en su mayoría no necesitan ser indexables y se gobiernan desde la navegación que las genera. Mezclar ambos planos produce dos fallos simultáneos: se bloquea la serie legítima y se dejan abiertas combinaciones sin valor.
Conviene además vigilar el comportamiento de las páginas vacías. Una serie que sigue ofreciendo enlaces a páginas sin resultados, o que devuelve 200 en una página inexistente, genera URLs sin contenido que se acumulan con el tiempo. Una página fuera de rango debería responder con un 404 o redirigir a la última válida, no mostrar una cuadrícula vacía.
Cómo verificarlo
La verificación no consiste en navegar por la web, porque el navegador ejecuta todo lo que haga falta y siempre parece correcto. Consiste en reproducir las condiciones de un rastreador.
- solicita el HTML de la primera página sin ejecutar JavaScript y busca los enlaces de paginación;
- pide directamente la URL de la página dos y comprueba que devuelve 200 y contenido distinto;
- repite la petición para confirmar que el orden es estable;
- rastrea el sitio con la ejecución de scripts desactivada y mide cuántas fichas se alcanzan;
- repite el rastreo con ejecución activada y compara ambos totales;
- revisa el canonical de una muestra de páginas intermedias;
- comprueba qué devuelve una página fuera de rango;
- contrasta el número de URLs alcanzadas con las que declara el sitemap.
La diferencia entre los dos rastreos es el dato que resume el problema. Si con scripts se alcanzan todas las fichas y sin ellos solo las de la primera pantalla, el descubrimiento depende por completo de la ejecución, y esa dependencia es la que conviene eliminar.
En cuatro láminas

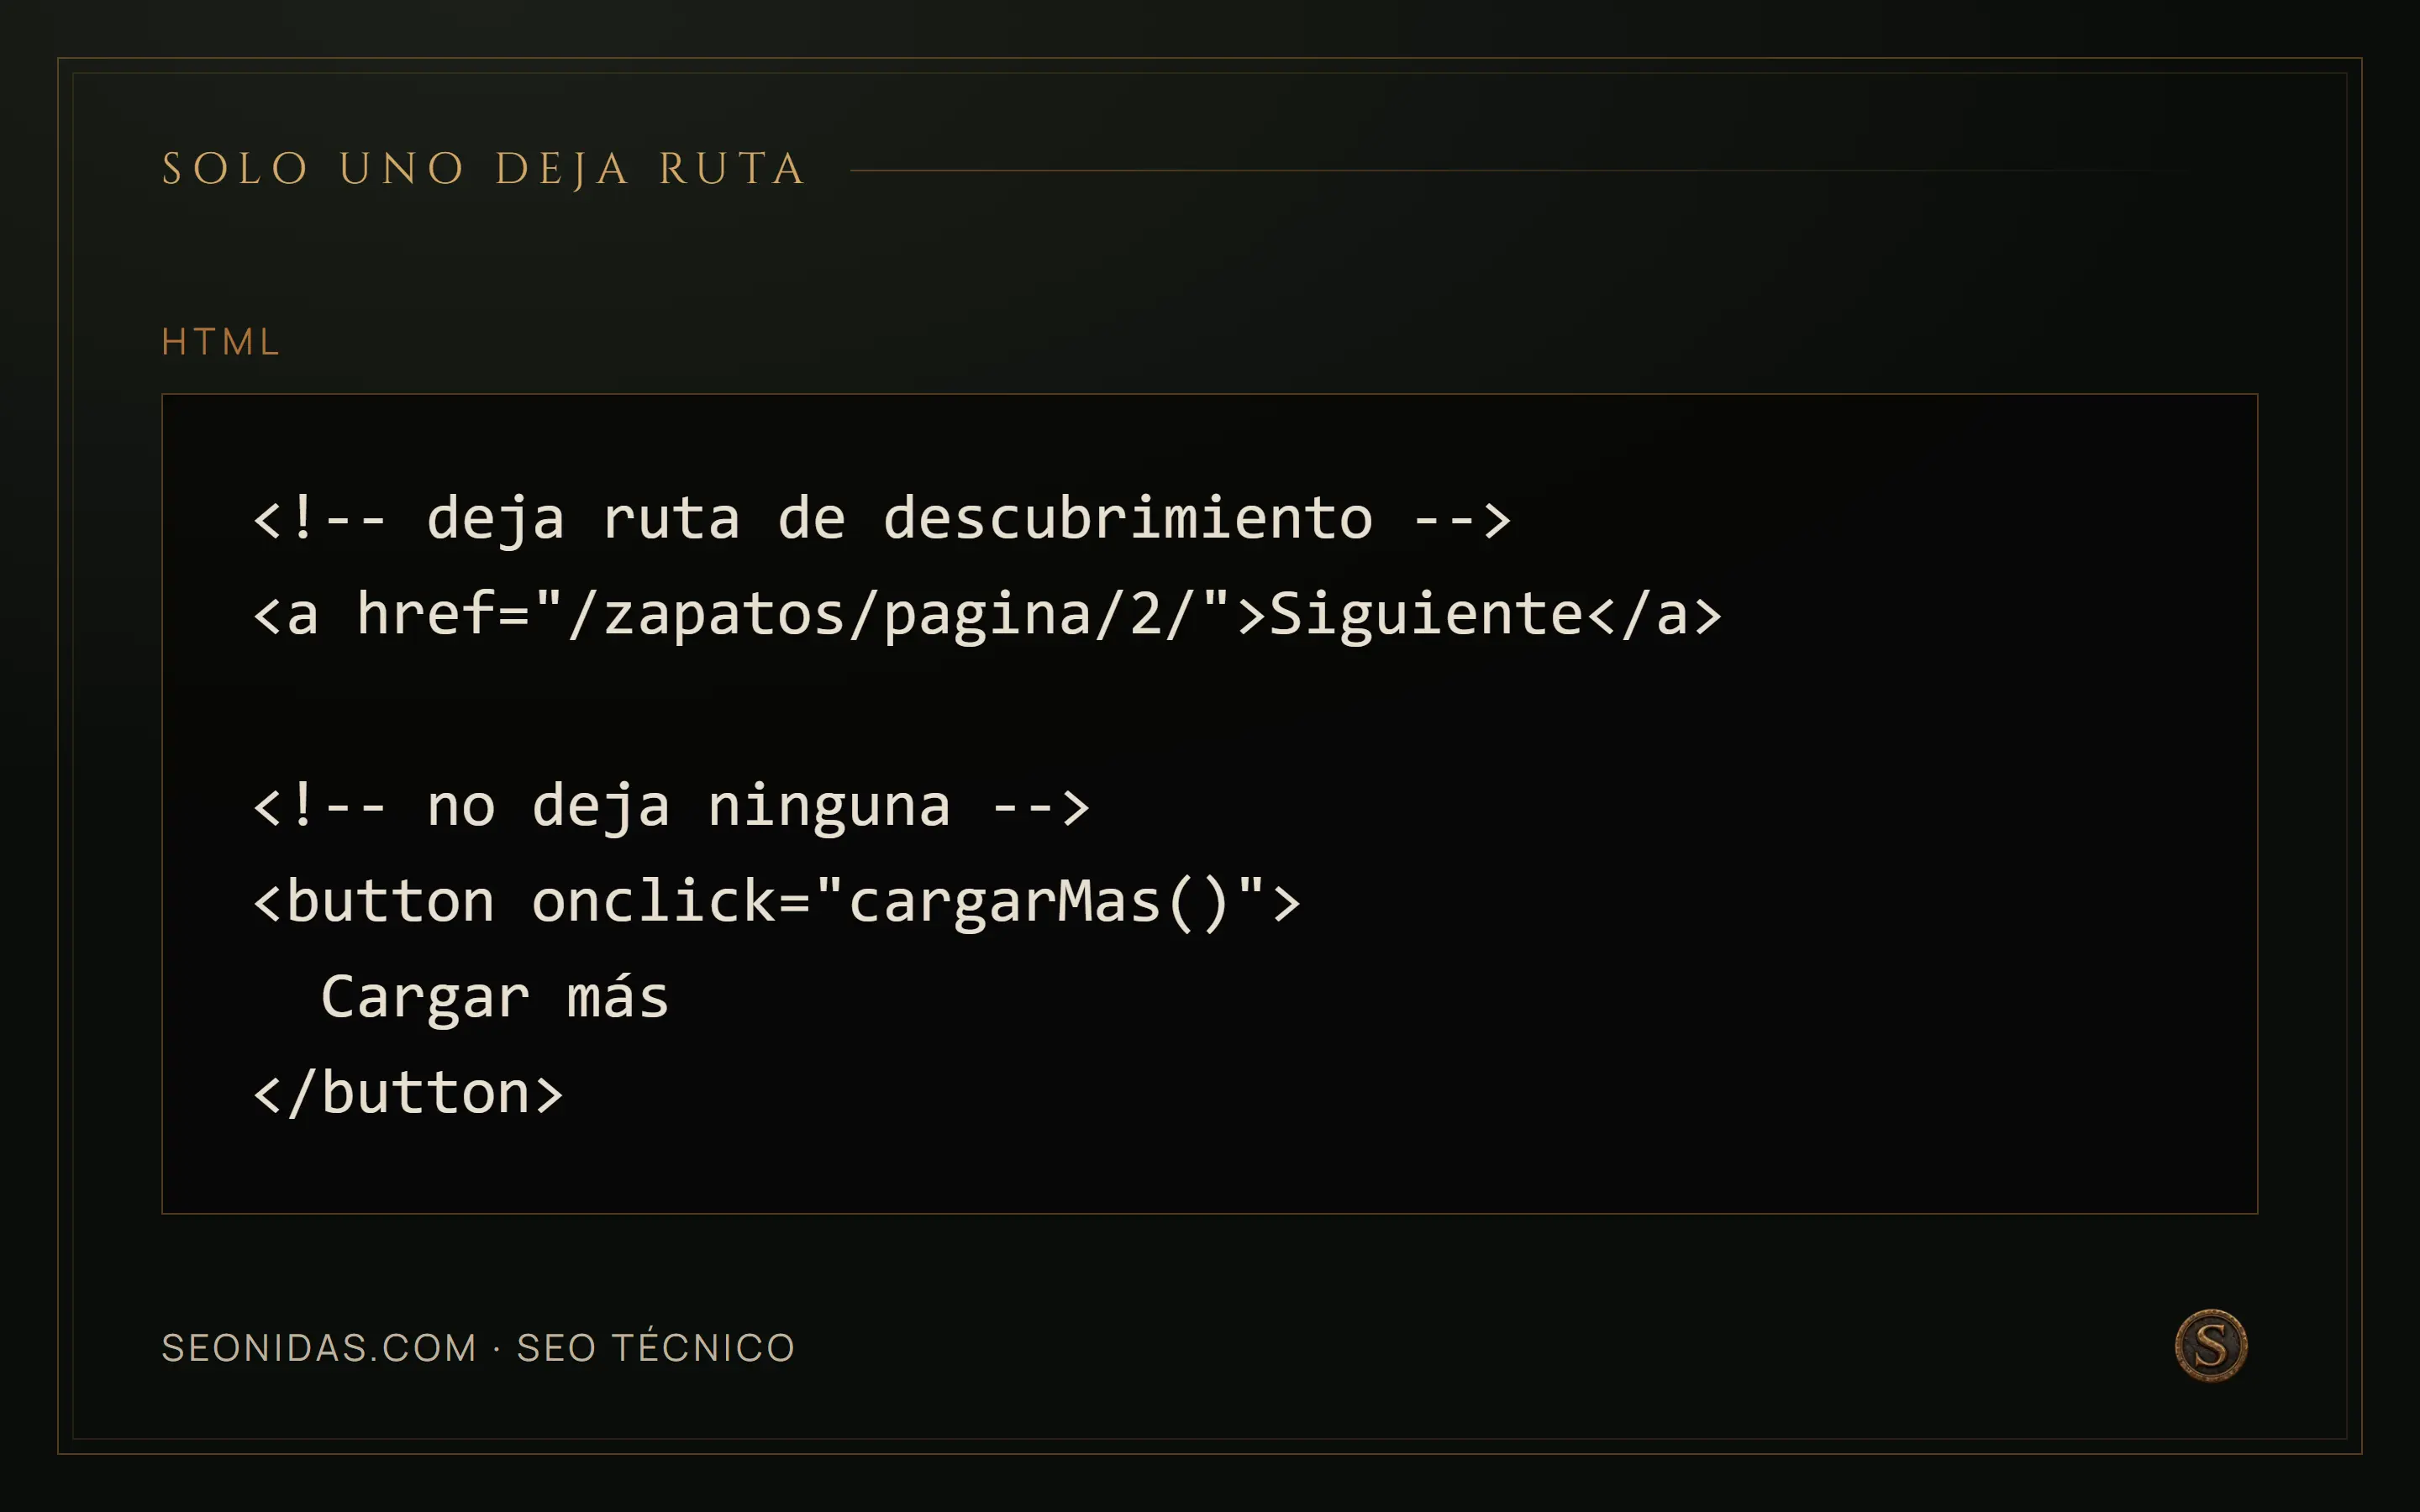
HTML: <!-- deja ruta de descubrimiento --> / <a href="/zapatos/pagina/2/">Siguiente</a> / / <!-- no deja ninguna --> / <button onclick="cargarMas()"> / Cargar más / </button>
1 URL por página de la serie. Propia, estable y enlazada con un a href. Cada página se canonicaliza a sí misma.
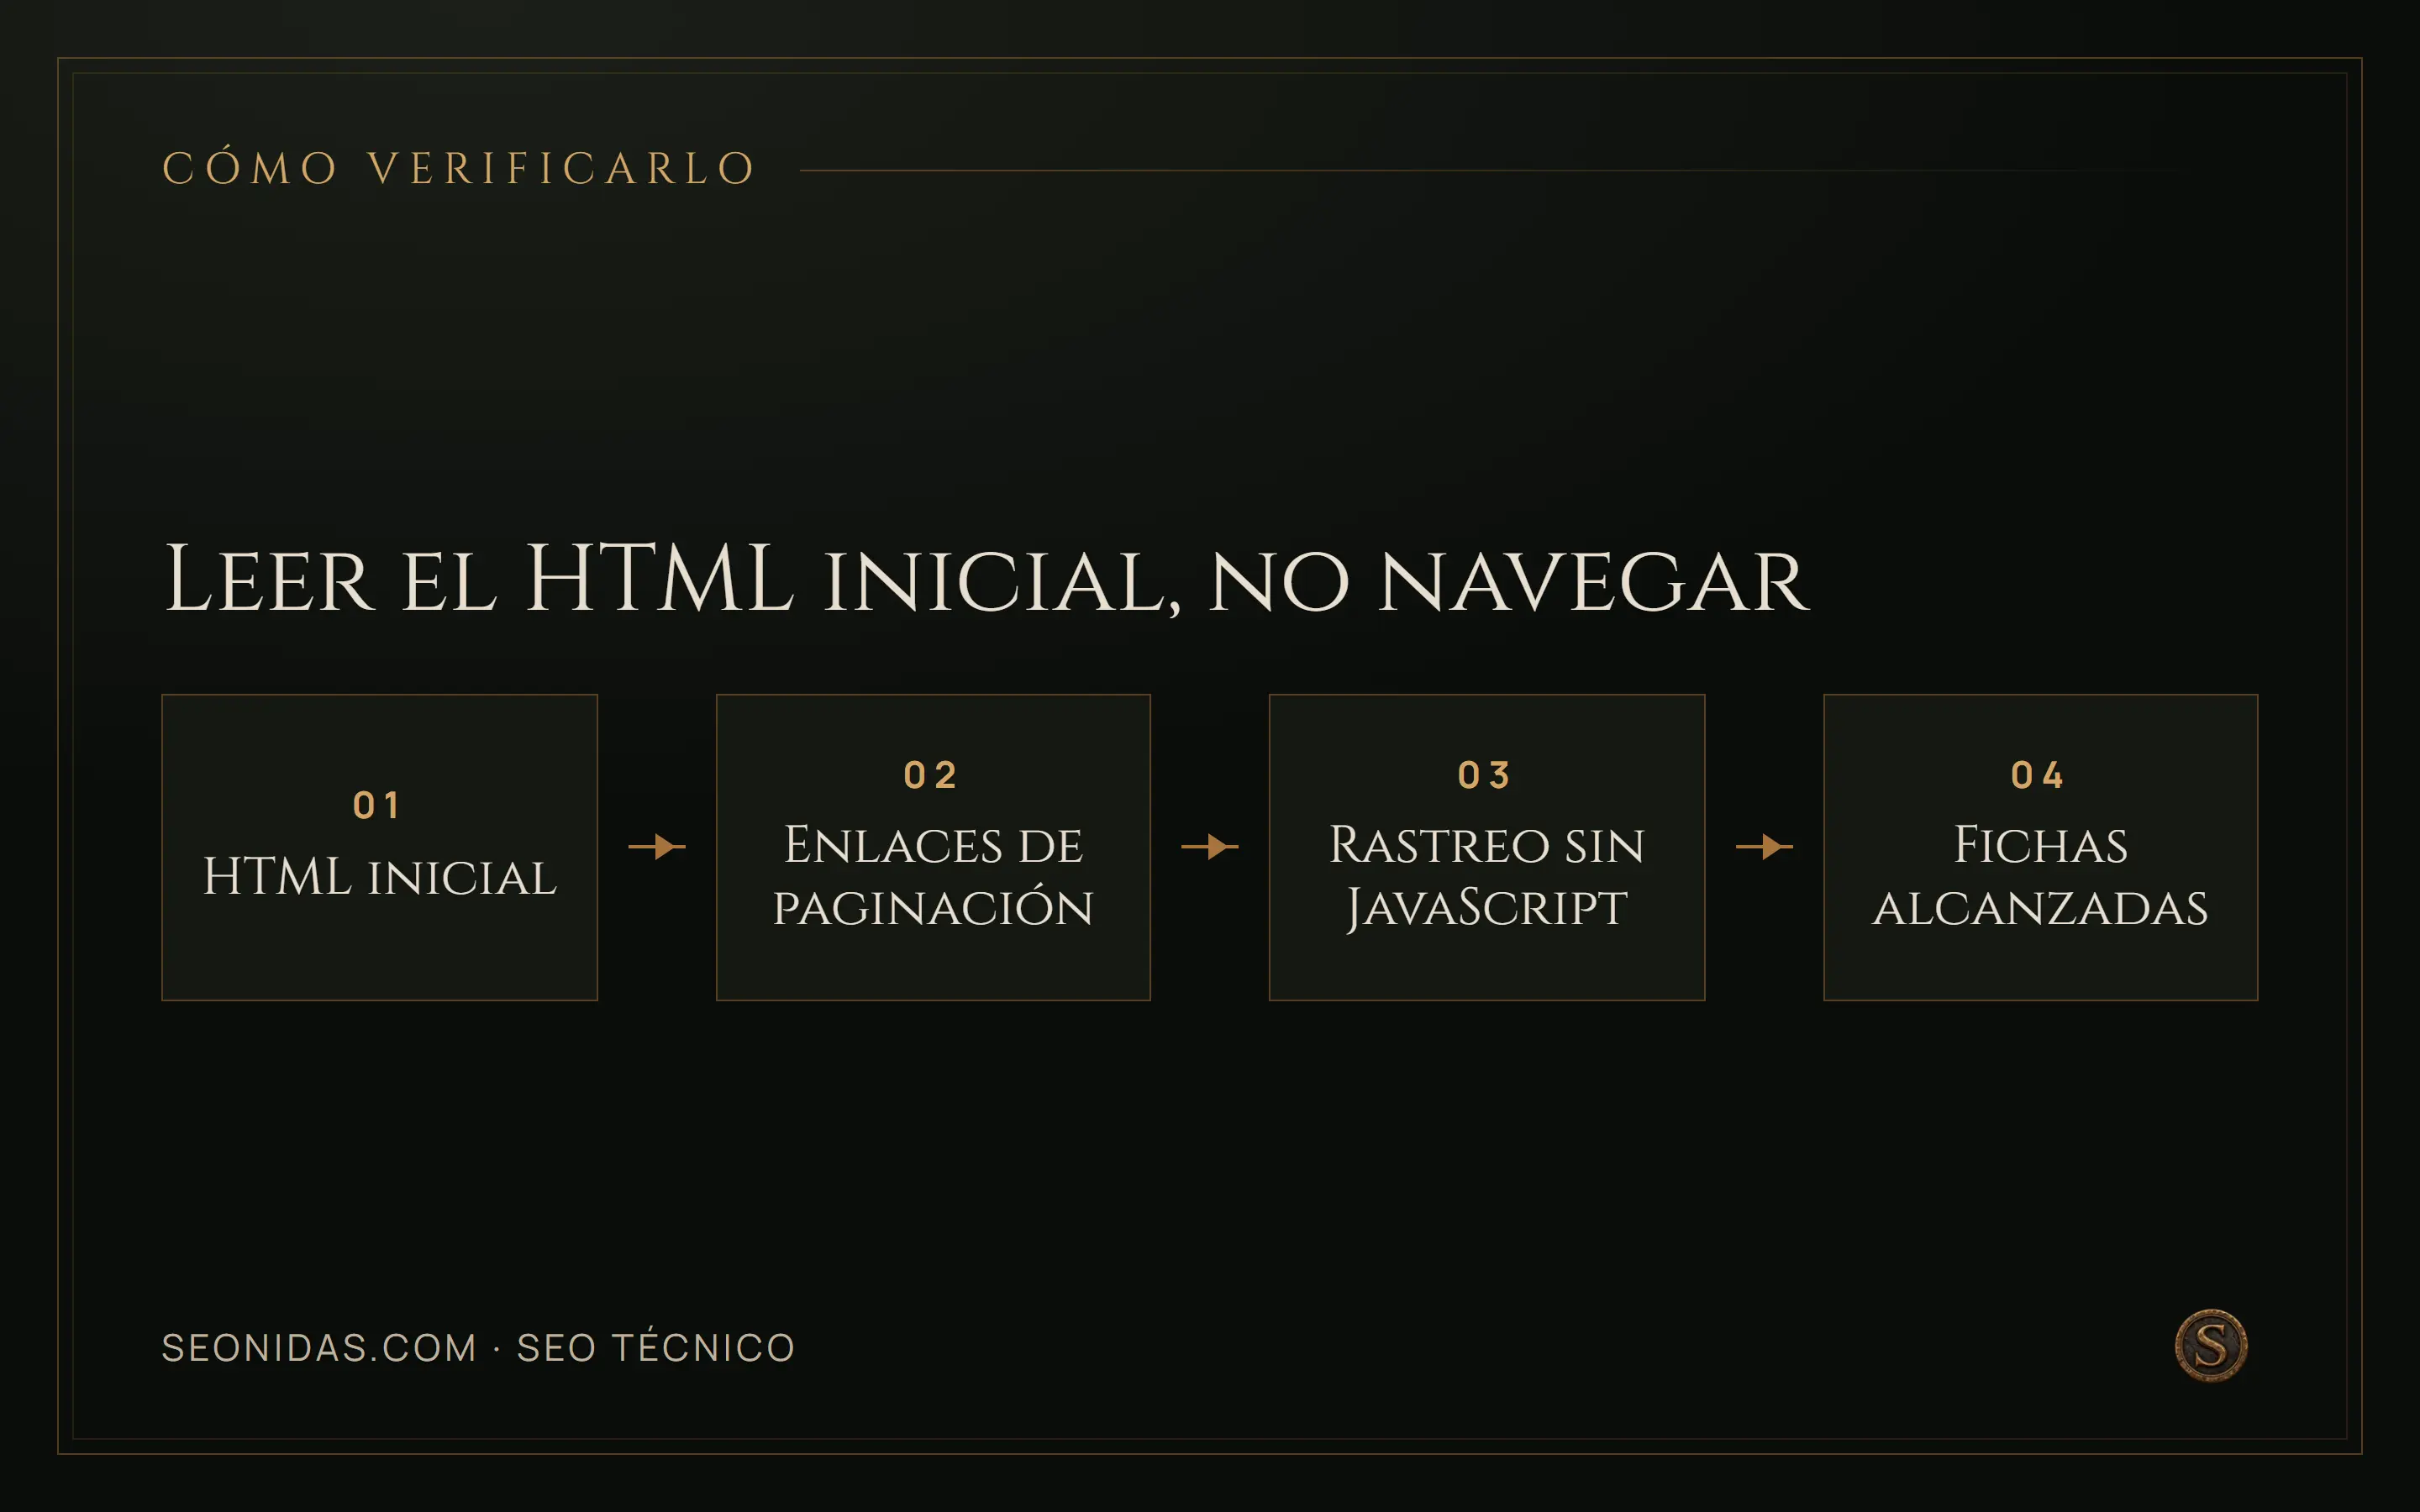
Leer el HTML inicial, no navegar: 1. HTML inicial → 2. Enlaces de paginación → 3. Rastreo sin JavaScript → 4. Fichas alcanzadas
Errores frecuentes
- Canonicalizar todas las páginas de la serie hacia la primera.
- Sustituir los enlaces de paginación por botones sin
href. - Implementar scroll infinito sin URLs paginadas por debajo.
- Poner
noindexa las páginas siguientes y cortar el camino hacia las fichas. - Bloquear las URLs de paginación en
robots.txtpara ahorrar rastreo. - Repetir el mismo title y la misma description en toda la serie.
- Cambiar el orden por defecto y hacer que la página tres varíe en cada petición.
- Devolver 200 con una cuadrícula vacía en páginas fuera de rango.
- Depender solo de la serie paginada como ruta hacia las fichas.
- Validar la implementación navegando en lugar de leer el HTML inicial.
Preguntas habituales
¿El scroll infinito es malo para el SEO?
No lo es por sí mismo; lo es la implementación que carga resultados sin cambiar la dirección ni ofrecer enlaces alternativos. Funciona bien cuando por debajo existen URLs paginadas reales, con su enlace, y el desplazamiento solo es la forma de recorrerlas. Lo que queda fuera de alcance es lo que solo aparece tras interactuar.
¿Debo canonicalizar todas las páginas hacia la primera?
No: esconde el contenido de las siguientes. Cada página de la serie es un documento distinto con fichas distintas, y declarar que todas son la primera equivale a decir que ese contenido no existe. Cada página se canonicaliza a sí misma, con su propio title y su propia description.
¿Puedo poner noindex a las páginas 2, 3 y siguientes?
Se puede, pero conviene entender qué se corta: si esas páginas son la única ruta hacia las fichas, el noindex deja el catálogo sin camino de descubrimiento. Antes de aplicarlo hay que garantizar que las fichas son alcanzables por otra vía —categorías, sitemap, enlazado interno— y comprobarlo, no suponerlo.
¿Cómo compruebo que la paginación se descubre de verdad?
Leyendo el HTML inicial, no navegando. En el navegador todo funciona porque el JavaScript ya se ha ejecutado; lo que decide el descubrimiento es si en la respuesta del servidor hay un <a href> hacia la página siguiente. Un botón sin href se ve igual y no aporta ninguna ruta.
Próximo paso
Rastrea una categoría profunda dos veces, con y sin ejecución de JavaScript, y compara cuántas fichas alcanza cada pasada. Si la diferencia es grande, el problema no está en las etiquetas sino en la ausencia de enlaces reales, y ahí es donde hay que intervenir antes de tocar canonical o indexación. Esa doble pasada es también la prueba base cuando se sospecha que Google no ve el contenido porque depende del renderizado.
Fuentes
- Google Search Central, fundamentos de SEO para JavaScript — documentación oficial.
- Google Search Central, consolidar URLs duplicadas — documentación oficial.
- Google Search Central, sitemaps — documentación oficial.
Servicio relacionado
Si esto es lo que te está pasando, seo técnico es el trabajo que lo resuelve. Diagnóstico primero, prioridades después.
Escrito por
Jesús Iturbide
Consultor SEO técnico · SEONIDAS
Diagnóstico, priorización e implementación SEO en WordPress y PrestaShop. Servicio prestado íntegramente en línea desde Villava, Navarra.
jesusiturbide.comHablemos
¿Tu web tiene un problema de rastreo, indexación o rendimiento que nadie te explica? Cuéntamelo: te respondo en 24 horas laborables con una primera lectura del caso.
Abrir consulta